

AIのmisconfigurationと従来のクラウドmisconfigurationの違い
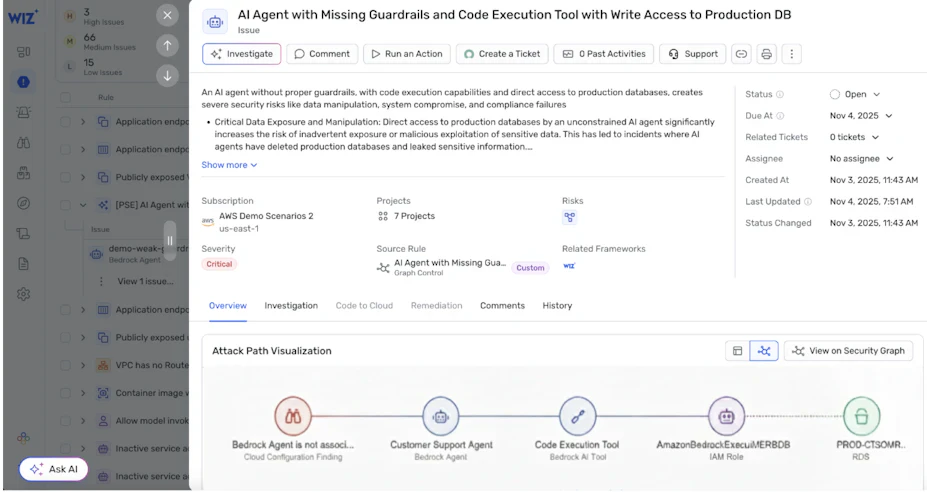
AIのmisconfigurationとは、AIシステムの構成におけるセキュリティ上のミスです。AIインフラ、model、サービスに不適切な設定、過剰な権限、安全でないデフォルト設定が残っていると、組織がリスクにさらされます。
従来のクラウドのmisconfigurationは、主にコンピューティング、ストレージ、ネットワークのresourceに影響します。たとえば、公開状態のS3バケット、設定に不備のあるセキュリティグループ、パブリックにアクセスできるデータベースなどです。AIのmisconfigurationは、こうしたresourceの上に構築されるAI固有のコンポーネントに関わるため、複雑さがさらに増します。
AIならではの要素は次のとおりです。
training datasetのdatastore:modelの学習元となるdatasetを保管する場所で、機密情報を含むことが少なくありません。
modelレジストリ:trainingを終えたmodelやartifactを保管する場所で、重要な知的財産にあたります。
inferenceエンドポイント:modelがリクエストを受け取り、予測結果を返すAPIです。
機械学習(ML)のpipelines:データの準備からmodelのtraining、デプロイまでの流れを自動化する仕組みです。
AIサービスは、AWS IAM(アイデンティティとアクセス管理)のロール、Azure RBAC、GCPのサービスアカウントといった、従来と同じクラウドのアイデンティティ基盤の上で動作します。一方で、APIキー、サービスtoken、サービス間の権限など、新しい認証情報のパターンも加わります。こうした認証情報の権限範囲が広すぎたり、有効期間が長すぎたり、管理が不十分だったりすると、AIシステムやそれが扱うデータへの影響の大きいアクセス経路になりかねません。
AI workloadは頻繁に変化します。チームはmodelの再training、promptの更新、新しいinference pipelinesの立ち上げを絶えず繰り返しています。こうしたスピード感により、時間の経過とともにconfiguration driftが発生する可能性が高まります。
AIサービスにmisconfigurationがある場合、さらされるのはインフラだけではありません。AIの振る舞いや知識を決める独自のmodel、アルゴリズム、training datasetまで露出するおそれがあります。
AIのmisconfigurationの主な種類
AIに関するセキュリティインシデントの多くは、高度なエクスプロイトや新しい攻撃手法から生じるわけではありません。原因の大半は基本的な設定ミスです。単体ではリスクが低く見えても、アイデンティティの権限、ネットワークのexposure、機密データへのアクセスと組み合わさることで危険なものになります。
公開されたAIエンドポイントとAIサービス
inferenceエンドポイントとは、入力を受け付けてmodelの予測結果を返すAPIです。強力なアクセス制御がないままパブリックインターネットに公開されていると、誰でもmodelを直接操作できてしまいます。
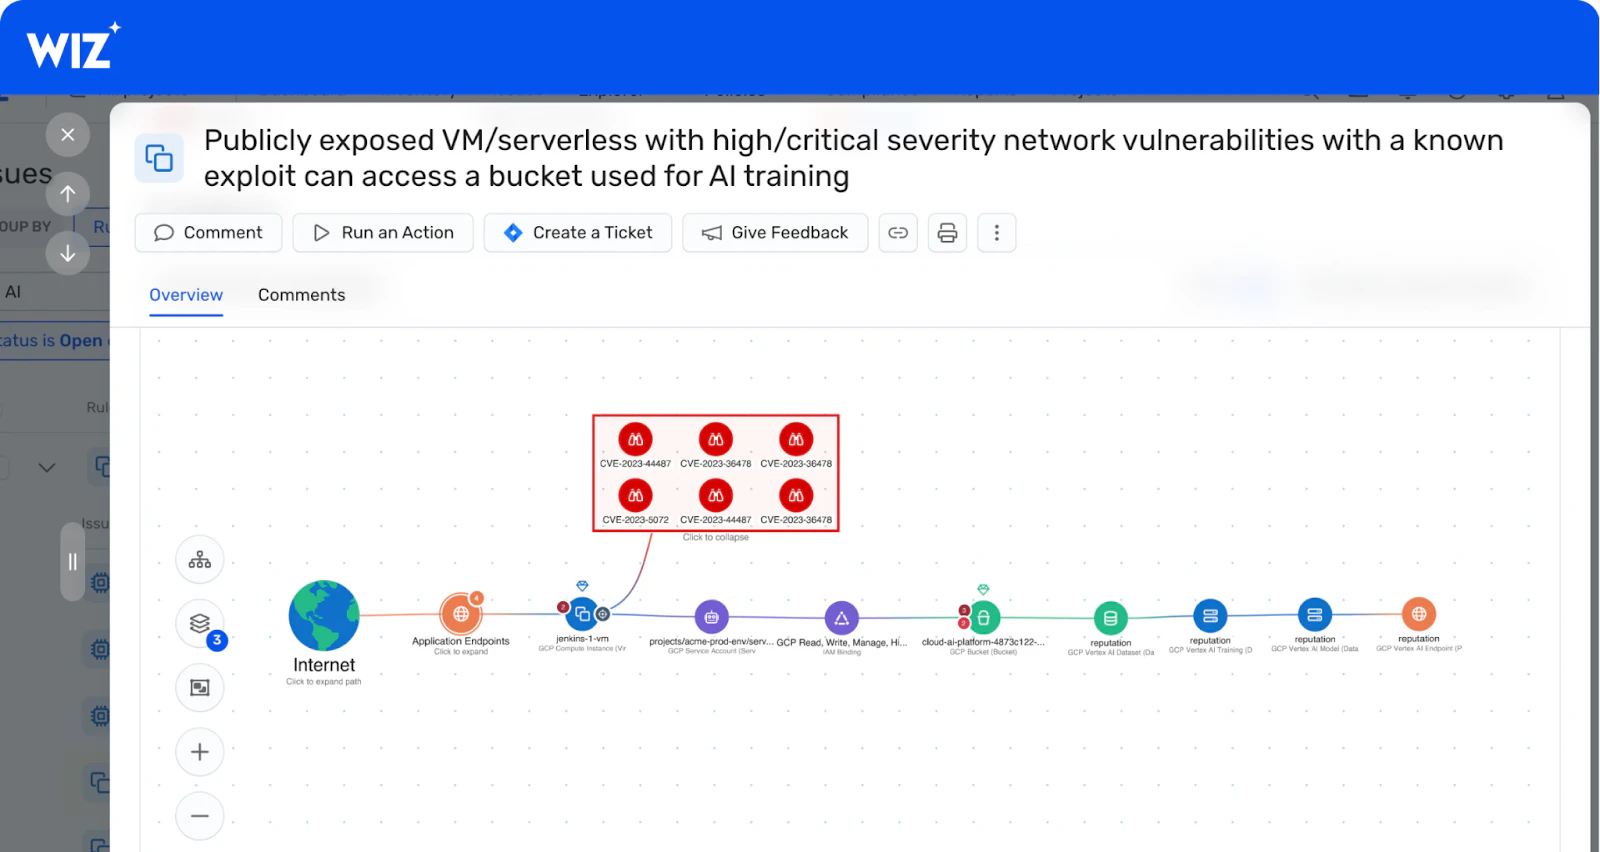
パブリックに到達可能なinferenceエンドポイントや開発環境には、十分なネットワーク制限や認証が欠けていることがよくあります。こうした状態はAIシステムへの容易な侵入口となり、権限のないユーザーがmodelに問い合わせたり、挙動を探ったり、機密情報の抽出を試みたりできてしまいます。
過剰な権限を持つAIサービスのアイデンティティ
すべてのAIサービスは、IAMロールやサービスアカウントなど、何らかのアイデンティティの下で動作します。そのアイデンティティに必要以上の権限が付与されていると、1つのworkloadが侵害されただけで、AIサービスそのものをはるかに超える範囲が露出します。
AI workloadはdatastore、特徴量のpipelines、その他のクラウドサービスと頻繁にやり取りするため、過剰な権限を持つアイデンティティはblast radiusを大きく広げます。AIサービスが悪用されると、攻撃者はそのアイデンティティに付与されたすべての権限を引き継ぐことになります。
安全でないtraining datasetとmodelストレージ
training datasetやmodel artifactには、独自の情報や機密情報が含まれていることが少なくありません。ストレージの構成で暗号化、アクセス制御、環境間の分離が不十分だと、これらのassetは価値の高い標的になります。
training datasetやfine-tuningしたmodelへのアクセスが適切に保護されていないと、知的財産、規制対象データ、AIシステムに組み込まれた社内のビジネスロジックが露出するおそれがあります。
不十分なログ記録とvisibility
多くのAIサービスは、包括的なログ記録や監視の仕組みがないままデプロイされています。AIサービスのアクティビティがクラウドネイティブのログ基盤で一貫して記録されていないと、セキュリティチームはmodel、エンドポイント、datasetへのアクセス状況についてのvisibilityを失います。
visibilityが限られていると、通常の利用と、misconfigurationや進行中の悪用とを見分けることが難しくなります。AIシステムが機密データを扱う場合や大規模に運用されている場合は、なおさらです。
脆弱な認証と認可
AI workloadは緩いsecurity controlsのまま実験として始まり、その設定が本番環境まで持ち越されることがよくあります。パブリックエンドポイント、共有の認証情報、有効期間の長いアクセスtokenが、初期開発の段階を過ぎても使われ続けるケースもあります。
AIサービス間で認証と認可の制御に一貫性がないと、攻撃者はそのすき間を突いて不正アクセスや権限昇格を狙えます。
安全でないmodelデプロイ構成
AIモデルをデプロイする際には、コンテナ、継続的インテグレーション/継続的デリバリー(CI/CD)のpipelines、APIゲートウェイ、オーケストレーションplatformなど、複数のレイヤーが関わります。どのレイヤーのmisconfigurationも、アイデンティティやネットワークの問題と組み合わさることで深刻なexposureにつながります。
model artifact、runtime環境、関連サービスの間の分離が不十分だと、AIシステムが気付かないうちにクラウド環境の広い範囲にさらされることがあります。
テナント間のリスクと分離のリスク
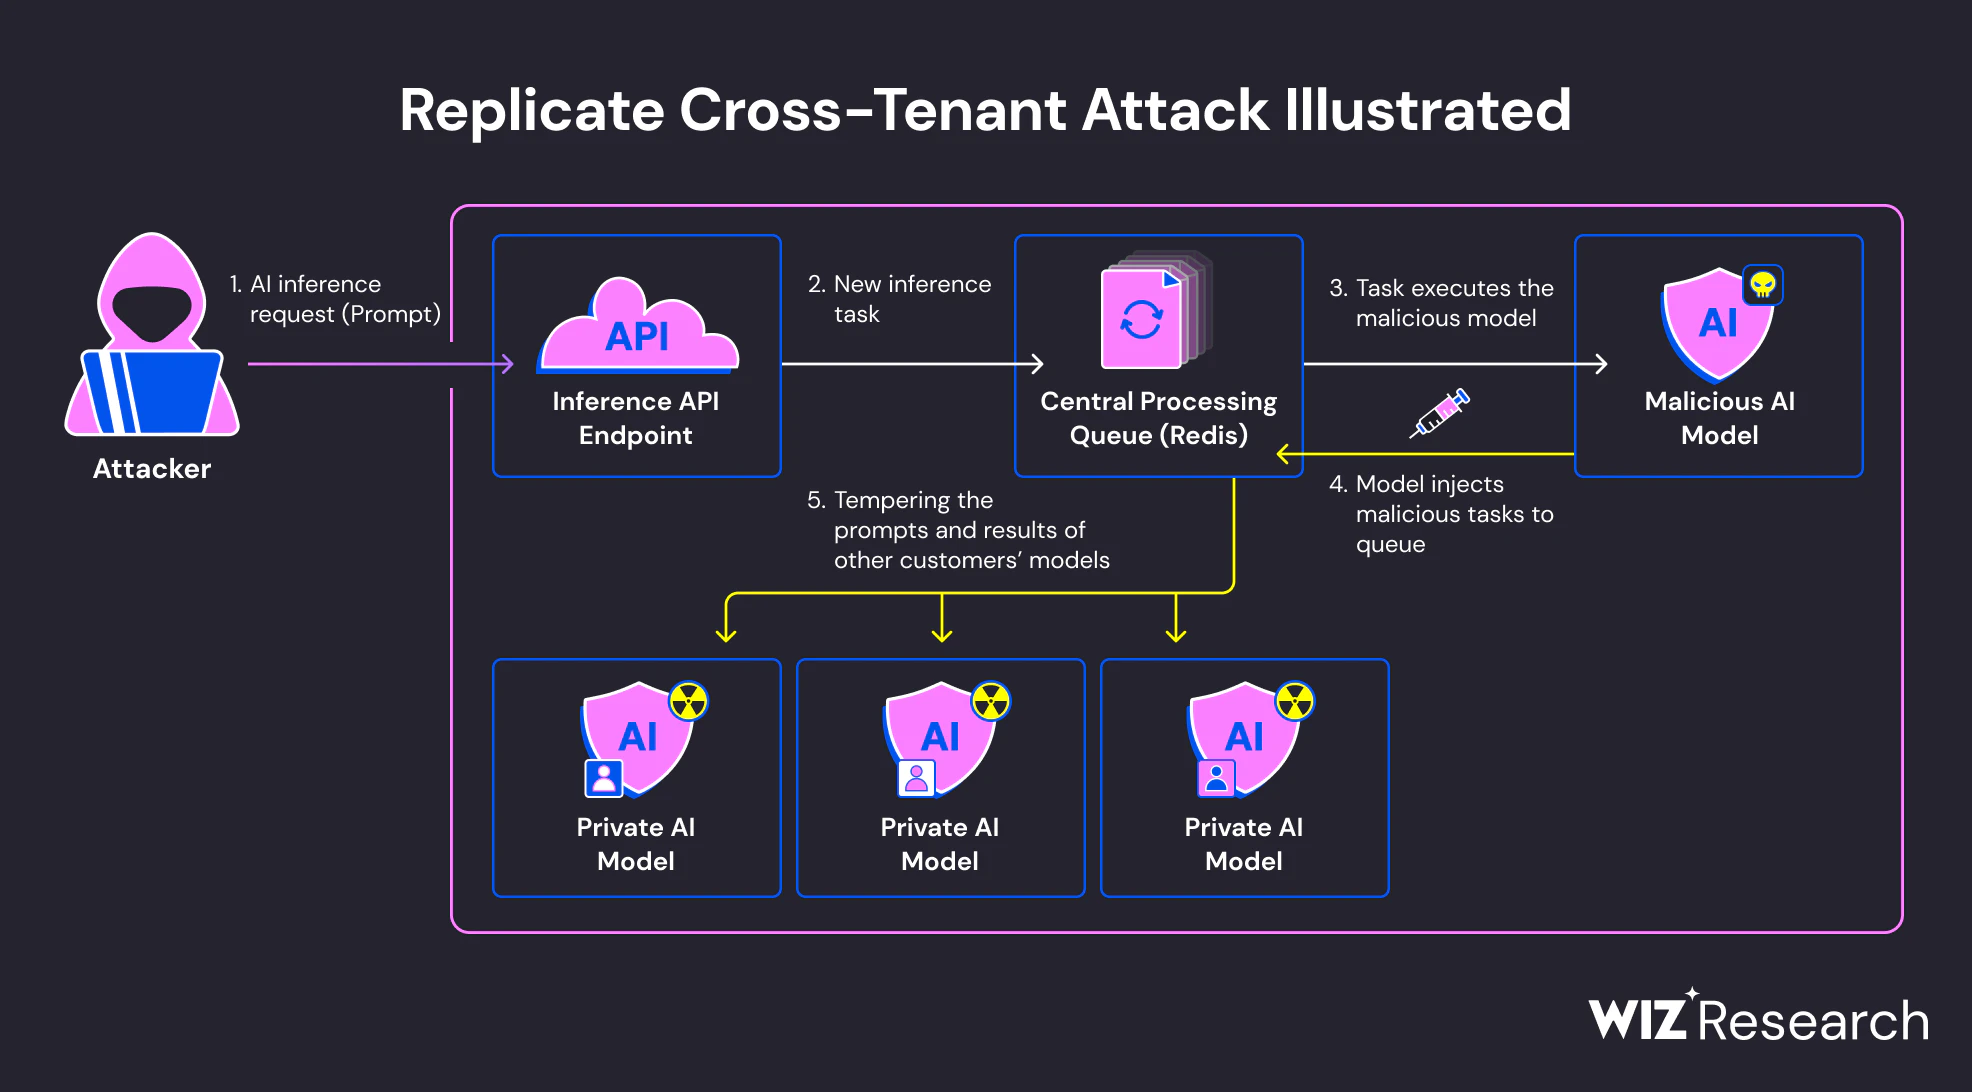
マネージドAI platformは共有のクラウドインフラ上で稼働しており、プロバイダーによる強固な分離が適用されています。プロバイダーレベルでテナントをまたいだ侵害が起きることはまれです。
分離に関するリスクの大半は、顧客側のmisconfigurationに起因します。たとえば、過度に緩いアクセス制御、公開されたネットワーク経路、プロジェクト・ワークスペース・環境間の不十分な分離などです。こうした問題は、社内チーム間や外部の関係者との間で想定外のアクセスを生む可能性があります。
AIのmisconfigurationが機密データへのattack pathを生む仕組み
attack pathとは、攻撃者が最初の弱点から価値の高い標的へと到達するまでに連なる一連の条件です。AIのmisconfigurationが単独でインシデントを引き起こすことはまれですが、こうした経路の重要なつなぎ目になることがよくあります。
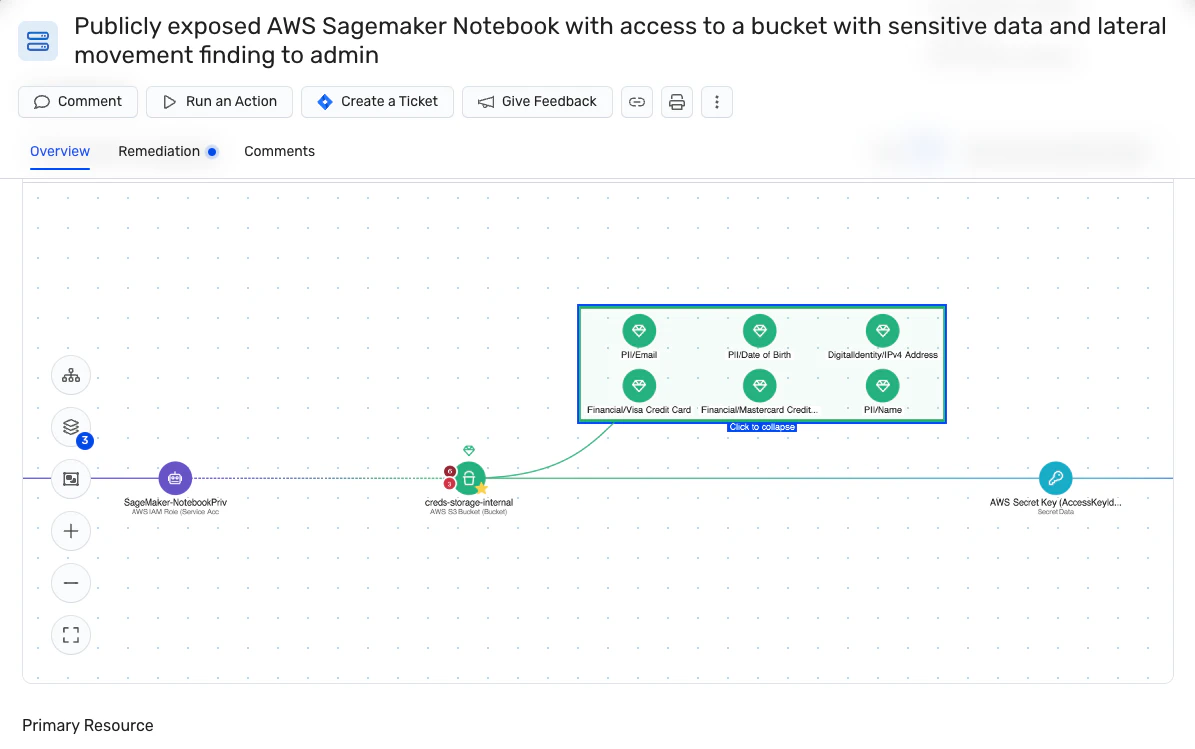
単発のインフラの問題とは異なり、AIのmisconfigurationはアイデンティティ、データアクセス、ネットワークのexposureと交わることが多くあります。これらの要素が重なると有害な組み合わせ(toxic combination)が生まれ、悪用の可能性と影響が大きく高まります。
有害な組み合わせが生まれる仕組み
AIのmisconfigurationは、まったく新しいリスクを持ち込むというより、既存のクラウドリスクを増幅させることが多くあります。代表的な組み合わせは次のとおりです。
公開されたエンドポイント+過剰な権限を持つサービスアイデンティティ:広い権限範囲のロールで動作するパブリックなinferenceエンドポイントは、modelが依存するdatastore、特徴量のpipelines、下流のサービスへの経路になりえます。
脆弱な認証+機密性の高いtraining dataset:共有の認証情報や管理の甘いアクセスtokenにより、顧客情報、独自情報、規制対象の情報を含むtraining datasetが露出するおそれがあります。
不十分なログ記録+大量のinferenceアクティビティ:ログが一貫して記録されていないと、異常なアクセスパターンや大規模なデータ抽出の試みが通常のAI利用に紛れてしまいます。
個々の問題はリスクが低く見えるかもしれません。しかし組み合わさると、機密データやAIのassetへの直接的な経路になりえます。
AIサービスを経由したlateral movement
AI workloadはストレージシステム、データのpipelines、その他のクラウドサービスと連携することが多いため、misconfigurationのあるAIサービスは攻撃者にとって格好の足がかりになります。
公開されたり悪用されたりしたAIエンドポイントが、training datasetや社内サービスにアクセスできるアイデンティティで動作していると、AIシステムの外側へのlateral movementが可能になります。この場合、攻撃者がmodelそのものを直接攻撃する必要はありません。設定に不備のあるアクセス経路そのものが侵入の道筋になるからです。
inferenceを通じた想定外のデータ露出
misconfigurationによって、AIの通常の運用の中で機密情報が漏えいすることもあります。
適切な制御がないままprompt、レスポンス、中間データをすべてログに記録するinferenceワークフローは、個人情報や機密情報を気付かないうちに保存してしまう場合があります。時間が経つにつれ、こうしたログは元のdatasetよりも保護が弱く、広くアクセスできる二次的なdatastoreになりかねません。
アクセス制御や監視が不十分な状態と重なると、このexposureは誰にも気付かれないまま続く可能性があります。
blast radiusの拡大
AIシステムは、複数のサービスをつなぐ役割を担うことがよくあります。過度に緩いサービスロールや公開されたエンドポイントなど、1つのmisconfigurationが次の範囲にわたってblast radiusを広げる可能性があります。
training datasetのリポジトリ
model artifactとmodelレジストリ
特徴量ストアと下流の分析システム
関連するクラウドサービスとAPI
AIパイプラインは開発、デプロイ、runtimeの各環境にまたがるため、ある段階の弱点がシステム全体に波及する可能性があります。
AIのmisconfigurationのリスク管理における課題
成熟したクラウドセキュリティチームであっても、AIのmisconfigurationを効果的に管理するのは容易ではありません。AI導入のスピードに加え、ownershipの分散やツールのvisibilityの限界があるため、AIセキュリティ態勢(AI Security Posture)は従来のクラウドインフラよりも維持が難しくなります。
security controlsを上回るAI導入のスピード:AIサービスは、security controlsの整備を上回るペースでデプロイされることがよくあります。新しい種類のmodel、マネージドサービス、ソフトウェア開発キット(SDK)、デプロイパターンが、組織として一貫したガードレールを確立する前に本番環境に到達します。その結果、AI workloadは実験段階のデフォルト設定や場当たり的なセキュリティ判断をそのまま引き継ぐことが多く、利用の拡大に伴ってmisconfigurationの可能性が高まります。
AI固有のresourceに対する限られたvisibility:従来のクラウドセキュリティツールの多くは仮想マシン、ネットワーク、ストレージを監視するために設計されており、modelレジストリ、trainingジョブ、promptの保存先、inference pipelinesといったAI固有のassetは対象外です。こうしたAIネイティブなコンポーネントへのvisibilityがなければ、セキュリティチームは公開されたエンドポイント、過剰な権限を持つアイデンティティ、AI workloadにつながる機密性の高いdatasetの存在に気付けない場合があります。チーム間で分散したownership:AIサービスのオーナーが1つに定まっていることはまれです。責任は多くの場合、次のように分かれています。
modelとノートブックを管理するデータサイエンスチーム
クラスター、pipelines、CI/CDを運用するplatformチーム
ポリシーを定義し、インシデントに対応するセキュリティチーム
shadow AIと管理されていないデプロイ:AIサービスは、正式なセキュリティワークフローの外で立ち上げられることがよくあります。チームはマネージドクラウドサービス、オープンソースのフレームワーク、サードパーティのAPIを使ってmodelをデプロイし、中央のinventoryに登録しないままにしている場合があります。こうしたshadow AIのデプロイは、標準的なアクセス制御、ログ記録、監視を経由しないAIサービスを生み、発見や評価を難しくすることでリスクを高めます。
contextを欠いたalert fatigue:「パブリックエンドポイント」や「脆弱な認証情報」といった生のセキュリティ検出結果は、AIサービスがどのデータにアクセスでき、他のシステムとどうつながっているかを把握しなければ意味を持ちません。AIのmisconfigurationに関するアラートがアイデンティティの権限、ネットワークのexposure、データの機密度と関連付けられていないと、チームはalert fatigueに陥り、実際にリスクのある問題を優先しにくくなります。
変化し続けるcomplianceとgovernanceの要件:新たに登場しているAI規制やAIガバナンスフレームワークは、透明性、アクセス制御、リスク管理に関する追加の要件を課しています。組織は既存のクラウド、データ保護、complianceの義務に加えてAI固有の管理策にも対応する必要があり、大規模なクラウド環境をすでに管理しているチームにとって複雑さが増しています。
AIのmisconfigurationにクラウドネイティブセキュリティのアプローチが必要な理由
AIは単独で存在しているわけではありません。すべてのmodel、pipelines、エンドポイントは、クラウドのコンピューティング、ネットワーク、アイデンティティ、データサービスの上で動いています。modelのコードやpromptだけを見ていても、AIを保護することはできません。
AIシステムはクラウドインフラ、アイデンティティ、データサービスに依存しています。modelエンドポイント自体が安全でも、その背後にあるサービスアイデンティティが機密性の高いdatastoreにアクセスできるなら、問題は解決していません。
リスクは、インフラ、データ、AIの各レイヤーに同時にまたがることがよくあります。本当のexposureがどこにあるかを理解するには、これらのレイヤーのつながりを把握する必要があります。
変化し続けるAI環境に、特定時点のレビューだけで追随するのは困難です。AI workloadの進化に合わせてセキュリティ態勢を維持するには、継続的な評価に加え、プライベートエンドポイント、ネットワーク分離(AWS VPC、Azure VNet、GCP VPC)、カスタマー管理の暗号化キー(CMEK)、least privilegeのIAMロールを組み合わせることが推奨されます。
クラウドresource全体にわたる継続的なvisibilityは、AIリスクの死角を減らすのに役立ちます。次のような問いに答えられる必要があります。
すべてのAIサービスとmodelエンドポイントはどこにありますか?
インターネットに公開されているのはどれですか?
機密性の高いdatastoreや高権限のロールに到達できるのはどれですか?
AIのasset、アイデンティティ、ネットワーク、データを横断的に結び付けるcontext重視のアプローチなら、個々の検出結果だけでなく有害な組み合わせまで把握できます。こうしたレイヤー横断のvisibilityにより、実際のattack pathを生むmisconfigurationと、リスクの小さい単発の問題を見分けられます。
このレイヤー横断のvisibilityを提供するために設計されているのが、クラウドネイティブアプリケーション保護プラットフォーム(CNAPP)やAI security posture management(AI-SPM)のツールです。
WizによるAIのmisconfigurationの特定と優先順位付け
AIのmisconfigurationは、突き詰めればAIシステムが関わるクラウドセキュリティの問題です。model、pipelines、inferenceエンドポイントはいずれも、クラウドインフラ、アイデンティティ、ネットワーク、データサービスに依存しています。そのため、AIのリスクを理解するには、AIのレイヤーだけでなくクラウド環境全体にわたるvisibilityが必要です。
AIセキュリティの観点からも、このvisibilityは欠かせません。AIシステムが機密データを露出させるか、不正アクセスを許すか、従来のsecurity controlsでは検知できないattack pathを生むかは、多くの場合クラウドレイヤーのmisconfigurationによって決まります。
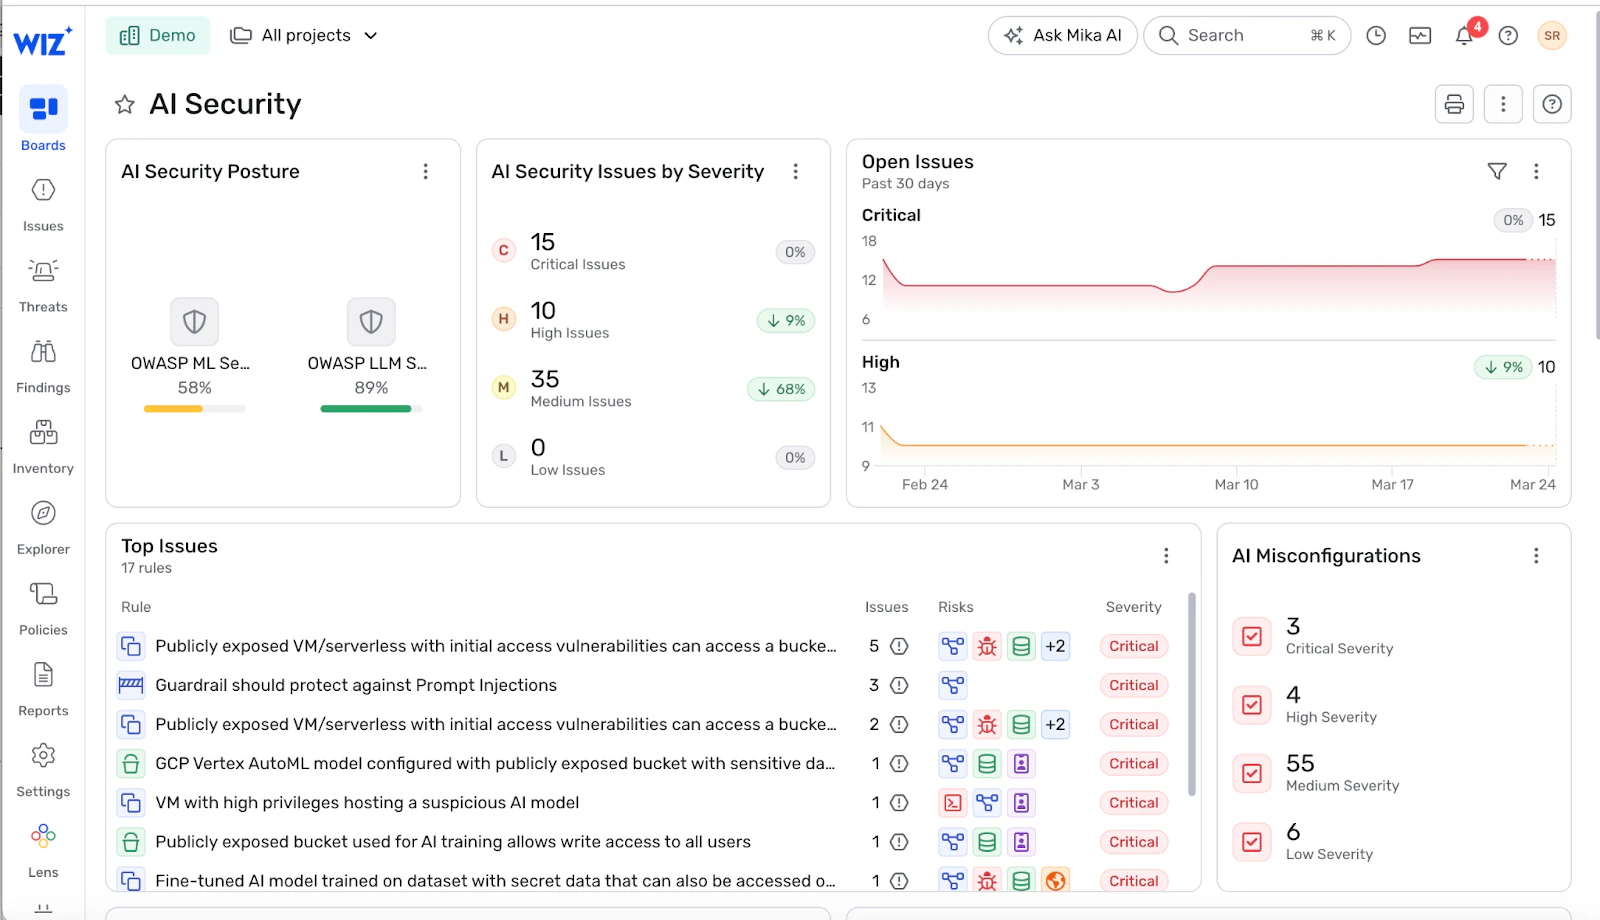
Wizは、AWS、Azure、Google Cloud全体で、AIサービス、model、それらが依存するクラウドresourceに対するagentlessのvisibilityを提供します。これにより、セキュリティチームはAIのmisconfigurationを特定できます。対象はマネージドAI platformと、Kubernetes、仮想マシン、サーバーレスサービス上で動くカスタムのAI workloadの両方で、エージェントのデプロイやmodelのパフォーマンスへの影響もありません。
このアプローチを効果的にしているのはcontextです。WizはAIのmisconfigurationをアイデンティティの権限、ネットワークのexposure、データの機密度と関連付け、個々の問題が組み合わさって実際のattack pathになる様子を示します。「パブリックエンドポイント」や「過剰な権限を持つロール」といった単発の検出結果を並べるのではなく、公開されたinferenceエンドポイントが機密性の高いtraining datasetにアクセスできるサービスアイデンティティで動作しているケースのように、条件同士がどう交わるかを示します。
このcorrelationにより、セキュリティチームは深刻度スコアだけに頼らず、実際のexposureとビジネスへの影響に基づいてAIのmisconfigurationに優先順位を付けられます。どのAIサービスに到達可能か、何にアクセスできるか、どのmisconfigurationがblast radiusを大きく広げるかを、すぐに把握できます。
下の動画では、GenpactがWiz AI-SPMを活用してすべてのAIサービスを把握し、機密性の高いtraining datasetに結び付いた公開エンドポイントを特定した方法をご覧いただけます。同社は新しいAIアプリケーションのデプロイを加速させながら、高リスクなAIのmisconfigurationを削減しました。
Wizは、AIのmisconfigurationをその発生源までたどることもできます。リスクのあるAIエンドポイントが本番環境に現れた場合、チームはそれを作成したインフラやpipelinesまで追跡し、症状への対処を繰り返すのではなく根本原因を解消できます。このcode-to-cloudのvisibilityにより、AI環境が進化してもmisconfigurationの再発を防げます。
AIのmisconfigurationの検出を幅広いクラウドセキュリティのワークフローに組み込むことで、WizはAIリスクを独立したサイロ型の領域としてではなく、統合されたクラウドセキュリティプログラムの一部として管理できるようにします。このアプローチにより、クラウド環境全体でAIの導入が加速しても、チームはvisibilityとコントロールを維持できます。
AIのmisconfigurationをクラウド環境全体のcontextで把握し、実際のattack pathに基づいて優先順位を付ける方法について、Wizのデモでご確認ください。 Wizのデモを見る