
AI supply chainを構成する要素とは?
AI supply chainは、生データが本番環境で稼働するAIシステムになるまでのすべてを含みます。modelのデプロイよりずっと前から始まり、training、パッケージング、inferenceまで続きます。各段階は前の段階の完全性に依存しているため、弱点がシステム全体に連鎖的に波及する可能性があります。
基盤となるのはデータレイヤーです。ここには、modelのtrainingやfine-tuningに使用するdataset、システム間でデータを移動するpipelines、modelの学習のあり方を左右するラベリングやデータ拡充のサービスが含まれます。こうしたdatasetには機密情報や独自情報が含まれることが多く、改ざんや不正持ち出しの標的になりやすい傾向があります。
次に位置するのが、modelの設計とtrainingを行う開発レイヤーです。ここには、modelアーキテクチャ、PyTorchやTensorFlowなどのtrainingフレームワーク、実験管理システム、データサイエンティストの作業環境が含まれます。このレイヤーのセキュリティ問題は、必ずしも従来の脆弱性のようには見えません。認証情報の不正使用、安全でないシリアライズ、信頼できないdependenciesにより、modelが本番環境に到達する前にリスクが入り込むことがあります。
model artifactレイヤーは、trainingのoutputsを管理します。training済みのmodel、重み、設定ファイル、メタデータは、レビュー、承認、デプロイができるようにレジストリやバージョン管理システムに保存されます。これらのartifactが署名、整合性チェック、アクセス制御で保護されていなければ、攻撃者は侵害の明らかな兆候を残さずにmodelを置き換えたり改変したりできます。
デプロイ・inferenceレイヤーでは、modelがパッケージ化され、公開されます。ここには、コンテナイメージ、サービングruntime、Kubernetesなどのオーケストレーションplatform、APIゲートウェイ、inferenceエンドポイントが含まれます。認証、認可、レート制限、暗号化通信といった制御によって、誰がmodelを呼び出せるか、稼働中のmodelが何にアクセスできるかが決まります。exposureは設定だけでは見えにくいことが多いため、このレイヤーではエンドポイント、ID、ネットワーク経路にわたるvisibilityが不可欠です。
さらに、ほとんどのAIシステムはサードパーティ製コンポーネントに依存しています。具体的には、公開ハブから取得する事前学習済みのmodelと重み、オープンソースライブラリ、tokenizer、設定ファイル、商用AI API、vectorデータベース、マネージドAIサービスなどです。これらのコンポーネントはtrainingやinferenceのワークフローに深く組み込まれているため、上流で侵害が起きると、気付かれないまま本番環境まで波及する可能性があります。
AI supply chainが特に難しいのは、これらのレイヤーが密接につながっている点です。ポイズニングされたdatasetはmodelを汚染し、改ざんされたmodelはinference中にデータを漏洩させ、過剰な権限を持つデプロイは下流のすべてを露出させる可能性があります。AI supply chainを保護するには、各コンポーネントを個別に守るだけでなく、こうしたdependenciesを理解することが必要です。
AI supply chainセキュリティを無視できなくなっている理由
AI supply chainセキュリティが注目されているのは、多くの組織がこれまで経験したことのない方法でAIが構築・デプロイされているためです。チームはさまざまな場所からmodel、データ、ツールを取り込み、短期間で組み合わせてAPI経由で公開しています。その過程で何を信頼しているのかを明確に把握できていないことも少なくありません。
数年前まで、AIの多くは研究環境の中にありました。現在では同じmodelが本番環境で稼働し、顧客データ、社内システム、自動化された意思決定につながっています。この変化によって、リスクの重みが変わります。侵害されたmodelは単なる技術的な問題にとどまらず、ユーザー、成果、事業運営に直接影響を及ぼす可能性があります。
AIの組み立て方も、supply chainリスクを見落としやすくしています。最新のAIシステムは、事前学習済みのmodel、オープンソースライブラリ、trainingに使うdataset、vectorデータベース、マネージドクラウドサービスに依存しています。その多くはブラックボックスとして提供されます。チームは何を使っているかは把握していても、それがどこから来たのか、どのようにtrainingされたのか、デプロイ後に他の何にアクセスできるのかまでは把握していない場合があります。
exposureも拡大しています。現在、modelにはinferenceエンドポイント、チャットインターフェース、APIを通じてアクセスするのが一般的です。つまり攻撃者は、ソースコードやファイルにアクセスしなくてもAIシステムに直接探りを入れることができます。場合によっては、それだけでmodelの挙動を抽出したり、trainingに使われたdatasetを推測したり、安全でない動作を引き起こしたりできます。
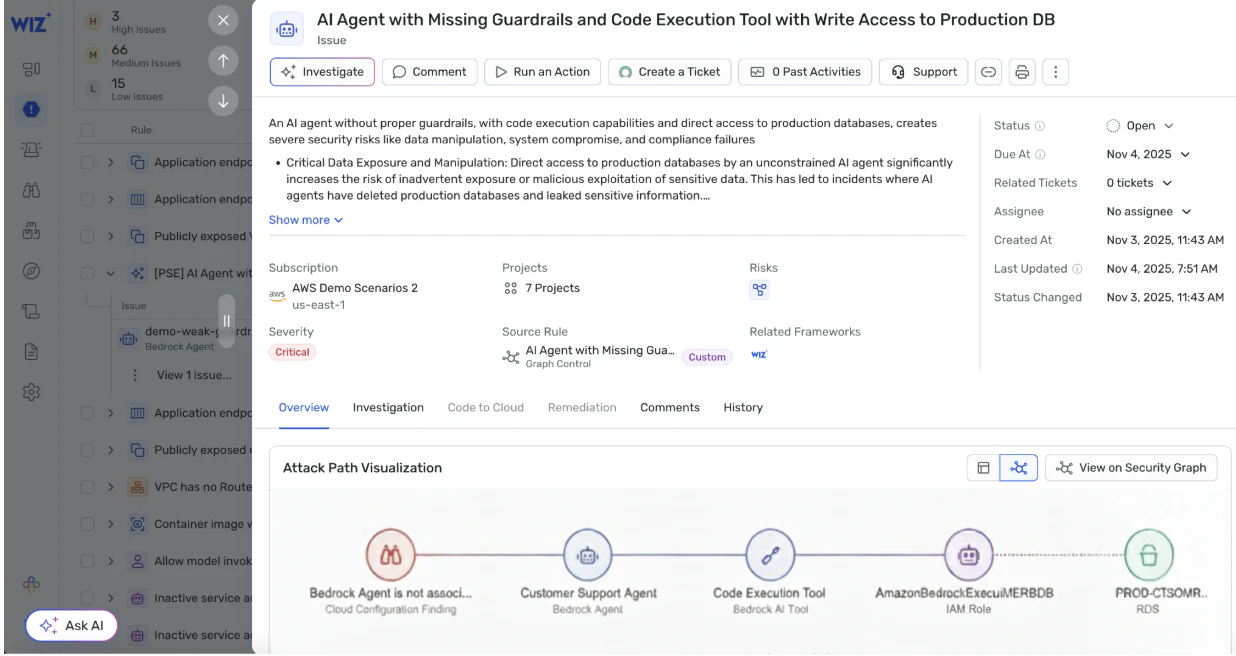
さらに厄介なのは、問題が必ずしも障害として表れない点です。ポイズニングされたdatasetやバックドアが仕込まれたmodelは、ほとんどの場合正常に動作します。問題は特定の入力や条件下でのみ表面化することがあるため、テスト中に見逃しやすく、デプロイ後の原因特定も困難です。
最後に、求められる水準も変わりつつあります。規制当局、顧客、パートナーは、AIシステムの出所と管理方法について明確な説明を求めるようになっています。来歴、完全性、説明責任に関する問いはもはや理論上の話ではなく、監査、調達審査、顧客との対話の場で実際に取り上げられています。
端的に言えば、AI supply chainセキュリティの重要性が高まっているのは、AIシステムが少し前と比べてもより多くのものとつながり、より露出し、より大きな影響を持つようになったためです。組織がAIに実務を担わせるようになるにつれ、その構築過程を理解し保護することは避けて通れなくなります。
AI supply chain攻撃が発生する仕組み
AI supply chain攻撃のほとんどは、劇的な侵害から始まるわけではありません。training環境、dependencies、model artifactといった信頼されたコンポーネントへの小さな侵害から始まり、それが気付かれないまま下流の本番環境へと移っていきます。
よくある侵入口の一つが、trainingおよびruntime環境そのものです。AI workloadは、高い権限を持つGPUドライバー、コンテナruntime、低レベルライブラリに依存していることが少なくありません。Wiz Researchは、AI関連インフラの脆弱性によって環境全体が露出し、攻撃者が権限を昇格させたり、共有システム上で稼働する機密性の高いworkloadにアクセスしたりできることを示しています。
もう一つのよくあるattack pathは、オープンソースのAIライブラリとリポジトリを経由するものです。多くのAIチームは、GitHubやパッケージレジストリから直接取得した人気のフレームワークやツールに依存しています。Wiz Researchが調査した実際のインシデントでは、攻撃者が広く使われているAIライブラリを侵害し、デプロイ後に暗号資産マイニング(cryptomining)を行う悪意のあるコードを注入しました。このコードは、training環境やinference環境へ気付かれないまま広がっていきました。
model artifactとシリアライズされたファイルも高リスクな領域です。training済みのmodelは静的なassetとして扱われがちですが、安全でないシリアライズ形式では、model読み込み時にコードが実行される可能性があります。Wiz Researchは信頼されたartifactに悪意のあるペイロードが埋め込まれたsupply chain攻撃を報告しており、そこではmodelの読み込みプロセスそのものがコード実行の経路になっていました。
supply chainリスクは、サードパーティとの連携やdependenciesを通じても生じます。AIパイプラインは、外部のmodel、重み、tokenizer、設定ファイルを頻繁に取り込みます。攻撃者が上流のdependencyを侵害すると、従来のアプリケーション脆弱性を悪用しなくても、その悪意のあるコードがAIのワークフローに波及する可能性があります。
そして、公開されたinferenceエンドポイントは、攻撃者がmodelと直接やり取りする手段になります。インフラやソースコードにアクセスできなくても、攻撃者はクエリを繰り返してmodelを探り、その挙動を抽出したり、trainingに使われたdatasetを推測したりできます。こうした攻撃は通常のトラフィックに紛れやすいため、contextに基づく監視がなければ検出は困難です。
これらの攻撃が特に危険なのは、巧妙に隠れる点です。侵害されたdependencyは正規のライブラリに見えます。ポイズニングされたmodelは、ほとんどの場合正常に動作します。脆弱なruntimeコンポーネントも、悪用されるまでは想定どおりに動作します。攻撃者はAIパイプライン全体を侵害する必要はなく、信頼されたつながりを一つ侵害すれば、あとはsupply chainが攻撃を広げてくれます。
AI supply chainを保護するうえでの課題
AI supply chainの保護における最大の課題の一つは、何が存在するのかを把握することです。AI assetは、データサイエンスチーム、実験用ノートブック、場当たり的なpipelinesなど、従来のソフトウェアワークフローの外で作られることが少なくありません。model、dataset、エンドポイントは一元的なセキュリティレビューを一度も経ないまま複数のクラウドアカウントに短期間で出現することがあり、inventoryでの把握やgovernanceの適用が難しいshadow AIにつながります。
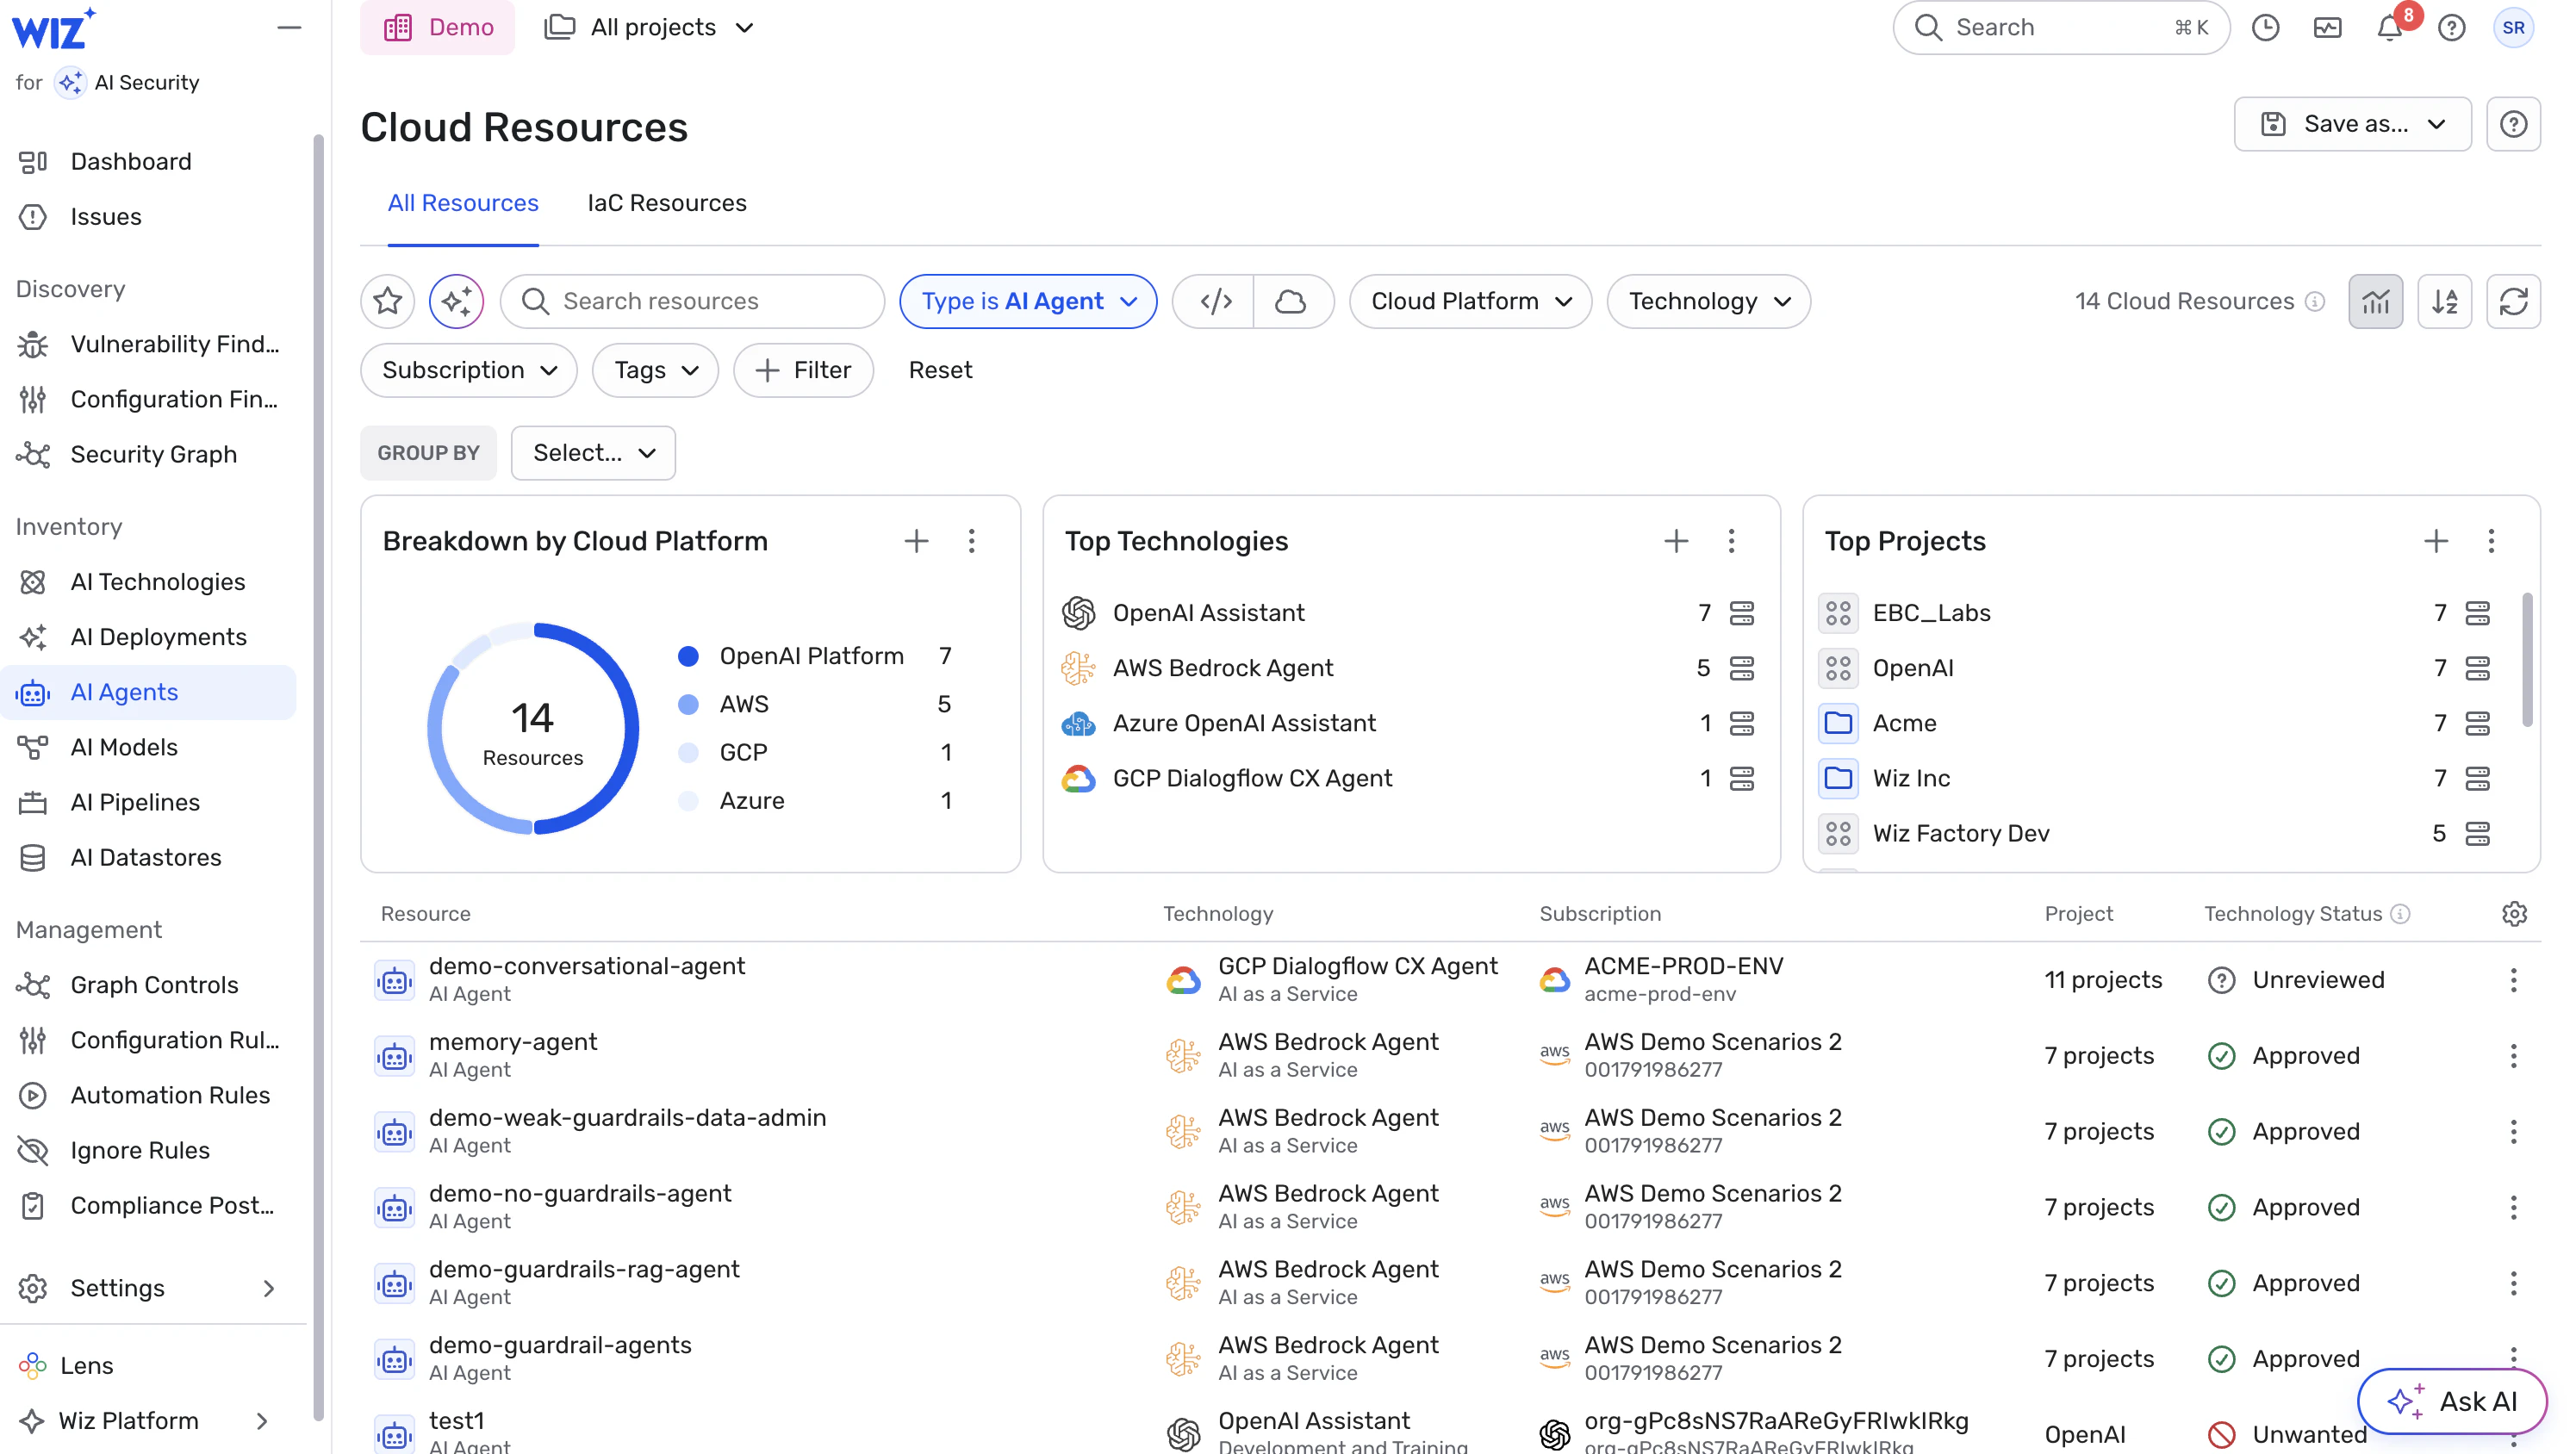
assetを把握できていても、dependenciesの複雑さによってリスクの評価は難しくなります。AIシステムは、特定バージョンのオープンソースライブラリ、GPUドライバー、trainingフレームワーク、事前学習済みの重み、外部データソースに依存している場合があります。コード、データ、インフラのいずれかのレイヤーに弱点があればシステム全体が損なわれかねませんが、これらのdependenciesが一か所でまとめて追跡されることはほとんどありません。
一時的なtraining環境も難しさを増します。大規模なtrainingジョブでは、GPUを搭載した数千ものインスタンスが短時間だけ起動され、その後消えることがあります。常駐型のエージェントや手動レビューに依存する従来のセキュリティツールはこうした環境を完全に見逃しがちで、AI lifecycleの中でも特に機密性の高い段階でvisibility gapが生じます。
サードパーティのmodelとartifactの検証も容易ではありません。公開されているmodelハブやリポジトリは既存の成果を再利用しやすくする一方で、modelがどのようにtrainingされたのか、どのデータが使われたのか、artifactが改変されていないかについては限られた情報しか得られません。来歴と完全性を確かめる強固な仕組みがなければ、チームは重要なシステムの中で中身の見えないコンポーネントを信頼せざるを得なくなります。
検出を難しくしているのが、AIの挙動が確率的であることです。侵害されたmodelがもっともらしいoutputsを生成し続けることもあり、自然なdrift、性能上の問題、意図的な操作を見分けるのは困難です。従来のソフトウェアとは異なり、検証の基準となる唯一の「正しい」outputsが存在しないことも少なくありません。
組織間の摩擦も影響します。AIシステムはデータサイエンス、エンジニアリング、セキュリティ、platformの各チームにまたがり、それぞれ優先事項もツールも異なります。共通のvisibilityと明確なownershipがなければ、supply chainリスクはend-to-endで対処されることなく、チーム間の隙間に落ちてしまいます。
さらに、マルチクラウド環境では、AI supply chainを大規模に保護することがいっそう難しくなります。AI workloadは特定のサービスやハードウェアを利用するために複数のプロバイダーに分散していることが多く、一貫したポリシーと制御を適用するのは容易ではありません。統合されたビューがなければ、個々の環境は保護できても、クラウドをまたぐattack pathを見逃すおそれがあります。
クラウドセキュリティにおけるAI supply chainセキュリティの位置付け
AI supply chainセキュリティはクラウドセキュリティと別の分野ではありませんが、クラウドだけに限られるものでもありません。コスト、レイテンシー(遅延)、データ所在地を管理するために、オンプレミスのtrainingクラスター、エッジでのinference、ハイブリッド構成を採用している組織もあります。それでも、最新のAI supply chainの大半が最終的に交わる場所はクラウドインフラです。
modelのtrainingやデプロイをクラウド外で行う場合でも、ワークフローの重要な部分はクラウドを経由することが少なくありません。trainingに使うdatasetをクラウドストレージに配置したり、クラウド上のレジストリからmodelを取得したり、マネージドサービスでpipelinesをオーケストレーションしたり、inferenceシステムをクラウドのIDで認証したりするケースです。その結果、AI supply chainのリスクは、クラウドの権限、ネットワークのexposure、データアクセス経路を通じて表れることがよくあります。
一方で、すべてのAI supply chainリスクがcloud nativeなわけではありません。侵害されたオープンソースのmodelの重み、ポイズニングされたサードパーティのdataset、MLフレームワークの脆弱性は、クラウドインフラが関与する前の段階でリスクをもたらす可能性があります。これらの問題はライフサイクルのより早い段階で発生し、modelがどこで稼働してもついて回ります。
クラウドが重要になるのは、こうしたリスクが集まり、増幅される場所だからです。改ざんされたmodelは、公開エンドポイントの背後にデプロイされたときに最も危険になります。ポイズニングされたdatasetは、本番環境の機密データとやり取りするmodelの再trainingに使われたときに最も大きな影響を及ぼします。脆弱なMLフレームワークは、過剰な権限を持つクラウドIDの下で稼働すると深刻なインシデントにつながります。
だからこそ、AI supply chainセキュリティはクラウドセキュリティの中核的なプラクティスと密接に関わります。クラウド態勢管理(cloud posture management)は、trainingに使うdatasetやmodel artifactの保存方法を統制します。ID・アクセス管理(Identity and Access Management)は、誰が、また何がmodelやpipelinesとやり取りできるかを制御します。データセキュリティは機密性の高いdataset、embedding、inferenceログを保護し、脆弱性管理はmodelのtrainingやサービングに使うコンテナ、イメージ、dependenciesを保護します。
AIによって変わるのは、これらのレイヤーがいかに密接に結びついているかです。安全なクラウド環境であっても、安全でないmodel artifactによって損なわれる可能性があります。高品質なmodelでも、過剰な権限の下で稼働すればリスク要因になります。AI supply chainのリスクが単一の障害として表れることはまれで、データ、model、dependencies、ID、exposureの経路の相互作用から生じます。
多くの組織にとって効果的なAI supply chainセキュリティとは、クラウド外で発生するリスクも認識しつつ、既存のクラウドセキュリティのワークフローを拡張し、AI固有のassetとdependenciesにも対応させることです。model、データ、インフラ、IDのつながりに対する継続的なvisibilityがあれば、supply chainリスクが本番システムやビジネス上の重要な意思決定に波及する前に、チームが早期に捉えられるようになります。
WizがAI supply chainの保護を支援する方法
Wizは、クラウドリスクの管理にすでに使用しているのと同じplatform上でAI asset、インフラ、データのexposureを可視化することで、AI supply chain全体にわたるAIセキュリティ態勢の確保を支援します。Wizはmodelのgovernance、公平性レビュー、規制上の適合性評価に代わるものではありません。一方で、実際のクラウド環境においてAIシステムがどのように露出し、悪用され、攻撃されうるかを示すことで、重要なギャップを埋めます。
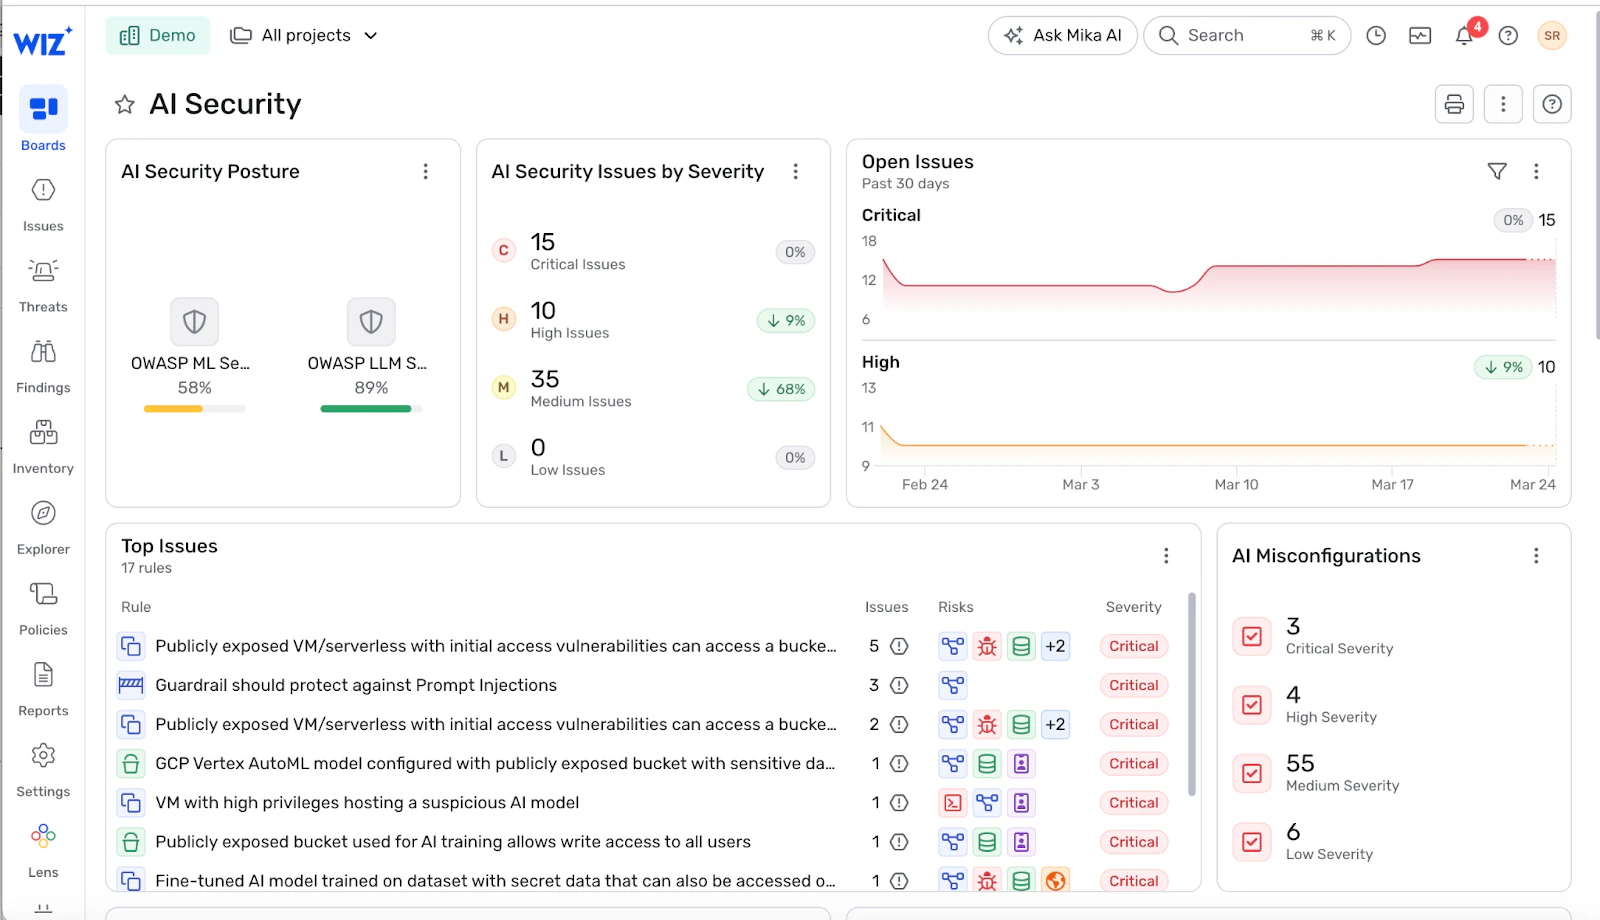
Wizはagentlessなアプローチにより、AWS、Azure、GCP全体でAIサービス、training環境、modelエンドポイント、保存場所、それを支えるインフラを継続的に検出します。対象には、Amazon SageMakerやBedrock、Azure OpenAI ServiceやAzure Machine Learning、Google Vertex AIなどのマネージドplatformに加え、Kubernetesや仮想マシン上で稼働するカスタムのAI workloadも含まれます。この検出によって実質的にAI-BOM(AI版部品表)が作成され、チームはmodel、dataset、pipelines、ID、サービスをinventoryとして把握し、標準的な管理の外にあるshadow AIを洗い出せます。
Wizは、Security Graphを使ってこれらのAI assetをクラウドのcontextと関連付け、ID、ネットワークのexposure、脆弱性、機密データを結び付けます。個々のmisconfigurationを指摘するだけでなく、attack path、つまりexposure、権限、データアクセスの組み合わせによって小さな問題が実際のsupply chainリスクに変わる経路を明らかにします。これにより、どのAIコンポーネントが悪用されると、データの不正持ち出し、lateral movement、AIを活用したシステムへの不正アクセスにつながりうるかを把握できます。
Wizは、ライフサイクル全体にわたるAI supply chainセキュリティも支援します。code-to-cloud visibilityにより、公開されたAIサービスを、それを生み出したpipelinesやinfrastructure as codeまでさかのぼって結び付けられるため、根本的な修正につながります。runtimeでは、Wiz DefendがAIインフラを監視し、サービスIDの不正使用、データの不正持ち出し、暗号資産マイニングといった不正利用のパターンを検知します。焦点はmodel outputsの良し悪しを判断することではなく、AIがクラウドの攻撃対象領域をどのように拡大するかにあります。
AI supply chainにおけるモデル、データ、ID、インフラのつながりを可視化し、リスクを把握する方法をWizでご確認ください。 Wizの実際の動作を見る