エグゼクティブサマリー
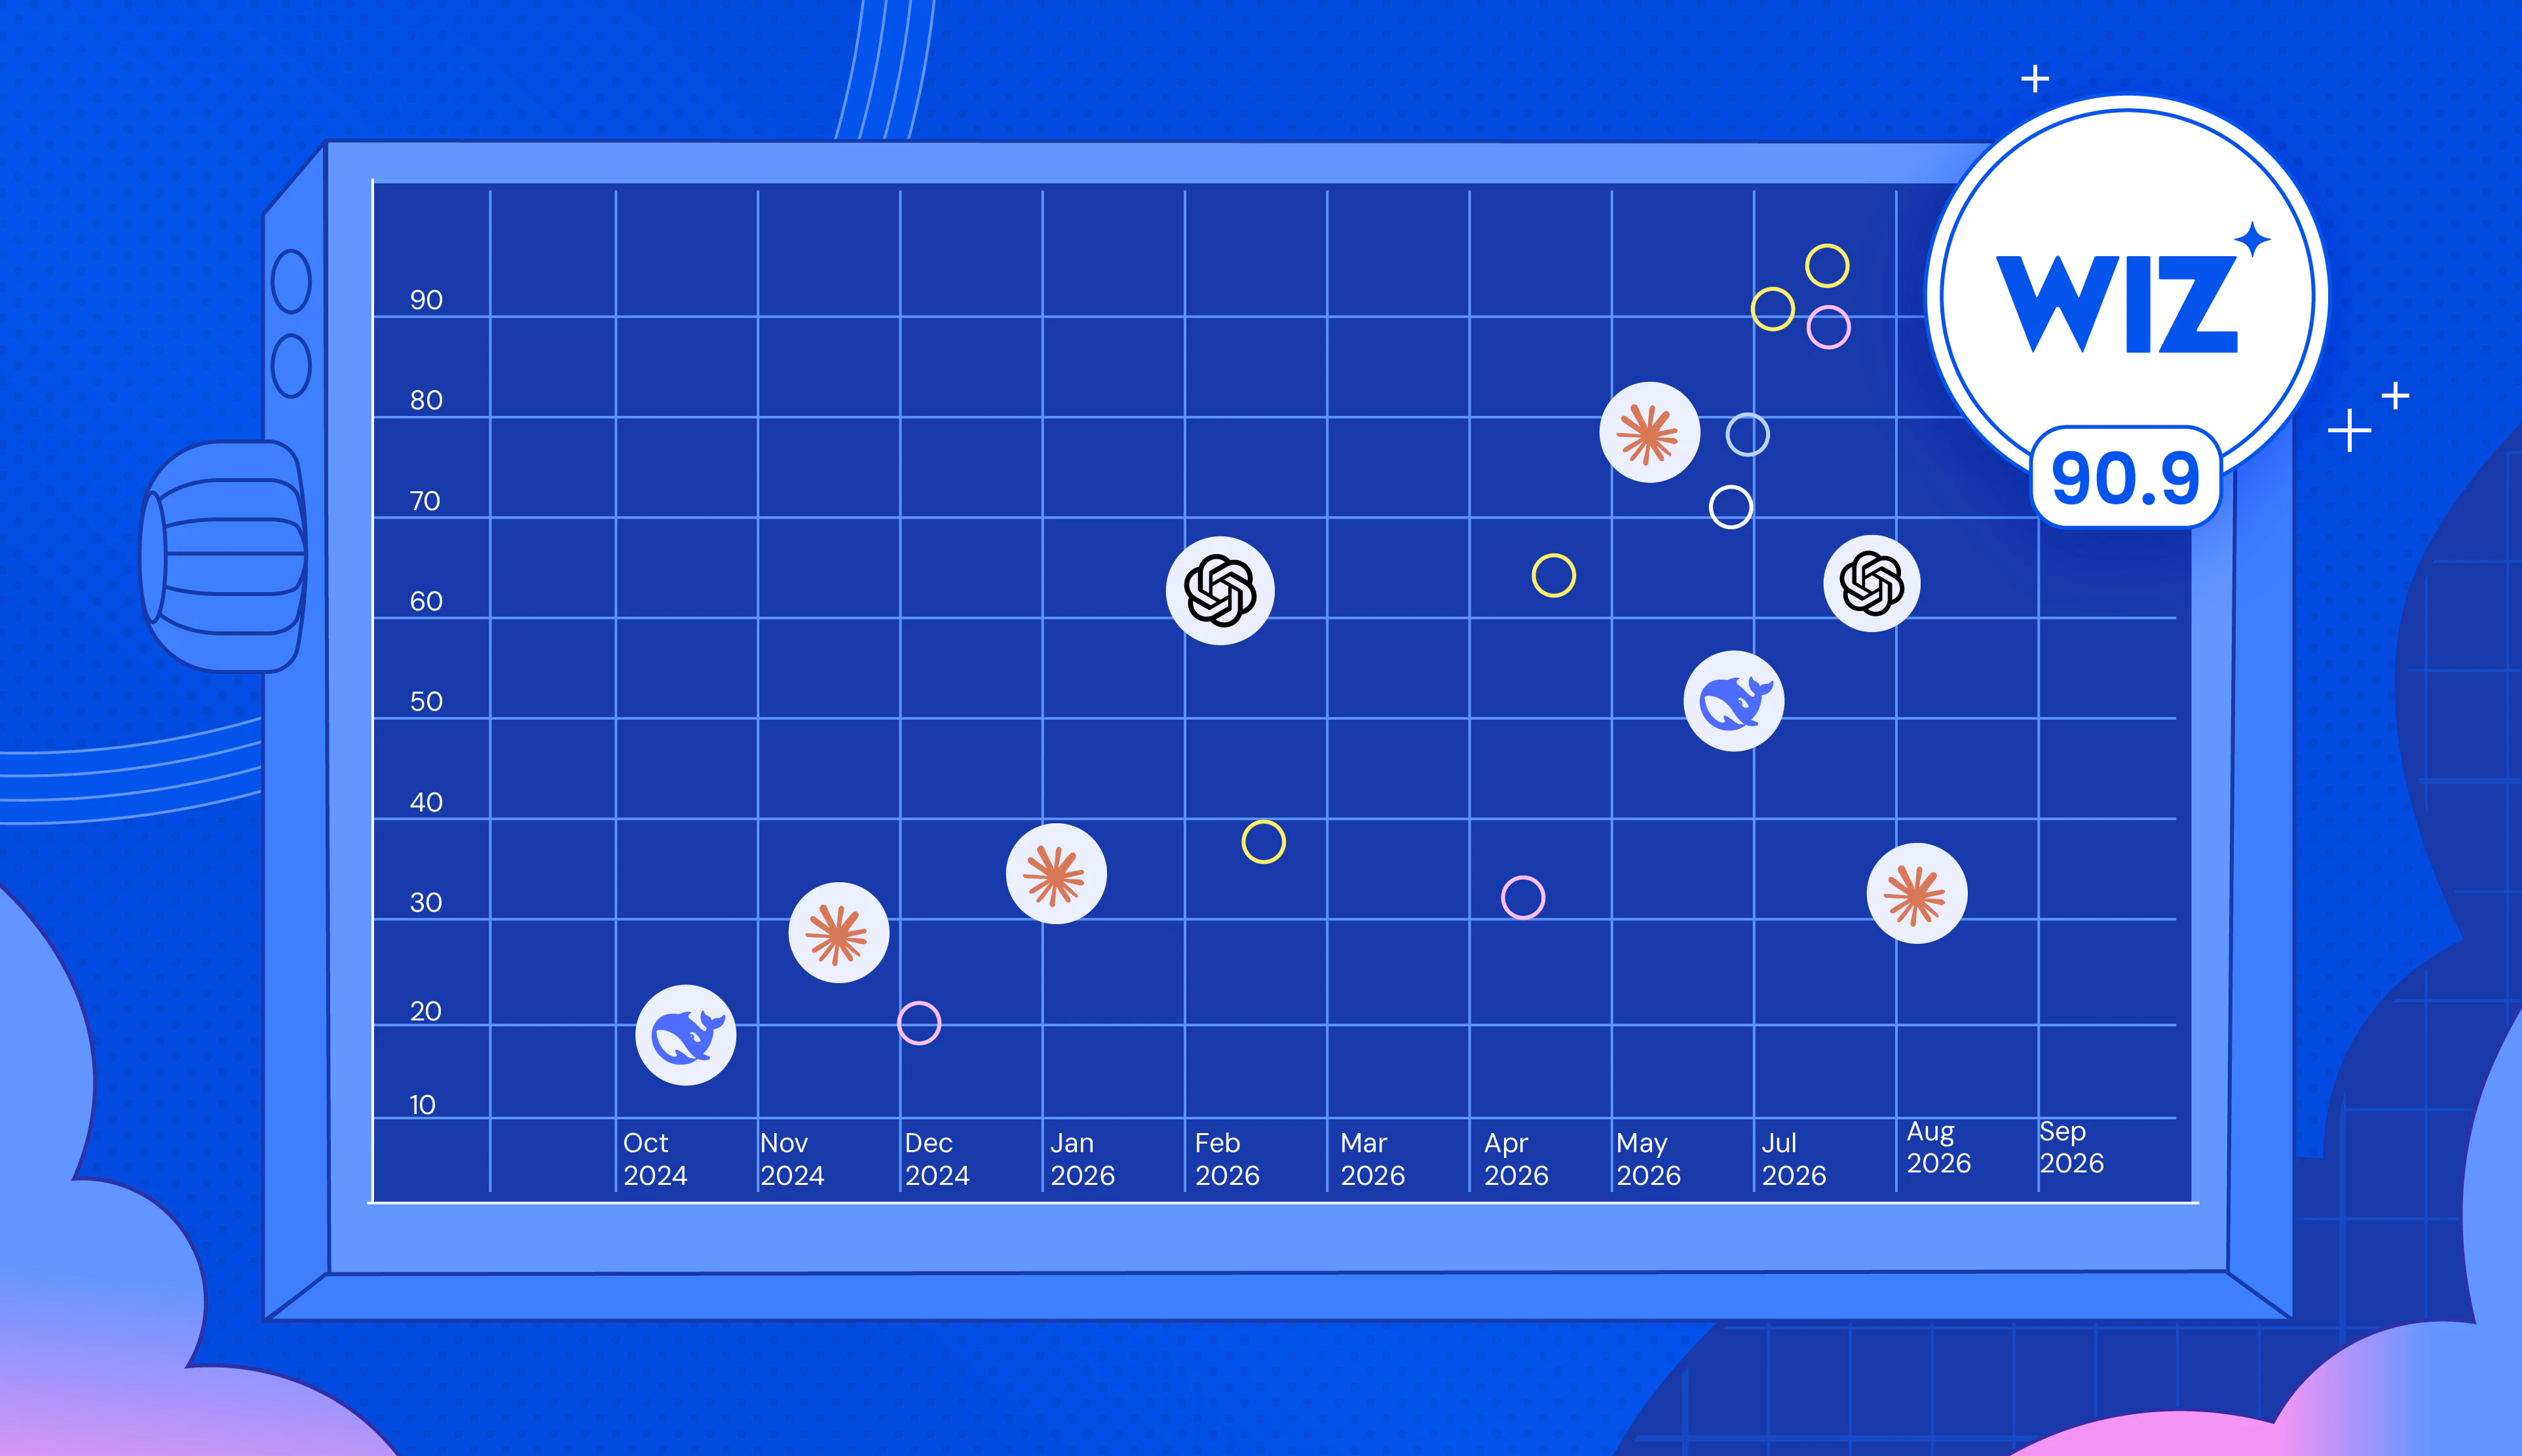
過去数ヶ月にわたり、Wiz Researchチームは脆弱性調査のための自律型AIシステムであるAtlasを構築し、世界で最も厳重に監査されているオープンソースプロジェクトに対してテストを行ってきました。現在、AtlasはAI主導の脆弱性調査に関する公開ベンチマークである「CyberGym」において、90.9%の成功率で第1位を獲得しています。また、自社のテストにおいては、何十年もの間ファジングやコードレビューが繰り返されてきた広く利用されているオープンソースコードから、200件以上の未知の脆弱性を発見しました。
Atlasは、フロンティアモデルを活用してAI SASTを大規模に提供し、高度なコードスキャンをあらゆる組織で利用可能にするという広範な取り組の一環として開発されました。これは、高コストで一時的なポイントインタイムの分析を脱却し、すべてのコードベースにわたって経済的に運用でき、セキュリティチームや開発チームが信頼して対処できる検証済みの検出結果を生み出す継続的なシステムへと移行することを意味します。
私たちがAtlasをコスト効率と精度の両面で最適化した理由はここにあります。深いレベルの分析は大規模に実行できるほど経済的である必要があり、報告されるすべての検出結果はシステムによって生成された動作するエクスプロイトによって検証され、誤検知を低く抑えています。
このプロセスを通じて私たちが学んだ最大の知見は、持続的な優位性は単一のAIモデルにあるのではなく、その周囲を固める「システム」にあるということです。スキャンをどのようにスコープ化し、オーケストレーションし、検証し、実用的なセキュリティ成果へと結びつけるかが重要なのです。本記事では、Atlasの仕組み、大規模なAI駆動型コードセキュリティの構築から得られた学び、Atlasが発見した脆弱性の一例、そしてWizが構築を進めている包括的なエージェント型セキュリティシステムの中にAtlasがどのように組み込まれるかについて技術的な視点から解説します。
なお、WizがGoogleに参画した理由の1つは、サイバー防衛のための最先端AIモデルで協力できることにありました。Google Cloudの一員となって以来、私たちはDeepMindのチームと連携してAtlasに対するフィードバックを得るなど、このアドバンテージを最大限に活かしています。
成果:高度に監査されたオープンソースソフトウェアで検証された200以上の脆弱性
Atlasの性能を評価するため、grpc、dnsmasq、Kubernetes、gVisor、Linuxカーネル、containerdなど、世界で最も入念にコードレビューされているオープンソースプロジェクトに適用しました。その結果、Atlasは200件以上の未知の脆弱性を発見しました。重要なのは、AIエージェントシステムが検出から実証までを完全に自律して行っている点です。AIモデルによる単なる「疑い(誤検知の可能性)」にとどまらず、実際のセキュリティ上の問題であることを再現可能な形で証明しています。
発見された問題は多岐にわたる脆弱性クラスに及び、何十年にもわたって分析、ファジング、レビューが行われてきた複雑なコードベースに対してAtlasが高度な推論を行えることを示しています。
現在、私たちは責任ある開示プロセスに従って、関連するメンテナーに対してすべての検出結果の報告を進めており、修正パッチが利用可能になるまで詳細な技術的情報の公開は控えています。
本調査で得られた特に興味深い成果の1つは、GitHubにおけるクリティカルなRCE(リモートコード実行)脆弱性の発見(CVE-2026-3854)です。この発見(GitHub史上最大のバグバウンティ報酬の支払いにつながりました)は、Atlasの機能を強く象徴しています。このバグを発見したリサーチャーは、Atlasシステムの初期バージョンとして機能するAI拡張ツールを利用していました。その初期バージョンは、過去最大級のクラウド脆弱性の1つを発見する上でも重要な役割を果たしました(これについては、今後のBlack Hatでの講演で詳しく紹介する予定です)。

なぜモデル単体ではなく「システム」なのか
私たちは、フロンティアモデルをコードセキュリティに適用するための拡張可能な方法を模索しました。それは、多数のコードベースにわたって深く分析を実行でき、モデルの進化とともに精度が向上し、防衛側が信頼できる検出結果を生成し、企業全体で継続的に実行しても経済的に見合うというものです。
私たちは以下の4つの原則に基づいてAtlasを設計しました。
Atlasの仕組み
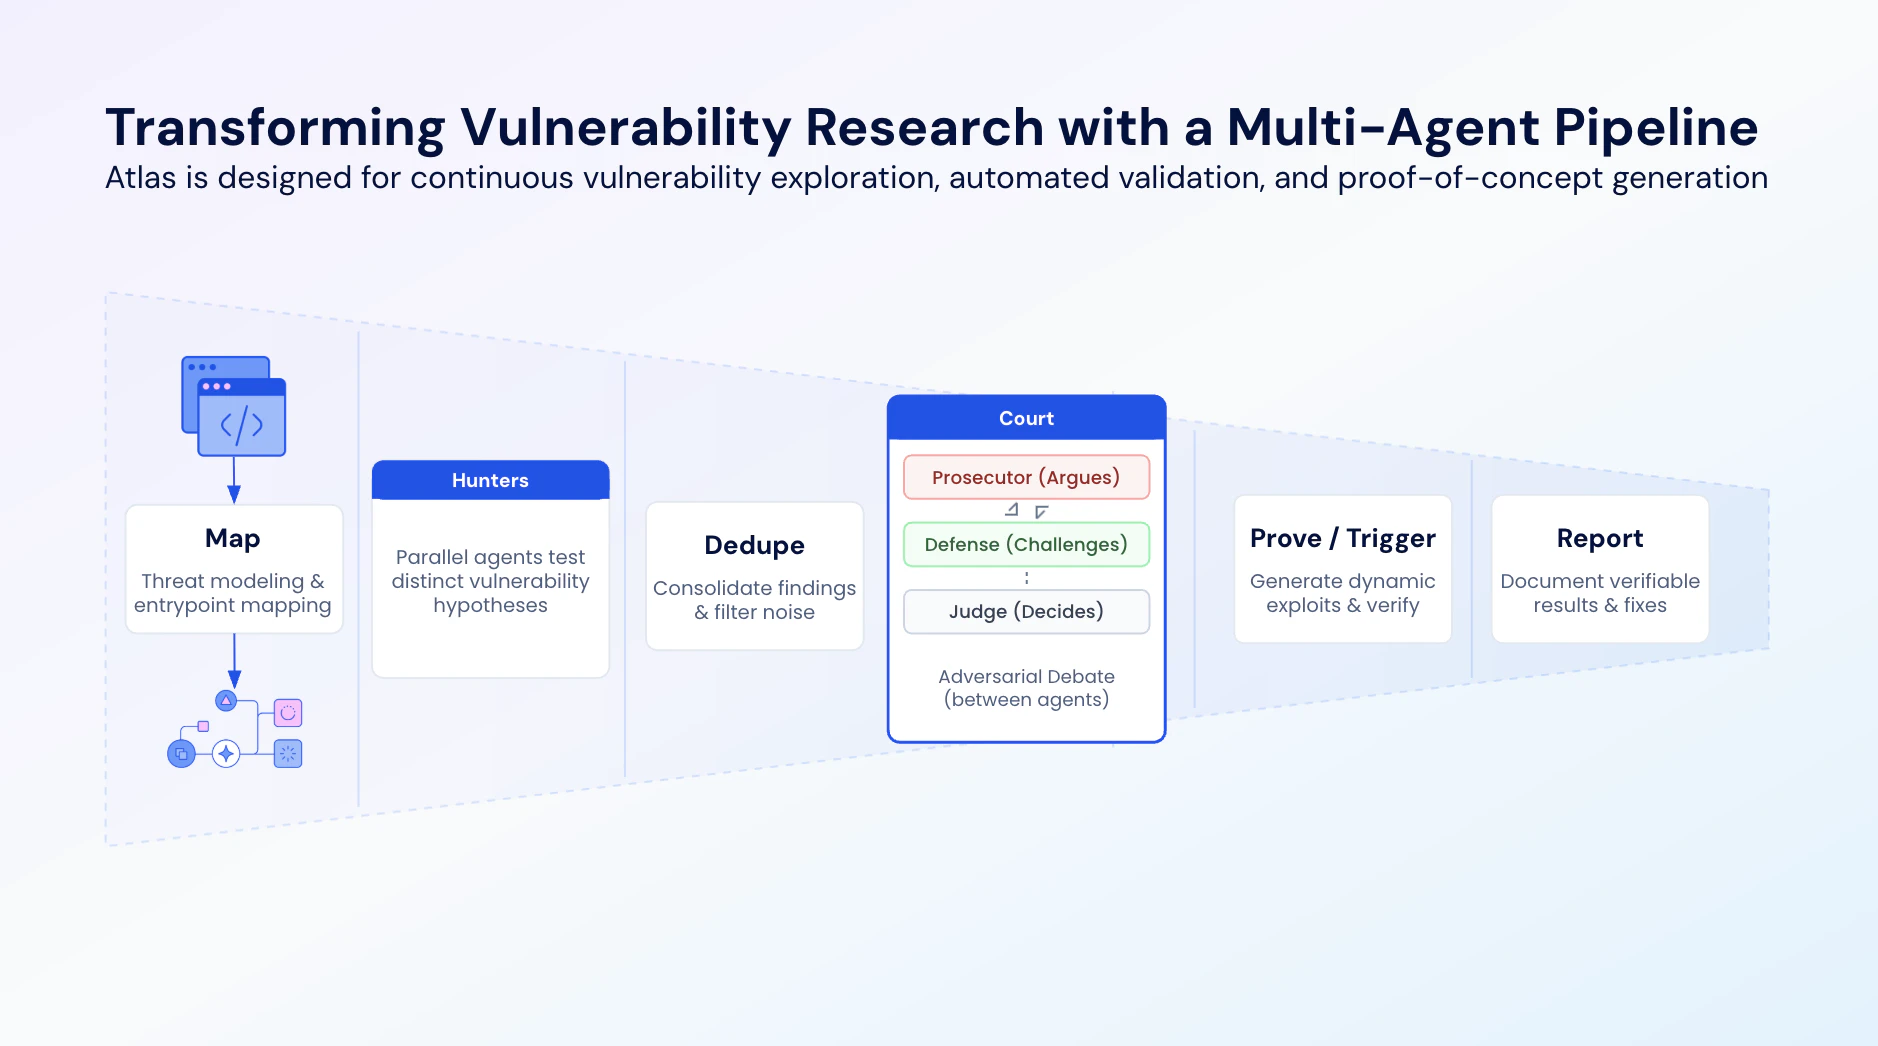
Atlasは、それぞれ明確な役割を持つ一連の特化型AIエージェントとして構造化されています。リサーチチームが脆弱性に取り組むのと同様に、コードベースの理解、手がかりの作成、検証・反証、そして報告前の確定というステップを踏みます。作業は名前付きの個別のステージに分割されており、単一のモデルにエンドツーエンドで委ねるのではなく、プログラムによって決定論的にオーケストレーションされます。
1. 攻撃表面(Attack Surface)のマップを作成
探索を開始する前に、Atlasはコードベースの構造化された脅威モデルを構築します。エントリーポイント、信頼できない入力が入る場所、その入力がたどるパス、最終的に到達し得る危険な操作などを特定します。ファイルを単独で読み込むのではなく、コードプロパティグラフ(CPG)に基づかせることで、周囲のテキストからの推測ではなく、実際の呼び出しおよびデータフローの事実に基づいて推論を確定させます。
2. 並列でハンティング
複数のエージェントが独立して調査を行い、脆弱性にどのように到達しトリガーできるかについて、各自の仮説を立ててテストします。複数の独立したアプローチを同時に走らせ、検証に耐えたものだけを保持することで、単一のパスでは見落とされてしまうような複雑で多段階のバグをAtlasは発見することができます。
3. 敵対的検証
各候補(脆弱性)は無条件に受け入れられるのではなく、敵対的に検証されます。1つのエージェントが「この検出結果は本当に悪用可能である」と主張し、もう1つのエージェントが「悪用不可能である」と反論し、3つ目のエージェントが証拠を評価して裁定を下します。敵対的な反証に耐え抜いた検出結果のみが生き残ります。また、意味的に等価な候補は単一の検出結果に集約されるため、同じバグが複数の方法で報告されてチームを混乱させることはありません。この敵対的ステージこそが、誤検知率を低く抑えるための最大の要素です。
4. トリガーによる実証
静的な推論で終わるのではなく、Atlasは専用の実行環境を構築し、必要な依存関係をインストールして、セキュリティに関連する動作を動的に検証するための入力(トリガー)を実行します。
Atlasの構築から学んだこと
AI評価ベンチマークを通した構築
AI評価ベンチマークとは、重要なタスクにおけるAIシステムのパフォーマンスを定量化する、再現可能で客観的なベンチマークです。AIの出力は確率的であるため、効果的な評価にはニュアンスや文脈の評価が不可欠です。
私たちは評価駆動開発を用いてAtlasを構築しました。パイプラインのすべてのAIコンポーネントおよびステージに対して、変更を加える前に厳格な品質メトリクスを設定しました。このアプローチは非常に重要であることが証明されました。なぜなら、エージェントの挙動はしばしば直感に反するからです。経験豊富なセキュリティリサーチャーにとって直感的に有益と思える変更が、実際には何の影響も与えなかったり、脆弱性調査の結果を低下させたりすることが頻繁にありました。仮説ではなく客観的な評価に頼ることで、プロンプトの調整からモデルのアップデートに至るまで、すべての開発決定が測定可能な改善に基づいていることを確実にしました。
たとえば、検証層の候補判定精度を測定する評価指標を例に挙げます。この評価では、一部の既知の誤検知や、低・中・高・クリティカルの重大度を持つ真正の検出結果を含む脆弱性候補のセットを用意します。次に、検証層のバージョンを呼び出してこれらの候補を評価させ、正解に対する精度を測定します。これにより、新しい検証アイデアをテストし、そのコストとパフォーマンスを比較することができます。
タスクを厳密にスコープ化し、決定論的にオーケストレーションする
2つ目の発見は、アーキテクチャ全体を決定づけました。現在のフロンティアモデルは、狭く厳密にスコープ化されたタスクにおいては非常に優れていますが、オープンエンドで多段階のワークフロー全体を最初から最後まで任された場合、信頼性や一貫性が大幅に低下します。そのため、「バグを見つける」というゴールをモデルにそのまま渡すのではなく、作業を上記の離散的なステージに分解し、プログラムによってオーケストレーションしています。決定論的なコードでワークフローを駆動し、モデルは真に優れている推論ステップに集中させることで、LLM主導やスキル主導のオーケストレーションよりも大幅に優れた成果が得られました。
それぞれの作業に最適なモデルを使用する
あらゆるタスクにおいて万能な単一のモデルは存在せず、また最先端であり続けるモデルもありません。私たちは、新しいモデルがリリースされるたびに Cyber Model Arena および内部ベンチマークスイートを通じて評価を行い、脅威モデリング、ハンティング、検証、証明生成といった調査を構成する特定タスクごとにスコアを測定しています。結果が均一になることはめったにありません。複雑なエクスプロイトチェーンを最もよく推論できるモデルが、トリアージを最も正確に行えるモデルであるとは限りません。Atlasは、各ステージでそのタスクにおいて最も優れたモデルへと処理をルーティングします。
実際、Atlasは単一の「頭脳」に依存していません。リサーチプロセスの特定のステージに最適化された自治的な特化型頭脳のセットとして動作します。このアーキテクチャは意図的に動的となっています。新しいモデルが登場するたびに評価フレームワークを使用して再評価を行い、そのモデルが特定タスクでより優れたパフォーマンスを発揮するか、既存のエンジンを置き換えるか、あるいは補完すべきかを迅速に判断します。
専用ハーネスを使用する
マルチモデル・マルチエージェントのワークフローを駆動するには、汎用のコーディングエージェント向けではないインフラが必要であったため、私たちは脆弱性調査に特化した自社専用のハーネスを構築しました。これは、作業のコストとパフォーマンスプロファイルに最適化されています。これにより、設計段階から特定のモデルに依存しないことが可能になりました。より優れたモデルが登場した際には、全体の再設計を行うことなく、該当するステージにそれを組み込むことができます。原理はシステム全体と同じです。ハーネスは、そのタスクにおいて現在最高であるモデルの価値を増幅させます。Atlasの核心は、投じられたコストを検証済みの脆弱性検出結果へと変換するための器です。モデルの変更、ツールのアップグレード、パイプラインの最適化のいずれを行う場合でも、私たちのゴールはAtlasを最も効率的な器であり続けさせることです。
今後の課題:更なる評価の実施
CyberGymは非常に貴重なベンチマークですが、それが「何を測定し、何を測定しないか」を正確に把握しておくことが重要です。各タスクでは、説明や関連コードを含む既知の脆弱性がシステムに与えられ、バグをトリガーする動作可能な概念実証を生成できるかどうかを評価します。これにより、CyberGymはエクスプロイトの再現に関する公開ベンチマークとして最も強固なものとなり、直感ではなく確固たる証拠に基づいてAtlasを開発・評価するための重要なツールとなります。
しかし、既知の脆弱性を再現することと、未知の脆弱性を発見することは、異なる(そして議論の余地なく後者のほうが難しい)課題です。現実世界の発見は、説明も脆弱な関数へのポインタもなく、絶えず変化するコードベースが存在する「白紙の状態」から始まります。これこそが防衛側が最終的に解決を必要としているより困難な問題であり、CyberGymが測定していない部分です(現在、この点を完全に測定できる公開ベンチマークは存在しません)。
Atlasを改善し続けるため、私たちは未知の脆弱性に対する発見、検証、および再現を測定するための追加評価に投資しています。目的は、システムがもっともらしい候補を生成するだけでなく、広範な検出結果の中から真の脆弱性を一貫して表面化させられるようにすることです。
また、私たちは現実世界でもAtlasを評価しています。高度に監査されたコードベースで本物の脆弱性を見つけられるか、そしてクリティカルな検出結果とノイズ(低シグナル)をどれだけ正確に区別できるかをテストしています。
AtlasがセキュリティチームとWizのお客様にもたらす価値
AIはサイバーセキュリティにおいて急速に能力を高めており、新しい世代のモデルが登場するたびに可能な領域が広がっています。過去数ヶ月間、セキュリティチームがこれらのモデルを実際のコードベースに適用する中で、その強力さを目の当たりにしてきました。しかし同時に、フロンティアモデルをコードベースに一度だけ適用することは持続可能なセキュリティ戦略ではないことも学びました。深いスキャンは高コストであり、コードが刻一刻と変化する中で分析結果はすぐに陳腐化してしまいます。また、ポイントインタイムの分析では、組織がすべてのリポジトリにわたって必要とする継続的なカバー範囲を提供できません。
AI時代におけるコードセキュリティの決定的な問いは、「スキャナーがどのモデルを使用しているか?」ではありません。「システムが、現在利用可能な最高のモデルをどのように継続的かつ経済的に活用し、さらに優れたモデルが登場したときにも機能し続けられるか?」です。これこそがAtlasの背後にある賭けです。専門的な推論が必要な部分にはフロンティアモデルの深さを適用し、モデルの進化とともに向上するアーキテクチャを備え、すべての検出結果が単なるもっともらしい回答ではなく証拠を伴って届くよう厳格な検証を行います。
Wizの顧客にとっての意義
私たちは、継続的なカバー範囲と深い調査を組み合わせたAIコードスキャンの実用的なシステムとして、Wiz Codeの一部にAtlasを組み込むことを進めています。
Wiz Codeは、すべてのアプリケーションとすべての変更を継続的に評価し、機密コンポーネント、疑わしいデータフロー、露出されたパス、影響の大きい変更など、より集中的な分析を保証する領域を特定します。AtlasおよびGoogle CodeMenderを含むその他の特化型エンジンは、意味のあるリスクを解明する可能性が最も高い領域に対して、より大きなコンテキスト、計算資源、推論を適用することができます。
すべての検出結果は単一のWizシステムに統合・集約されます。セキュリティグラフは、コード、クラウド、アイデンティティ、ランタイム、および露出にわたってコンテキストを追加し、レッドエージェントとグリーンエージェントがリスクを検証して修復プランを構築します。これにより、継続的で広範なカバー率と、必要に応じた深い分析、そしてアプリケーションリスクに対する「単一の信頼できる情報源」が実現します。
Wiz Codeがコード段階からAI時代のアプリケーションセキュリティをどのように支援できるか、詳細についてはWizのエキスパートにご相談ください。
AIコードスキャニングガイドを取得