
敵対的AIとは何ですか?
敵対的AIはサイバー攻撃の一種です。わずかに改変したデータを人工知能(AI)や機械学習(ML)のシステムに入力し、誤った判断を下すように仕向けます。
こうした攻撃は、AIの価値を生み出す能力そのものを武器にします。脅威アクターは、ガードレールの回避、training datasetsの汚染、modelの挙動からの機密情報の抽出を狙って悪意のある入力を作成します。その結果、AIシステムは正常に動作しているように見えながら、裏では攻撃者の目的に沿って動くことになります。
こうしたシステムがクラウド上で稼働している場合、敵対的AIがmodelだけの問題にとどまることはほとんどありません。多くの場合、誰がエンドポイントを呼び出せるのか、modelがどのデータを読み取れるのか、ホスティング先のworkloadが侵害されたらどこまで到達できるのか、といったクラウドの実情と結び付いています。この点も、敵対的AIを危険なものにしている要因の1つです。
敵対的AI攻撃が危険なのはなぜですか?
ミッションクリティカルなシステムでAIの導入が急速に進んだことで、敵対的AIは喫緊のセキュリティ課題になりました。AIが不正検知、自動運転車、顧客向けアプリケーションを支えている場合、敵対的攻撃(Adversarial attacks)が成功すると、現実世界に大規模な被害が及ぶ可能性があります。
Wizの調査によると、セキュリティ専門家の87%が何らかの形でAIサービスを利用しています。次の図に示すように、AIの導入は敵対的な操作の侵入口になり得ます。
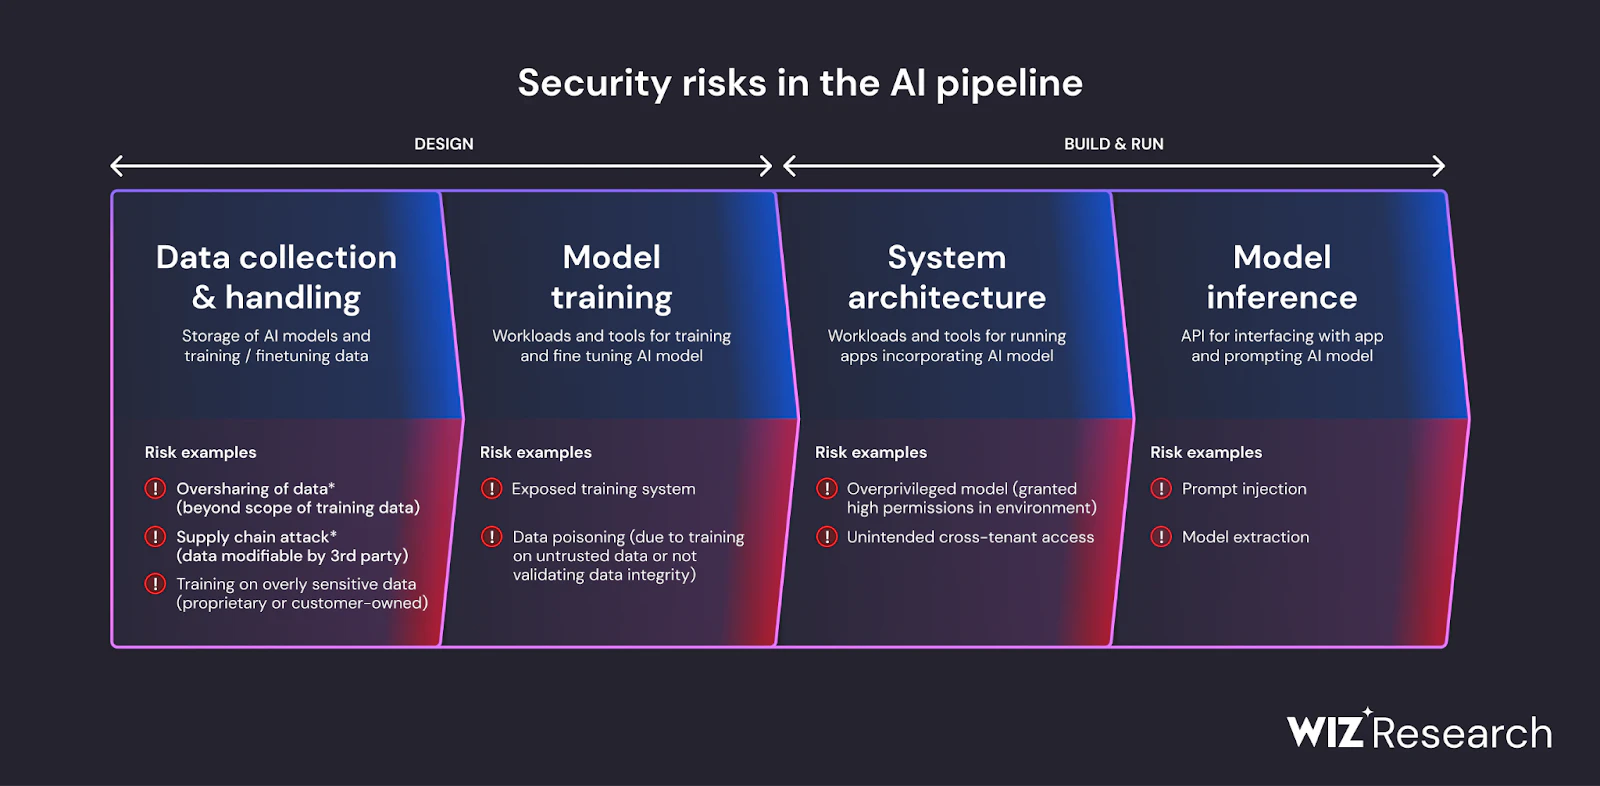
最も危険な敵対的AI攻撃は、明らかな障害を引き起こすものではありません。検知を回避しながら、時間をかけてmodelの完全性を損なう巧妙な操作こそが危険です。攻撃者はアラートを発生させずにガードレールを回避するため、侵害されたmodelが本番環境に到達し、検知されないまま稼働し続けます。
敵対的AIの特性とリスクを組織が詳しく理解できるよう、MITREはAIシステムに対する敵対的脅威の全体像をまとめたAdversarial Threat Landscape for Artificial Intelligence Systems(ATLAS)を公開しました。MITRE ATLASは、悪意のあるアクターがAIシステムの攻撃に用いる155の手法と52の事例研究をまとめた包括的なナレッジベースです。敵対的AIのさまざまな種類や戦術に対する防御を固めるうえで役立ちます。
敵対的AIにはどのような種類がありますか?
敵対的AI攻撃は、攻撃者が持つ知識に応じて大きく2つのカテゴリーに分けられます。
ホワイトボックス攻撃(White box attacks):攻撃者は、標的modelのアーキテクチャ、training datasets、パラメーターを詳細に把握しています。内部関係者並みのアクセスにより極めて精密な攻撃が可能になる一方、相当な偵察活動か内部からのアクセスが必要です。
ブラックボックス攻撃(Black box attacks):攻撃者はmodel内部への直接の可視性を持たず、入出力の挙動を観察して脆弱性を推測する必要があります。標的システムへのAPIアクセスさえあれば実行できるため、実際にはこちらのほうが一般的です。
現実の敵対的AIインシデントの多くはブラックボックス攻撃です。脅威アクターが用いる手法は、その目的、攻撃の種類、被害者のインフラストラクチャによって異なります。
防御側は、攻撃者が外部からmodelを探索できる前提で防御を設計する必要があります。そのうえで、AI lifecycleのさまざまな段階を狙う具体的な攻撃の種類に備えてください。
回避攻撃(Evasion attacks):攻撃者は、人間から見た内容の意味を変えずに入力を改変し、誤分類を引き起こします。回避攻撃には、特定の誤った出力を狙う標的型と、どのような誤分類でも攻撃者の目的を果たせる非標的型があります。
ポイズニング攻撃(Poisoning attacks):攻撃者は不正確で悪意のあるデータをtraining datasetsに注入します。場合によっては数十件のtrainingサンプルを操作するだけでシステムの学習プロセスに影響を与え、その後の自律的な判断やoutputsを左右できます。
転移攻撃(Transfer attacks):サイバー犯罪者は特定の被害者向けに敵対的AIのmodelを設計し、そのmodelを使って他の潜在的な標的のAI・MLシステムを侵害します。
モデル抽出攻撃(Model extraction attacks):脅威アクターは所有権のある機械学習アルゴリズムを盗み、違法な複製を短期間かつ低コストで作成します。
ビザンチン攻撃(Byzantine attacks):脅威アクターは、分散型MLシステムを構成するさまざまなmodelやコンポーネントに、操作的で矛盾したデータや入力を与えてシステムを機能不全に陥らせます。
トロイの木馬型AI攻撃(Trojan AI attacks):悪意のあるアクターは、training段階でAI・MLのmodelにトリガーを仕込みます。その結果、AIモデルはほとんどの場合正常に動作し、トリガーが作動したときにのみ攻撃を本格的に開始します。
モデルインバージョン攻撃(Model inversion attacks):脅威アクターはAI・MLのmodel outputsを分析し、training datasetsに含まれる詳細を推測します。これは通常、脅威アクターがtraining datasetsにアクセスできない状況で発生します。
メンバーシップ推論攻撃(Membership inference attacks):脅威アクターはAI・MLのmodelを調べ、個人や組織に関する悪用可能な機密情報がtraining datasetsに含まれているかどうかを見極めます。
敵対的AI攻撃はどのような仕組みで行われますか?
標的の機能を回避しようとする従来の多くのサイバー脅威とは異なり、敵対的AI攻撃はAIが本来持つ機能を武器にします。AIシステムはtraining datasetsとpromptに基づいて自律的に判断し、outputsを生成します。敵対的AI攻撃が悪用するのは、まさにこの仕組みです。
敵対的AI攻撃は通常、次のような段階を経て進行します。
偵察:攻撃者は標的のAIシステムを調査し、modelのアーキテクチャ、ガードレール、基盤となるインフラストラクチャの弱点を特定します。手法には、公開されている研究の調査や、APIを通じた探索によるmodel挙動のリバースエンジニアリングなどがあります。
入力の作成:攻撃者は標的システムに関する知識をもとに、特定の脆弱性を突くよう調整した悪意のある入力を設計します。こうした入力は、不正検知、画像認識、自然言語処理など、精度が重要なシステムを標的にします。
悪用:攻撃者は作成した入力を送り込み、modelの挙動を損ないます。影響は、気付かれないほど微妙なoutputsの操作から、業務や評判に打撃を与える大規模な障害まで多岐にわたります。
エスカレーション:防御側が原因の把握に追われている間に、攻撃者はその混乱に乗じてlateral movementを行ったり、さらなる脆弱性を悪用したり、AIが生成した偽情報を拡散したりします。
敵対的AI攻撃は、開発からデプロイまで、AI・MLのmodelが通るすべての工程に影響を及ぼし得ることを念頭に置いてください。
敵対的AIの実例
敵対的AI攻撃のさまざまな種類を確認したところで、実際の事例をいくつか見ていきましょう。
1. MadRadar
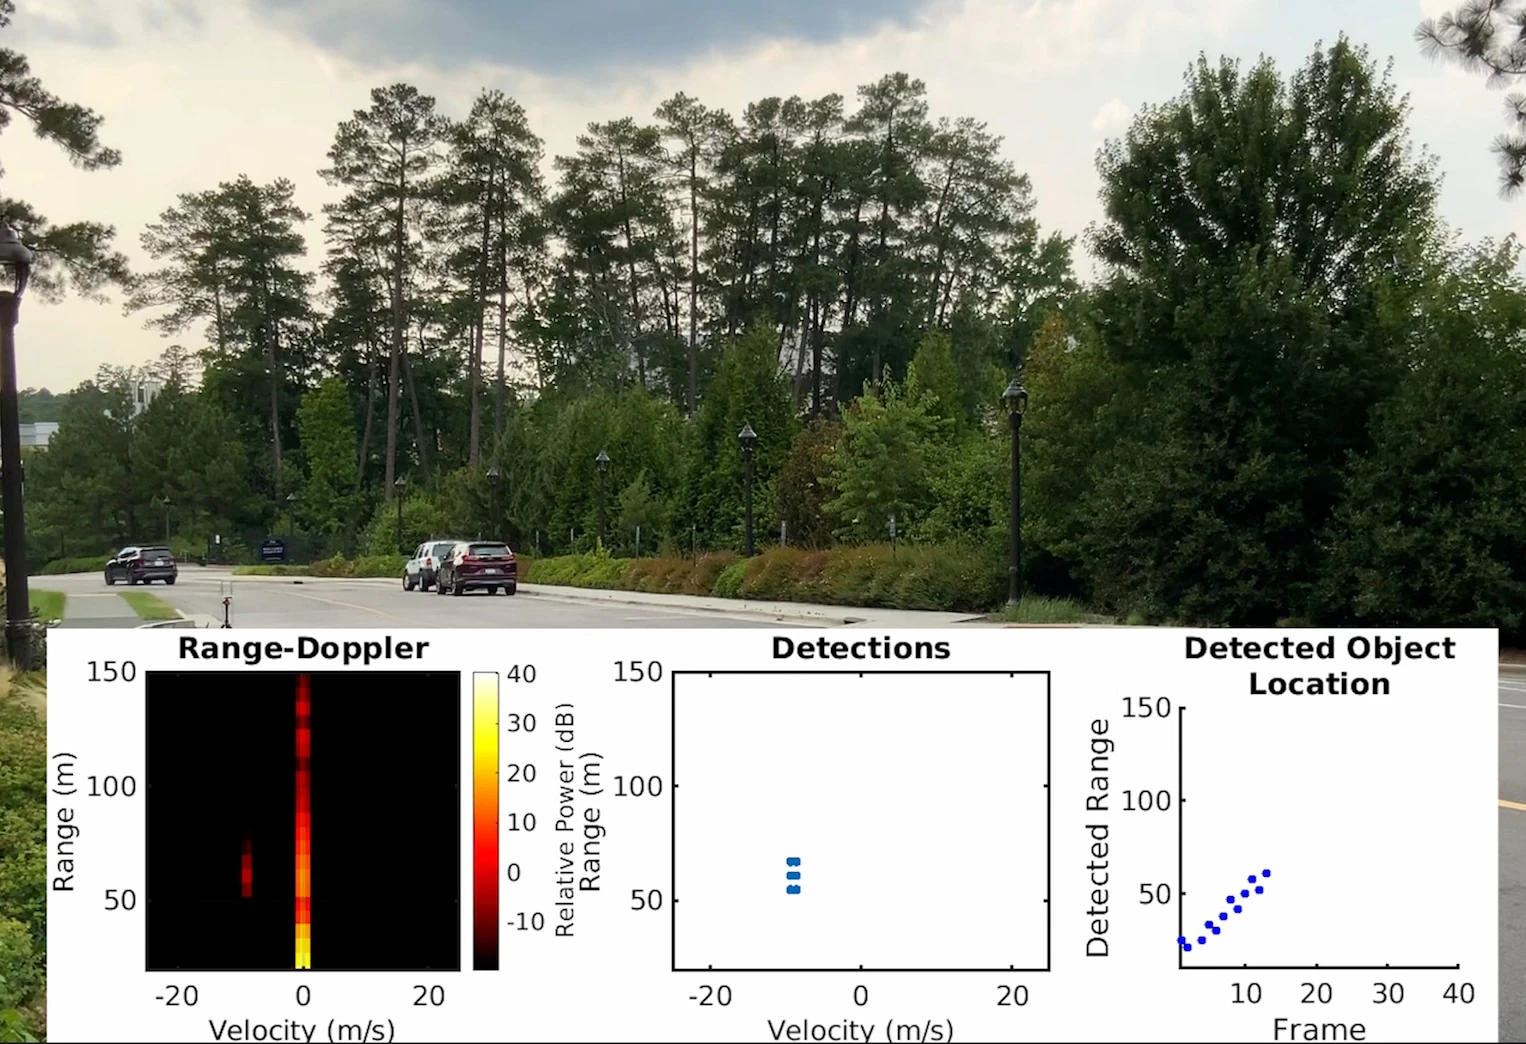
デューク大学のエンジニアは、自動運転車のレーダーシステムをハッキングし、存在しない車を認識させるhallucinationを引き起こしました。ハッカーが車両に幻の車を認識させるシナリオが現実になれば、重大な事故につながるおそれがあります。
2. GoogleのSearch Generative Experience
悪意のあるoutputsが生成された正確な理由は明らかになっていませんが、Googleの新しいAI検索エンジンは、マルウェアを含む悪意のあるリンクへユーザーを誘導することがあり、何らかの敵対的AIの関与がうかがえます。この事例で最も懸念されるのは、AI検索エンジンが危険な情報を極めて現実的かつもっともらしく提示する点です。
3. Microsoft 365 CopilotのEchoLeak
Aim Labsは、Microsoft 365 Copilotにprompt injection攻撃へのセキュリティ対策を回避できる脆弱性を発見し、EchoLeakと名付けました。この脆弱性を悪用すると、攻撃者は1通のメールだけで機密データにアクセスできます。この事例により、AIエージェントやコパイロットに潜む脆弱性が浮き彫りになりました。
敵対的AIのリスクを低減するベストプラクティス
敵対的AIを防御するには、多層的な制御に加え、training datasetsの完全性からランタイムモニタリングまで、AI lifecycle全体で影響を軽減する手法が必要です。
最も安全な構成を実現するには、次のベストプラクティスに従ってください。
24時間365日のモニタリングと検出
AIシステムには、従来のインフラストラクチャのモニタリングを土台にした継続的モニタリングが必要です。具体的には、model入力のパターンから異常を追跡し、outputsの分布にdriftがないかを確認し、AIの挙動をクラウドのアクティビティログと関連付けます。
異常なクエリ量やベースラインmodelから逸脱したoutputsなど、モニタリングで不審なパターンが見つかった場合、セキュリティチームには迅速に調査するためのcontextが必要です。そのためには、AIのtelemetryを、modelが稼働する基盤のクラウドインフラストラクチャと結び付けることが重要です。
Adversarial trainingを実装する
Adversarial trainingは、training過程でmodelを潜在的な攻撃にさらし、操作を認識して抵抗できるようにする手法です。多くの場合、既知の手法で敵対的な入力を生成してtraining datasetsに追加し、拡張したdatasetsでmodelのtrainingをやり直します。
ただし、この方法でtrainingしたmodelは、通常の入力に対する精度がわずかに低下する場合があります。また、adversarial trainingで防げるのはmodelに与えた種類の攻撃に限られるため、training datasetsを継続的に更新する必要があります。
AI・ML開発環境を強化する
AI・ML開発環境の重要なコンポーネントを補強することで、企業はAIセキュリティ態勢全体を強化できます。主なセキュリティ対策としては、training datasetsのサニタイズや、より堅牢なMLアルゴリズム(ビザンチン耐性アルゴリズムなど)の開発・活用が挙げられます。さらに、AIを使ってMLアルゴリズムを作成・検証することで人為的ミスを減らし、AI pipelineにできるだけ早い段階でセキュリティを統合することも有効です。
AI/生成AI(GenAI)サービスのアーキテクチャを最適化する
企業は、生成AIを組み込んだサービスにどのテナントアーキテクチャの方式を採用するかを慎重に検討する必要があります。生成AIのテナントアーキテクチャには、マルチテナント、シングルテナント、ハイブリッドの3つの基本的な種類があります。
生成AIサービスでは、一部のコンポーネントを複数のテナントに分散させ、その他のコンポーネントには専用テナントを割り当てることが推奨されます。これは、大規模な被害を抑え、迅速なインシデント対応を実現するための重要な手段です。
入力の前処理
modelに入力する前に前処理を施し、敵対的な摂動を検出・軽減してください。特徴量スクイージング(Feature squeezing)は入力特徴量の精度を下げて敵対的なnoiseを取り除き、入力変換(Input transformation)はランダムなリサイズやパディングなどの変換を加えて、巧妙に作成された敵対的な入力を無効化します。さらに異常検出(Anomaly detection)では、統計的手法を用いて想定されるパターンから大きく外れた入力を特定します。
AIセキュリティ態勢管理(AI-SPM)を導入する
敵対的AI攻撃からビジネスを守るには、AI-SPMを中核機能として備えた統合型のクラウドセキュリティツールを選択してください。
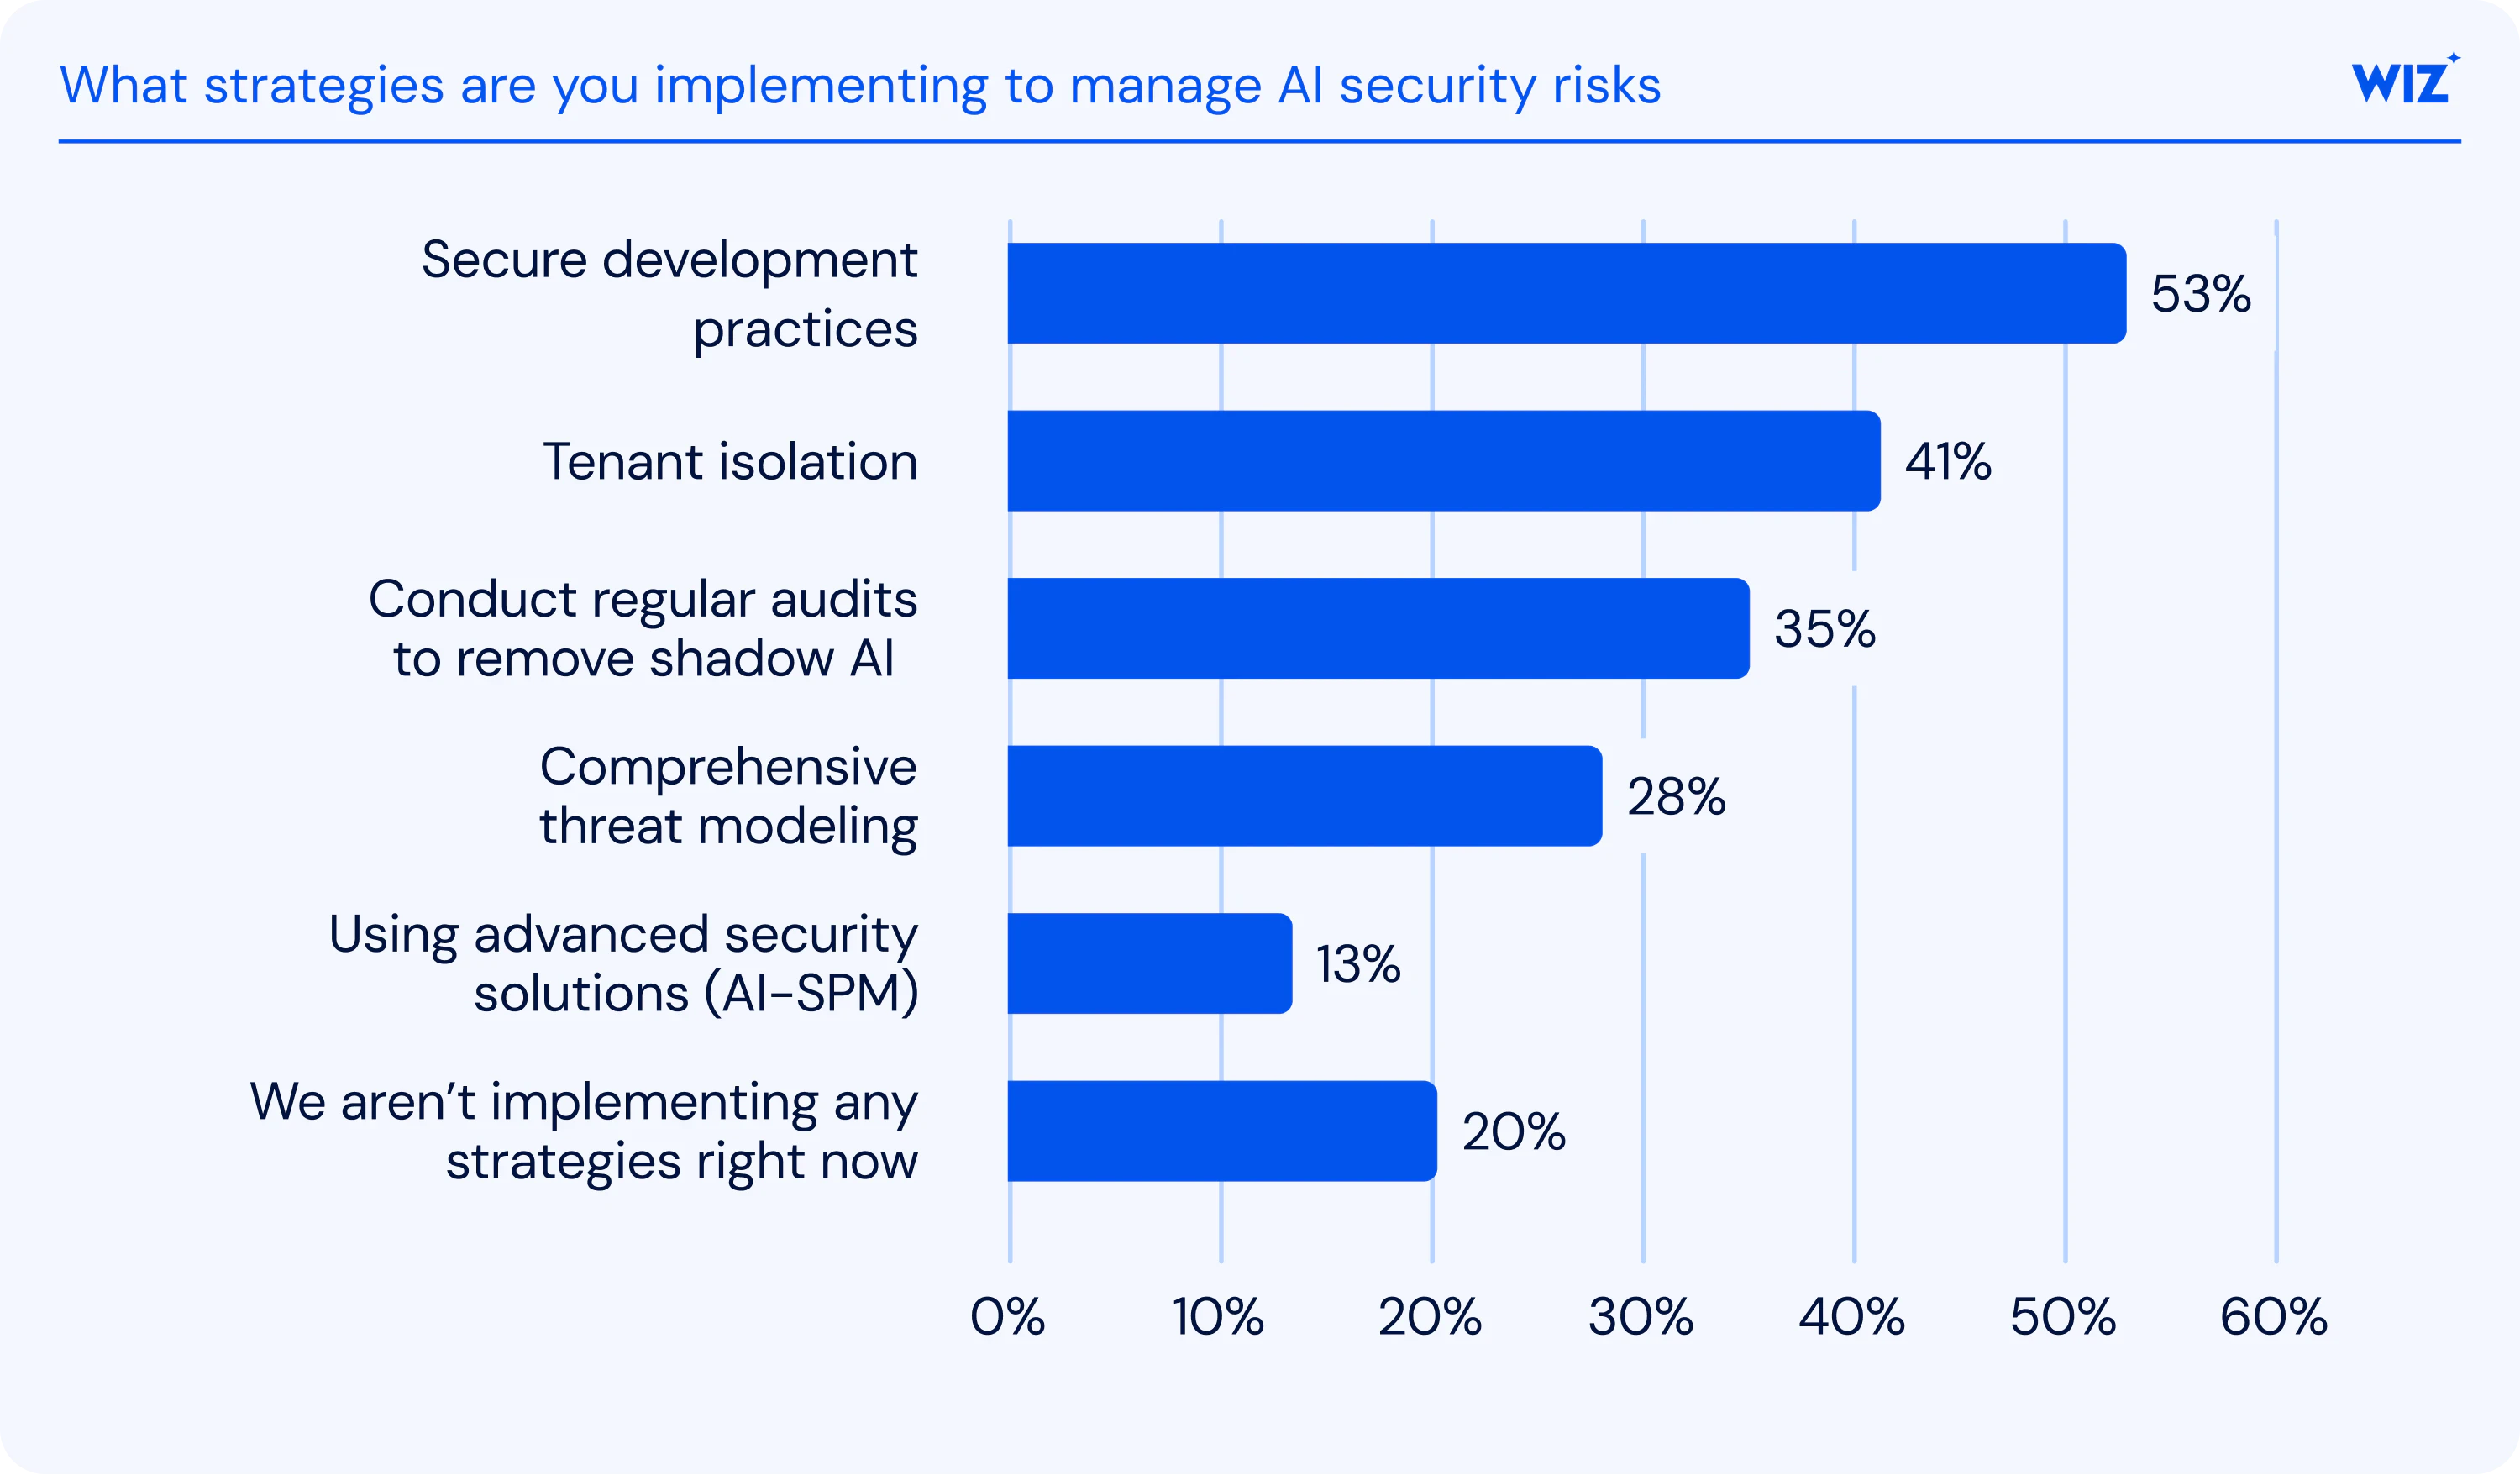
Wizの『AIセキュリティ準備状況レポート(AI Security Readiness report)』によると、87%の組織がAIサービスを積極的に利用している一方で、AI-SPMソリューションを導入している組織はわずか13%にとどまります。しかし、堅牢なAI-SPMツールがあれば、敵対的AI攻撃が社内のAI導入や活用に及ぼす影響はほとんどなくなります。
Wizが敵対的AIの脅威への対処を支援する方法
敵対的AIのリスクは単独で存在するものではありません。modelの脆弱性、クラウドのmisconfiguration、over-permissionedなアイデンティティが組み合わさって生じます。AI assetとそれを支えるインフラストラクチャを結び付ける可視性があれば、こうした攻撃を防御できます。
Wiz AI-APPはこの統合されたビューを提供し、敵対的AIのリスクが本番環境に到達する前にチームが検出・軽減できるよう支援します。
包括的な可視性
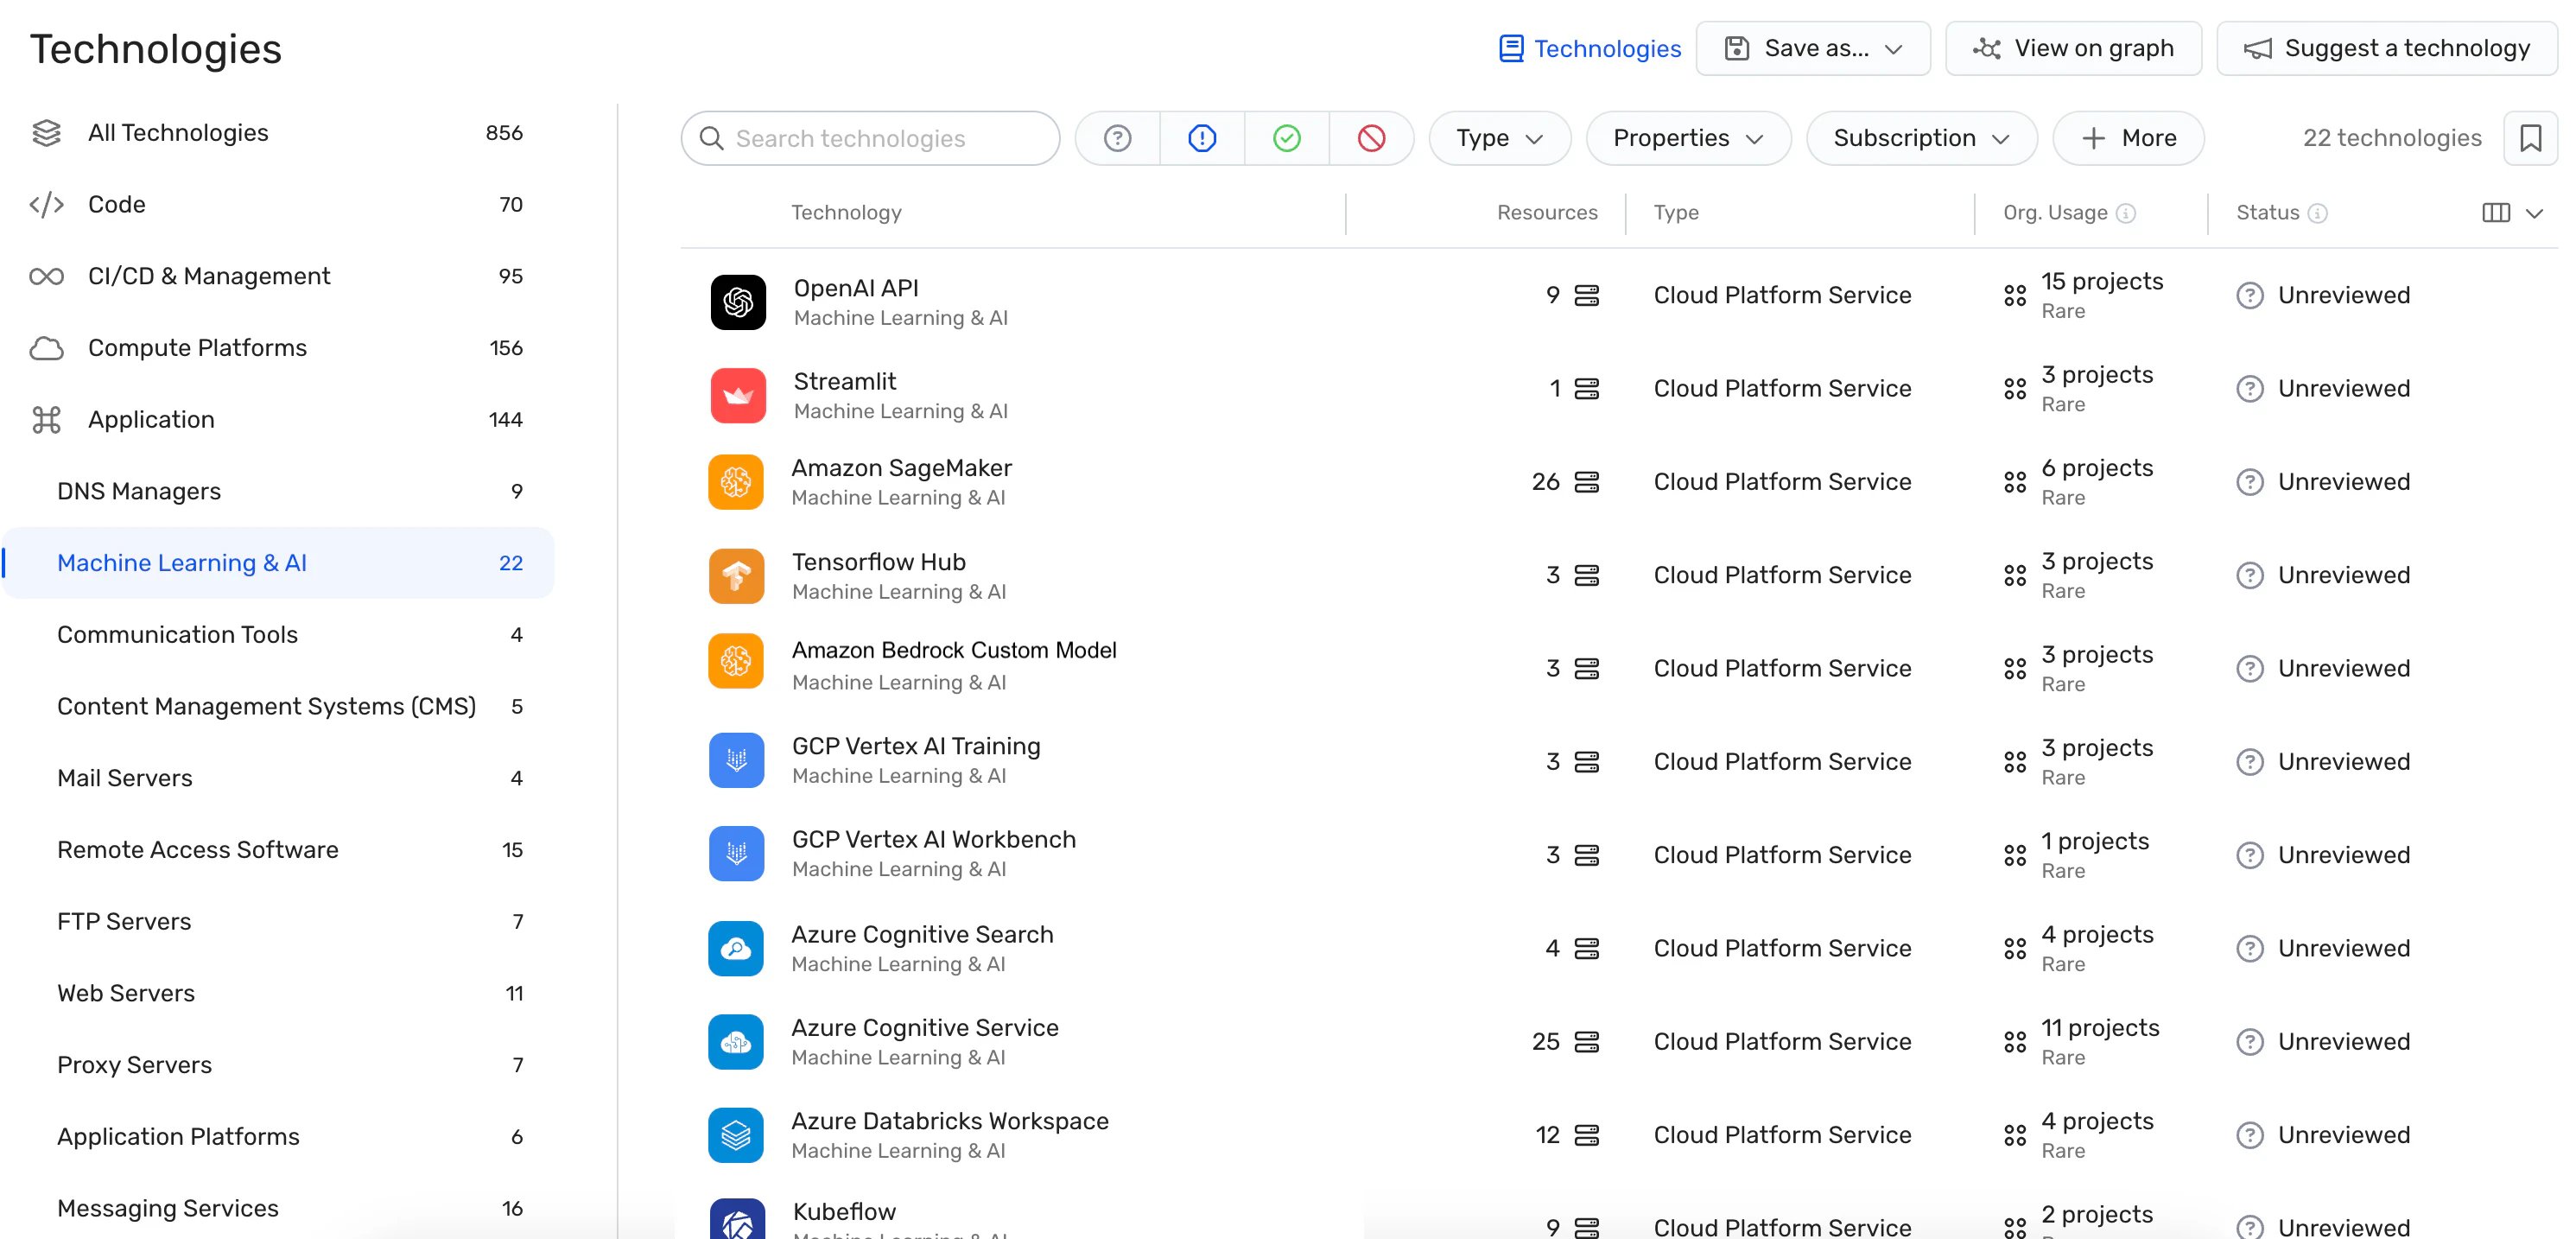
Wiz AI-APPは、agentlessなAI-BOM(AI版部品表)機能により、AI pipelineとresourceのフルスタック可視性を提供します。これにより、環境全体で使われているAIサービス、テクノロジー、SDKをすべて確認できます。さらに、適切な管理を経ずに導入された可能性のあるシャドーAI(Shadow AI)プロジェクトを検出し、AIの攻撃対象領域を全体的に把握できます。
misconfigurationの検出
Wizは組み込みのルールを用いてOpenAIやAmazon BedrockなどのAIサービスのmisconfigurationを検出し、AIセキュリティのベストプラクティスを徹底します。さらに、コードとしてのインフラストラクチャ(IaC)のスキャンを通じて、セキュリティチェックを開発pipelineにも拡張します。
attack path分析
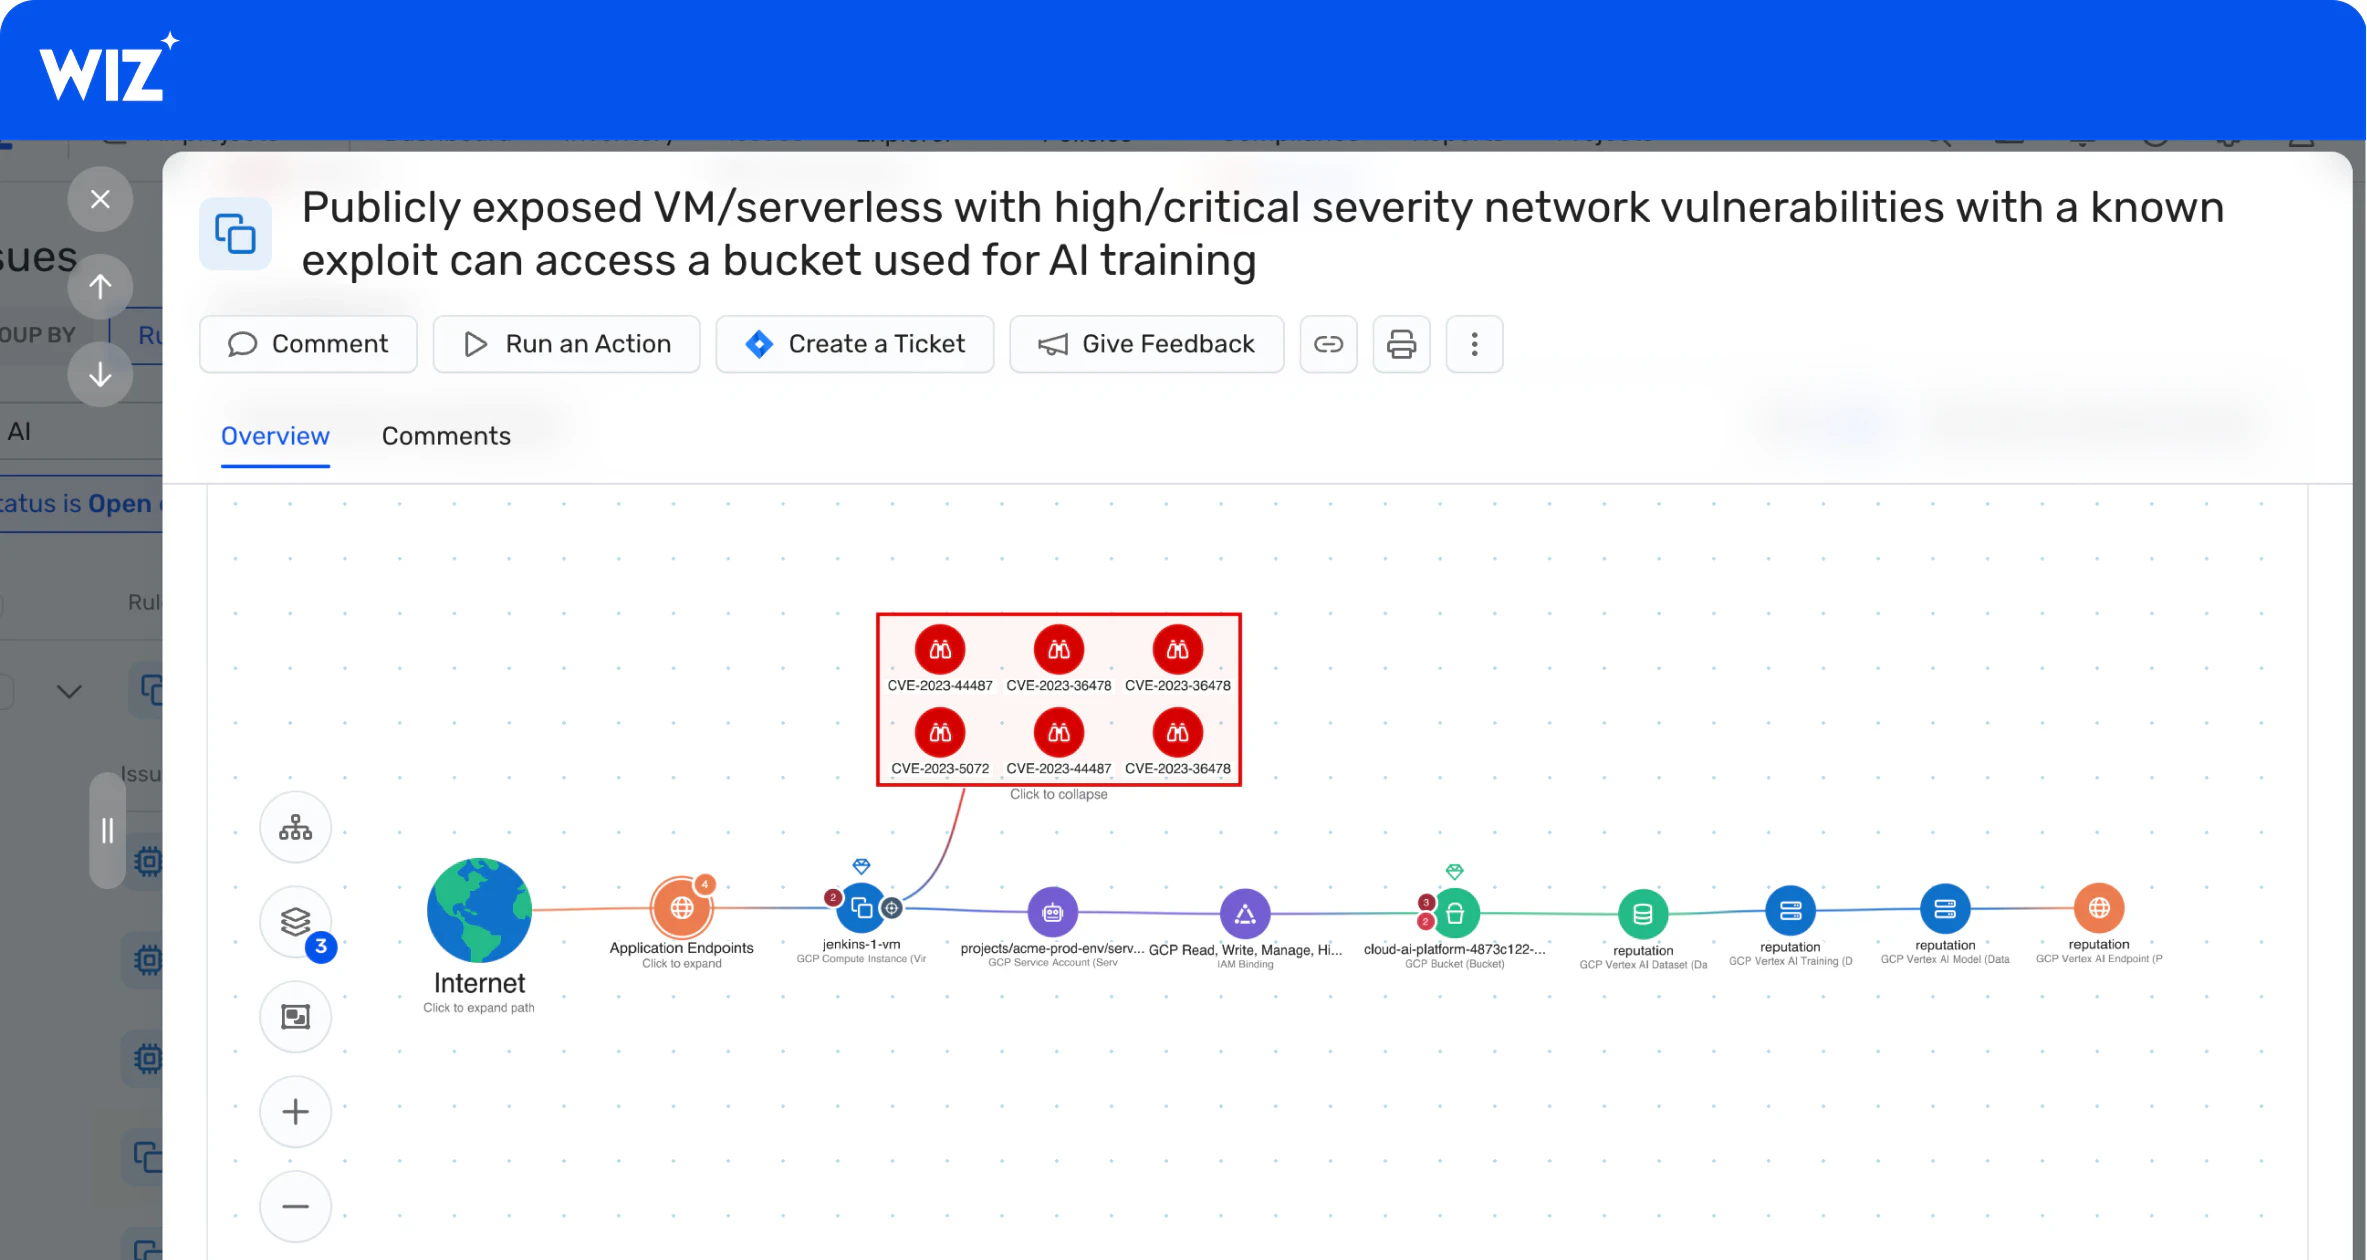
Wiz AI-APPはattack path分析機能をAI resourceにも拡張します。これにより、組織はAIモデルやAIサービスへの潜在的なattack pathを検出し、脆弱性、アイデンティティ、ネットワークexposure、データアクセスなどにまたがるリスクを評価できます。さらに、重大なAIのattack pathを悪用される前に先回りして排除できます。
AI向けのデータセキュリティ
データポイズニング(Data poisoning)をはじめとするtraining datasetsへの敵対的攻撃から保護するため、Wizは機密性の高いAIのtraining datasetsを自動で検出します。あわせて、AI向けのout-of-the-boxなデータセキュリティ態勢管理(DSPM)コントロールと、データ漏洩リスクに対する修復ガイダンスも提供します。
敵対的AIのリスクを、AIモデルだけでなくクラウド環境、アイデンティティ、データアクセスとの関係から把握する方法を、Wizでご確認ください。 Wizのデモを見る