
データポイズニングとは
データポイズニングは、AIおよびMLモデルのtraining datasetを標的にしてmodelの挙動を劣化させたり制御したりする、敵対的攻撃(Adversarial attacks)の一種です。攻撃者は新しいデータの追加、既存データの改変、一部データの削除などを通じて、誤解を招く情報や誤った情報をtraining datasetに紛れ込ませ、modelの理解をゆがめようとします。
金融、医療、自律システムなど、AIによる意思決定を活用する業界は、modelの誤動作による影響が大きいため、ポイズニングの主な標的になりやすい傾向があります。
data poisoning attackの潜在的な影響
データポイズニングにより、データに依存するシステムの信頼性と有効性は大きく低下する可能性があります。Wizの『クラウドにおけるAIの現状(State of AI in the Cloud)』レポートによると、「クラウド環境の70%がAIサービスを利用している」とされています。
AIや大規模言語モデル(LLM)に対するこうした攻撃が及ぼし得る影響は、次のとおりです。
| LLMの課題 | 影響 |
|---|---|
| チームがポイズニングされたデータを意思決定に使用する。 | 悪意のあるデータはバイアスを持ち込み、ポイズニングされたdatasetに基づく結果や判断をゆがめます。たとえば、不正確なデータや偏ったデータを金融modelに取り込むと、誤った投資判断につながり、組織の財務の安定性に悪影響を及ぼす可能性があります。同様に、医療分野で偏ったデータを使うと、診断や治療方針の推奨が不正確になり、患者の健康を損なうおそれがあります。 |
| 組織で適合率と再現率が低下する。 | ポイズニングされたデータは、予測modelの全体的な正解率、適合率、再現率を低下させます。その結果、outputsの信頼性が下がってエラー率が上昇し、システム全体が損なわれる可能性があります。マーケティング分野であれば誤った顧客層に注力してしまう、サイバーセキュリティ分野であれば実際の懸念を見落としてしまう、といった事態が考えられます。modelの有効性が下がればその価値も損なわれ、大きな損失につながりかねません。 |
| セキュリティチームがシステム障害や悪用のリスクに直面する。 | データポイズニングはバックドア攻撃の足がかりになります。攻撃者がdatasetにトリガーを仕込むことでシステムが予測不能な挙動を示すようになり、セキュリティ対策の回避や、悪意のある目的でのシステムのoutputsの操作が可能になります。 |
重要インフラでは、攻撃者がバックドア攻撃を通じて持ち込んだ脆弱性が深刻な結果を招く可能性があります。たとえば、ハッカー集団LAPSUS$によるAIモデルのデータへのポイズニングの試みでは、システムへのアクセスを得るためのバックドア設置を含む複数の手口の組み合わせが用いられました。
data poisoning attackの仕組み
データポイズニングは、主に次のような攻撃によって発生します。
偽のデータの注入:攻撃者は架空のデータポイントや欺瞞的なデータポイントを追加したり、prompt injectionを行ったりしてdatasetを操作し、不正確なtrainingや予測を引き起こします。たとえば、レコメンドシステムに偽の顧客評価を紛れ込ませれば、製品の品質に対する人々の評価を変えられます。
既存データの改変:この攻撃では、攻撃者は新しいデータを追加せずに本物のデータポイントを書き換え、エラーを持ち込んでシステムを誤った方向に導きます。たとえば、金融取引データベースの値を改変すれば、不正検知システムを無力化したり、累積損益の計算を狂わせたりできます。
データの削除:重要なデータポイントを削除すると欠落が生じ、modelの汎化性能が低下します。こうした欠落は、エッジケースでのmodelのパフォーマンスに影響することが多くあります。エッジケースこそ、多くのセキュリティシステムやセーフティクリティカルなシステムが検出すべき状況です。たとえば、攻撃データが失われると、サイバーセキュリティシステムが特定のネットワーク攻撃を検知できなくなる可能性があります。
標的型と非標的型のdata poisoning attacks
標的型のdata poisoning attacksでは、悪意のある攻撃者は特定の入力をシステムに誤分類させるなど、特定の結果を狙います。バックドア攻撃はこのカテゴリーに属し、特定のトリガーによってシステムがあらかじめ定められた挙動を示します。たとえば、特定の変装をした侵入者を無視するプログラムが、防犯カメラシステムに仕込まれるケースが考えられます。
一方、非標的型のdata poisoning attacksは、破損したデータや誤解を招くデータをtraining datasetに注入し、機械学習modelの性能を損ないます。これらの攻撃はmodelの正確性と信頼性を低下させ、outputsに誤りを生じさせます。
たとえば非標的型のdata poisoning attackでは、攻撃者がスパムフィルターのtraining datasetにランダムなnoiseや誤ったラベルのメールを追加する可能性があります。その結果、modelが重要なメールやチケットを誤分類し、企業の業務フローが滞るおそれがあります。
実際に起きたデータポイズニングの2つの事例
データポイズニングの脆弱性は、実際にはどのような形で現れるのでしょうか。ここでは、データポイズニングの脅威に関する2つの実例を紹介します。
研究者が発見したAIのデータポイズニング脆弱性
2024年、テキサス大学の研究者がAIシステムにおけるデータポイズニングの脆弱性を発見しました。後にConfusedPilotと名付けられたこのプロジェクトで、研究者はMicrosoft 365 Copilotなどのmodelを調査し、検索拡張生成(Retrieval-Augmented Generation)に焦点を当てました。仮説を検証するため、AIが参照するドキュメントに悪意のあるデータを追加しました。
ユーザーが情報を検索すると、AIはポイズニングされたデータを使用し、不正確で誤った情報を返しました。研究者がドキュメントを削除した後も、クエリは誤解を招くoutputsを返し続けました。
ConfusedPilotは、悪意のあるソースドキュメントを削除した後でも、ポイズニングされたデータがいかに容易にhallucinationを引き起こすかを実証しました。企業のAIへの依存が高まるにつれ、こうしたデータポイントは業務やデータの完全性を損なう要因になり得ます。
Hugging FaceとWizによるデータpipelineポイズニングの阻止
WizのリサーチャーはHugging Faceと協力して重大なリスクを調査する中で、脅威アクターがHugging Faceのplatformに悪意のあるデータをアップロードできる脆弱性を発見しました。攻撃が発生し、組織が悪意のあるデータを取り込んでいた場合、自社のAI pipelineが侵害される可能性がありました。この種のデータポイズニングは、組織のインフラ全体にわたる操作を可能にします。
Wizは自社platformの検知機能を統合し、顧客環境内のAIコンポーネントを監視することで、将来の問題を軽減しました。このソリューションは不審な挙動にフラグを立て、AI-SPMなどの機能を通じて完全なvisibilityも提供しました。
データポイズニングを防ぐための手法

データポイズニングへの防御には、包括的なアプローチが欠かせません。堅牢なデータ管理と高度な検知手法を組み合わせることで、脅威アクターへの対抗力は大きく高まります。
具体的な方法は次のとおりです。
堅牢なデータ検証を実装する
厳格な検証手順により、汚染されたデータの混入を防げます。主な戦略は次のとおりです。
データの来歴(Data provenance):データの来歴と履歴を監視することで、有害なおそれのあるデータソースを特定して除外できます。信頼できるデータソースを使うこと自体が、データポイズニングの防止につながります。
交差検証(Cross-validation):複数のデータサブセットでmodelを検証すると、異常や不整合が明らかになり、汚染されたデータへの過学習の可能性を下げられます。これにより、modelのパフォーマンスを想定される改善幅の範囲内に保てます。
training datasetと挙動に基づいて異常を監視する
異常検知を自動化することで、改ざんのsignalとなり得る異常なパターンを見つけてフラグを立てられます。主な戦略は次のとおりです。
dataset内の外れ値検出:統計的手法やDBSCANなどのクラスタリングアルゴリズムを使い、異常なデータポイントを特定します。これにより、操作されたデータがmodelを汚染する前に発見できます。
modelの挙動の追跡:modelのoutputsをベースラインと比較するレビューを継続的に実施します。modelの適合率やパフォーマンスに予期しない変化があれば、ポイズニングが発生した兆候かもしれません。カナリアテストを活用すると、こうした問題を早期に発見できます。
データポイズニングを迅速に検知するための手法
インシデントを迅速に検知できれば、データポイズニングによる組織への被害を抑えられます。問題をリアルタイムで是正するには、次の対策を実践してください。
異常検知アルゴリズムを導入する
高度なアルゴリズムを使うと、ポイズニングの試みを示すデータの異常を発見できます。主な戦略は次のとおりです。
統計的手法:データ操作を示唆する異常や傾向を見つけます。たとえばクラスタリング手法は、平均値から大きく外れたデータポイントを特定します。
MLベースの検知:追加の防御層として、MLモデルが汚染されたデータに共通するパターンを特定します。機密データを直接扱うmodelの指標や機能を継続的に把握するうえで役立ちます。
定期的なシステム監査を確立する
定期的なシステム監査により、データの信頼性を確保し、データポイズニングの兆候を早期に把握できます。主な戦略は次のとおりです。
パフォーマンス監視:検証用datasetでシステムのパフォーマンスを継続的に追跡すると、データポイズニングの兆候となる正解率、適合率、再現率の異常な低下を特定できます。
行動分析:特定のテストケースやエッジケースでシステムの挙動を分析すると、データポイズニングによる脆弱性が明らかになります。こうした脆弱性は、システムが要求していない未確認のソースからデータを取り込んだときに生じます。
データの完全性は、多くの業界、特にAIの導入が急速に進む業界において、意思決定を左右する最も重要な要素であり続けています。そのため、競争優位を維持し、データ駆動型システムの信頼性とセキュリティを確保するには、継続的なイノベーションと連携が欠かせません。
data poisoning attack発生後の迅速な対応計画の実行
汚染されたデータポイントが入り込んできたら、どうすればよいのでしょうか。セキュリティチームには、被害の防止、軽減、修復までをカバーする検出・是正計画が必要です。
計画を実行に移すための5つのステップは次のとおりです。
1. リアルタイムの監視とアラートを実装する
最初の防御線は継続的な監視です。セキュリティチームはautomationとアラートを活用し、データpipelinesとAIモデルを保護・監視できます。Wizのような高度な監視ソリューションは、異常の検知やデータの検証に加え、優先度とcontextを踏まえたリスク評価も提供するため、最も重大な脅威に絞って対応できます。
リアルタイムの自動レビュー、カスタマイズしたアラートしきい値、インシデント対応プロセスとのアラート連携を取り入れ、今すぐ監視と検知を強化してください。
2. クリーンなdatasetまたはmodelの状態にロールバックする
データポイズニングを検知した場合は、業務への支障を避けるため、システムを健全な状態へ迅速に戻す手段が必要です。
datasetをクリーンに保つ最も効果的な方法は、training datasetとmodelのチェックポイントを定期的にバックアップしておくことです。クリーンな状態を維持するには、コードにはGit、データにはDVCといったバージョン管理システムを活用できます。自動ロールバックスクリプトも迅速な復元に役立ち、ダウンタイムを最小限に抑えられます。
DATASETとMODELのバージョン管理されたバックアップを自動でスケジュールし、DVCなどのツールでMODELと再現可能なデータを管理したうえで、ロールバック手順をシミュレーションして準備状況をテストしてください。
3. インシデント調査と根本原因分析を実施する
datasetとmodelを正常な状態に戻したら、何が起きたのか、どの脆弱性が攻撃を許したのかを特定します。そのためには、データの系統(データフロー)と追跡に注目し、ポイズニングが発生した箇所を突き止めてください。
たとえばWizのAI-SPMを使えば、データフロー、modelのリビジョン、attack pathを可視化できます。ログやデータの変更履歴を調べることで、侵入口を特定できます。
追跡の手順を進める際は調査結果を記録し、インシデント対応計画の更新に活かしてください。
4. データを再検証し、改めてデータサニタイズを実施する
是正作業はシステムをロールバックして終わりではありません。次は情報を改めて精査する段階です。OpenRefineやTrifacta Wranglerなどのツールを使えば、不審なデータポイントの除去を自動化できます。
新規データと過去のデータの両方に異常検知とクラスタリングのアルゴリズムを適用し、ほかの信頼できる情報源と照らし合わせて情報を交差検証してください。
5. データpipelinesにパッチを適用し、強化する
データを検証したら、セキュリティチームは同様の攻撃の再発を防ぐための新たな手順や調整を講じる必要があります。
まず、データの来歴の追跡を強化し、すべてのデータソースにより厳格なアクセス制御を適用します。次に、抽出・ロード・変換(ELT)のpipelineアーキテクチャでデータを統合してプロセスを一元化し、分断されたプロセスに起因するリスクを減らします。最後に、AI resourceとpipelineに対して監査とpenetration testingを継続的に実施してください。
機密データソースへのアクセスにはLEAST PRIVILEGEを定期的に徹底し、認証情報をローテーションしてください。認証情報が侵害された場合のEXPOSUREを抑え、権限のあるユーザーだけが機密データにアクセスできる状態を保つことで、データポイズニングのリスクを低減できます。
Wiz:データポイズニングのリスクを検知・軽減する最もシンプルな方法
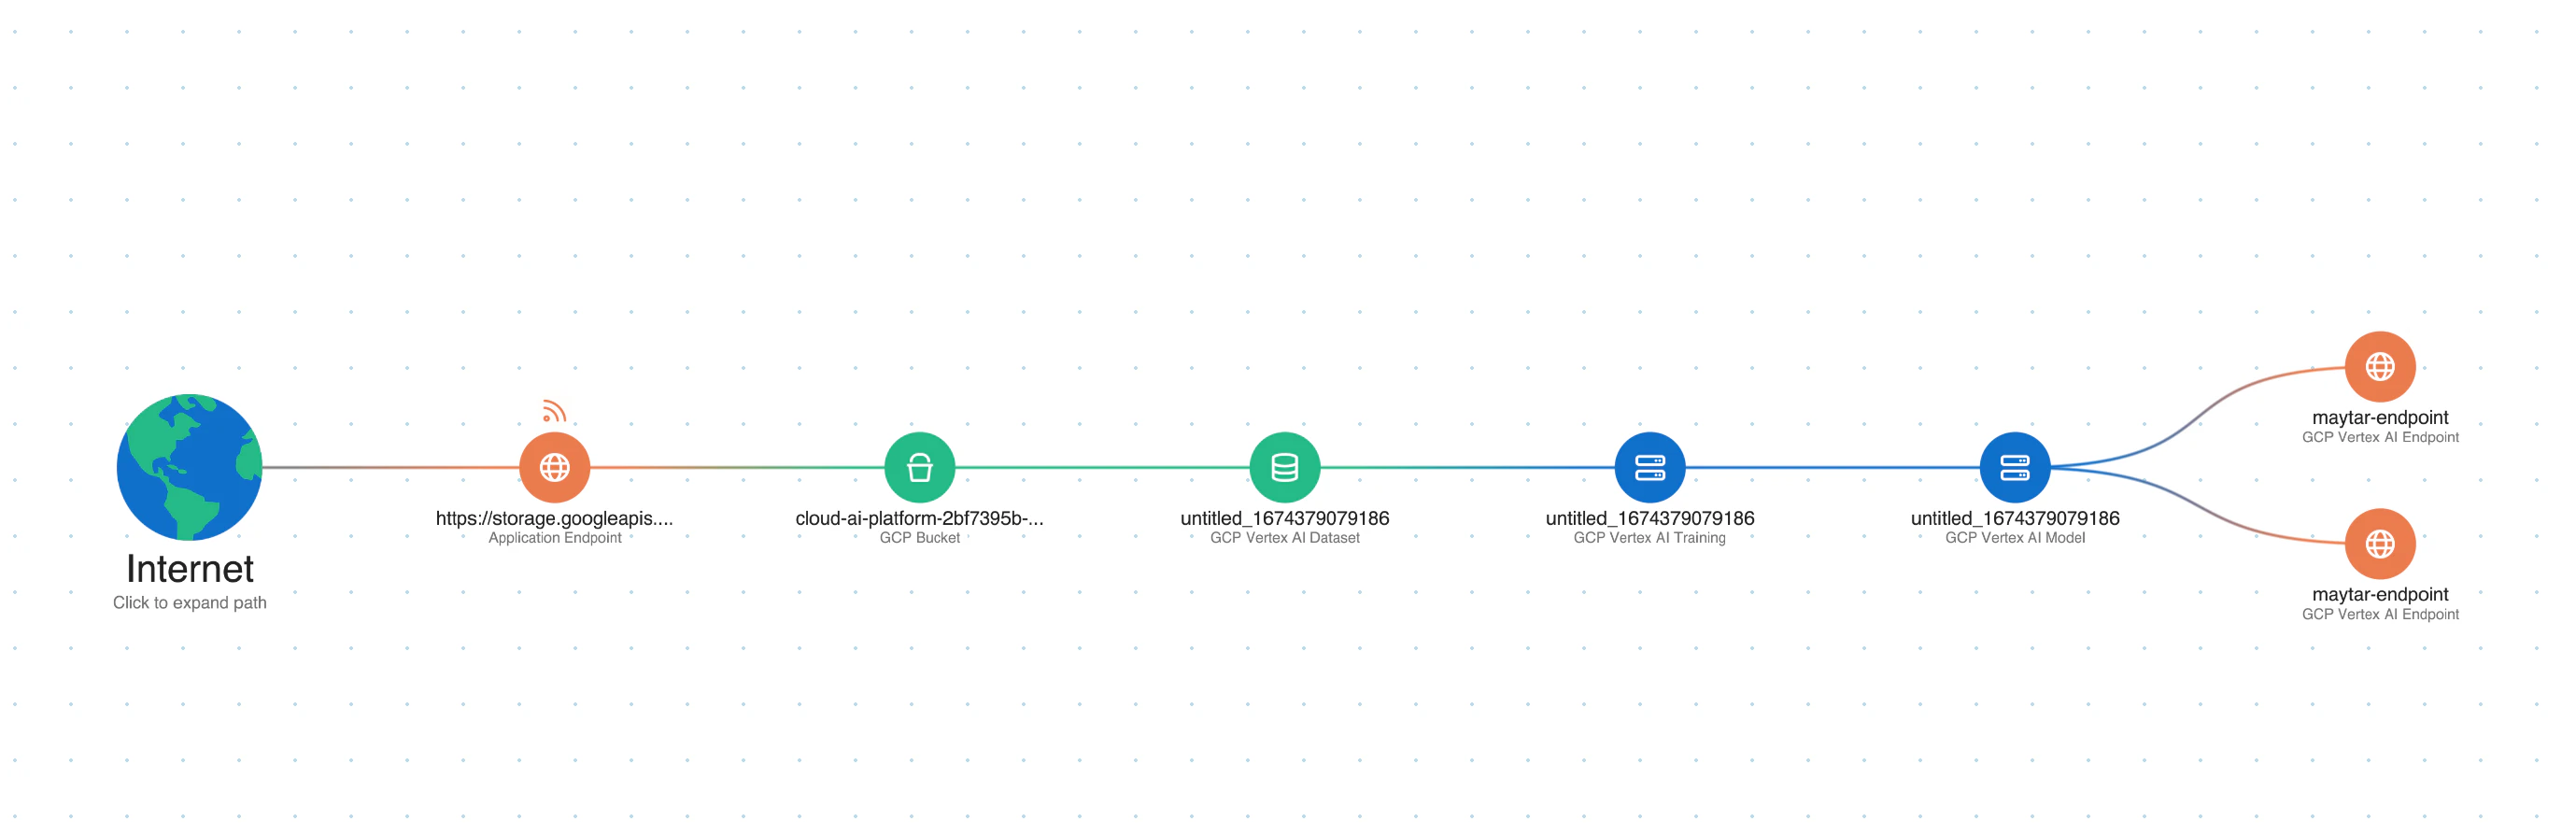
AI-SPMは、AI pipelineを保護し、クラウド環境における関連リスクに対処しながらAIの導入を加速させるための一連の機能です。Wizは2023年、ネイティブなAIセキュリティ機能を提供し、AI-SPM機能を導入した初のクラウドネイティブアプリケーション保護プラットフォーム(CNAPP)となりました。

Wizは、AIシステムにおけるデータポイズニングのリスクを検知・軽減するための機能を複数備えています。
フルスタックのvisibility:WizのAI-BOM(AI版部品表)は、エージェントを導入せずに、AI pipeline、サービス、テクノロジー、ソフトウェア開発キットに対する包括的なvisibilityを提供します。これにより、data poisoning attacksの侵入口となり得る箇所を特定できます。
AIのためのデータセキュリティ:Wizはデータセキュリティ態勢管理(DSPM)の機能をAIに拡張し、training datasetに含まれる機密データを自動検出してデータ漏洩のリスクを特定します。ポイズニングにつながる不正アクセスやtraining datasetの改ざんを防ぐうえで役立ちます。
アタックパス分析(Attack Path Analysis / APA):Wizのアタックパス分析はAIシステムにも対応しており、AIモデルやtraining datasetに至るattack pathを検出できます。これにより、データポイズニングに悪用され得る脆弱性を特定できます。
AIのmisconfiguration検出:組み込みのルールとAIリスク管理によってAIサービスの安全な設定ベースラインを適用し、misconfigurationを検出します。適切な設定は、training datasetやmodelへの不正アクセスの防止につながります。
modelスキャン:Wizのmodelスキャン機能は、データポイズニングの兆候や、侵害されたtraining datasetに起因する予期しない挙動など、AIモデルの潜在的な問題を検出します。
AIセキュリティダッシュボード:WizのCNAPPが提供するAIセキュリティダッシュボードでは、優先順位付けされたリスクのキューを含め、主要なAIセキュリティ課題を一覧できます。AI開発者とセキュリティチームは、データポイズニングの潜在的な脅威をすばやく特定して対処できます。
これらの機能を組み合わせることで、WizのAI-SPMは、training datasetからデプロイ済みのmodelまで、AIインフラ全体にわたるデータポイズニングのリスクを組織がプロアクティブに特定・軽減できるようにします。
データポイズニングのリスクを把握し、AIパイプラインの可視化と保護を進める方法を、Wizでご確認ください。 Wizを実際に見る