
エンタープライズAIとは
エンタープライズAIとは、組織全体でAI技術を活用し、タスクのautomation、意思決定の支援、測定可能なビジネス成果の創出を実現する取り組みです。単一のツールではなく、従業員や顧客がすでに使っているシステムに組み込まれた機能の集合体といえます。
実際には、ERP、CRM、人事システム、supply chainツールといった主要なビジネスplatformにAIが組み込まれます。独立した「AIアプリ」を別途用意するのではなく、既存のワークフローにインテリジェンスを浸透させることで、ユーザーは普段のツールの中でレコメンデーション、予測、automationを利用できます。
エンタープライズAIシステムは基幹ビジネスplatformに組み込まれ、機密データを扱うため、AIセキュリティは基盤となる要件です。エンタープライズAIを保護するには、modelだけでなく、AIシステムが依存するデータpipelines、アイデンティティ、クラウドインフラも守る必要があります。
現代のエンタープライズAIは、主に次の技術で構成されています。
機械学習(ML):過去のデータからパターンを見つけ、需要、解約、不正などを予測します。
自然言語処理(NLP):人間の言語を理解・生成し、文書分析、チャットボット、感情分析を支えます。
コンピュータビジョン:画像や動画を解析し、品質検査や本人確認などに活用されます。
生成AIと大規模言語model(LLM):コンテンツの作成、コードの記述、文書の要約を行い、従業員の「コパイロット」として機能します。
エンタープライズAIは、一般的なサイドプロジェクトよりもはるかに大きな規模で稼働します。modelが数千人のユーザーにサービスを提供し、1日に数百万件のイベントを処理し、複数のリージョンやクラウドにまたがって実行されることも珍しくありません。そのため、高い信頼性、セキュリティ、規制対応のための統制を前提に構築・管理する必要があります。あわせて、明確なデータレジデンシー(data residency)ポリシーとプライバシー保護策を整え、クラウドAIプロバイダー(AWS Bedrock、Azure OpenAI Service、Google Vertex AI)とのshared responsibility modelに基づく責任分界も定義しておくことが重要です。
組織全体におけるエンタープライズAIの活用例
エンタープライズAIは、日々の業務のどこで使われているかを見ると理解しやすくなります。多くのチームは、独立した「AI platform」の画面ではなく、すでに使っているアプリケーションを通じてAIに触れることになります。
オペレーションと業務プロセスのautomationでは、AIが文書を読み取って分類し、人手を介さずに適切な宛先へ振り分けます。たとえばインテリジェント文書処理を使えば、請求書や契約書からデータを抽出・検証し、バックオフィスシステムへ連携できます。
営業・マーケティングチームは、エンタープライズAIソリューションを活用してリードのスコアリング、顧客のセグメンテーション、オファーのパーソナライズを行います。modelは成約やエンゲージメント向上につながるアクションやメッセージを学習し、営業担当者に次に取るべき最適なアクションを提案します。
カスタマーサポートチームでは、よくある質問に答えるチャットボットや、チケットを適切なチームへ振り分けるスマートルーティングとしてAIが使われています。これにより対応時間が短縮され、本当に専門家の対応が必要なケースが浮かび上がります。
財務・リスク管理部門は、エンタープライズ向けの機械学習を活用して不正検知、信用リスク評価、規制complianceの監視を行います。modelは取引の中から異常なパターンを探し、ポリシーから外れるdriftを検知するとチームにアラートを送ります。
エンジニアリング・ITチームは、コード生成、テスト作成、インフラのautomationを支援するAIコパイロットの恩恵を受けています。調査によると、こうしたツールはプルリクエスト(PR)レビューのサイクルタイムを31.8%短縮し、ソフトウェアデリバリーを直接加速させます。AIは設定変更を提案したり、ログを要約して考えられる根本原因を示したりすることで、インシデントのトラブルシューティングも支援します。
製造・物流分野では、コンピュータビジョンや時系列modelを活用して予知保全や品質検査を実現しています。これらのアプリケーションは、稼働率、コスト、安全性に直接影響します。
ナレッジマネジメントは、LLMベースのエンタープライズ検索、文書要約、社内Q&Aアシスタントによって大きく変わります。従業員はwikiやPDFを掘り返す代わりに質問を投げかけ、社内コンテンツに基づいてcontextを踏まえた回答を得られます。
いずれのユースケースでも、AIは機密データ、中核となるビジネスロジック、重要インフラを扱っています。だからこそ、governance、アーキテクチャ、セキュリティは後付けではなく、設計の初期段階から組み込む必要があります。
エンタープライズAIと小規模なAI活用の違い
エンタープライズAIが小規模な実験やコンシューマー向けツールと異なるのは、組織への組み込みの深さと、問題が起きたときの影響の大きさです。
エンタープライズレベルでは、AIシステムは大規模に稼働します。modelが何年分もの過去データでtrainingされ、数千人のユーザーに同時に予測やレコメンデーションを提供することもあります。こうしたworkloadsの多くは常時稼働し、個別のユースケースではなく中核的な業務機能を支えています。
エンタープライズAIは、共有のplatformとインフラの上に構築されます。modelは一元化されたデータレイク、共有GPUクラスター、共通のメッセージングシステムに依存するのが一般的です。効率は上がる一方でリスクも高まり、共有サービスにmisconfigurationが1つあるだけで、複数のチームや事業部門に同時に影響が及ぶ可能性があります。
デプロイは通常、複数のリージョンやクラウドに分散しています。同じAI platformが欧州の財務チーム、北米のマーケティングチーム、アジアのオペレーションチームを支え、それぞれ規制やデータレジデンシーの要件が異なることもあります。セキュリティとgovernanceの統制は、最初からこの複雑さを考慮して設計しなければなりません。
短期間で終わる概念実証(PoC)とは異なり、エンタープライズAIシステムは長期間稼働する本番サービスです。他の重要インフラと同様に、バージョン管理、監視、インシデント対応のプロセスが求められます。時間の経過とともにデータpipelines、アイデンティティ、下流アプリケーションへのdependencyが蓄積し、潜在的なblast radiusが広がっていきます。
さらに、エンタープライズAIは顧客記録、財務情報、知的財産といった価値が高く規制対象となるデータを日常的に処理します。外部に公開されたmodelエンドポイントやover-permissionedなサービスアカウントが1つあるだけで、複数のシステムとユーザーに同時に影響が及ぶ可能性があります。そのため、エンタープライズAIには、小規模なAI活用をはるかに上回る明確なownership、説明責任、governanceが求められます。
エンタープライズAIにおけるセキュリティとgovernanceへの影響
AIが中核的な業務ワークフローの一部になると、セキュリティリスクは個々のmodelの範囲を超えて広がります。エンタープライズAIシステムは連携先platformのアクセス権、特権、信頼をそのまま引き継ぐため、障害が組織全体に影響する可能性があります。
データアクセスとexposureのリスク
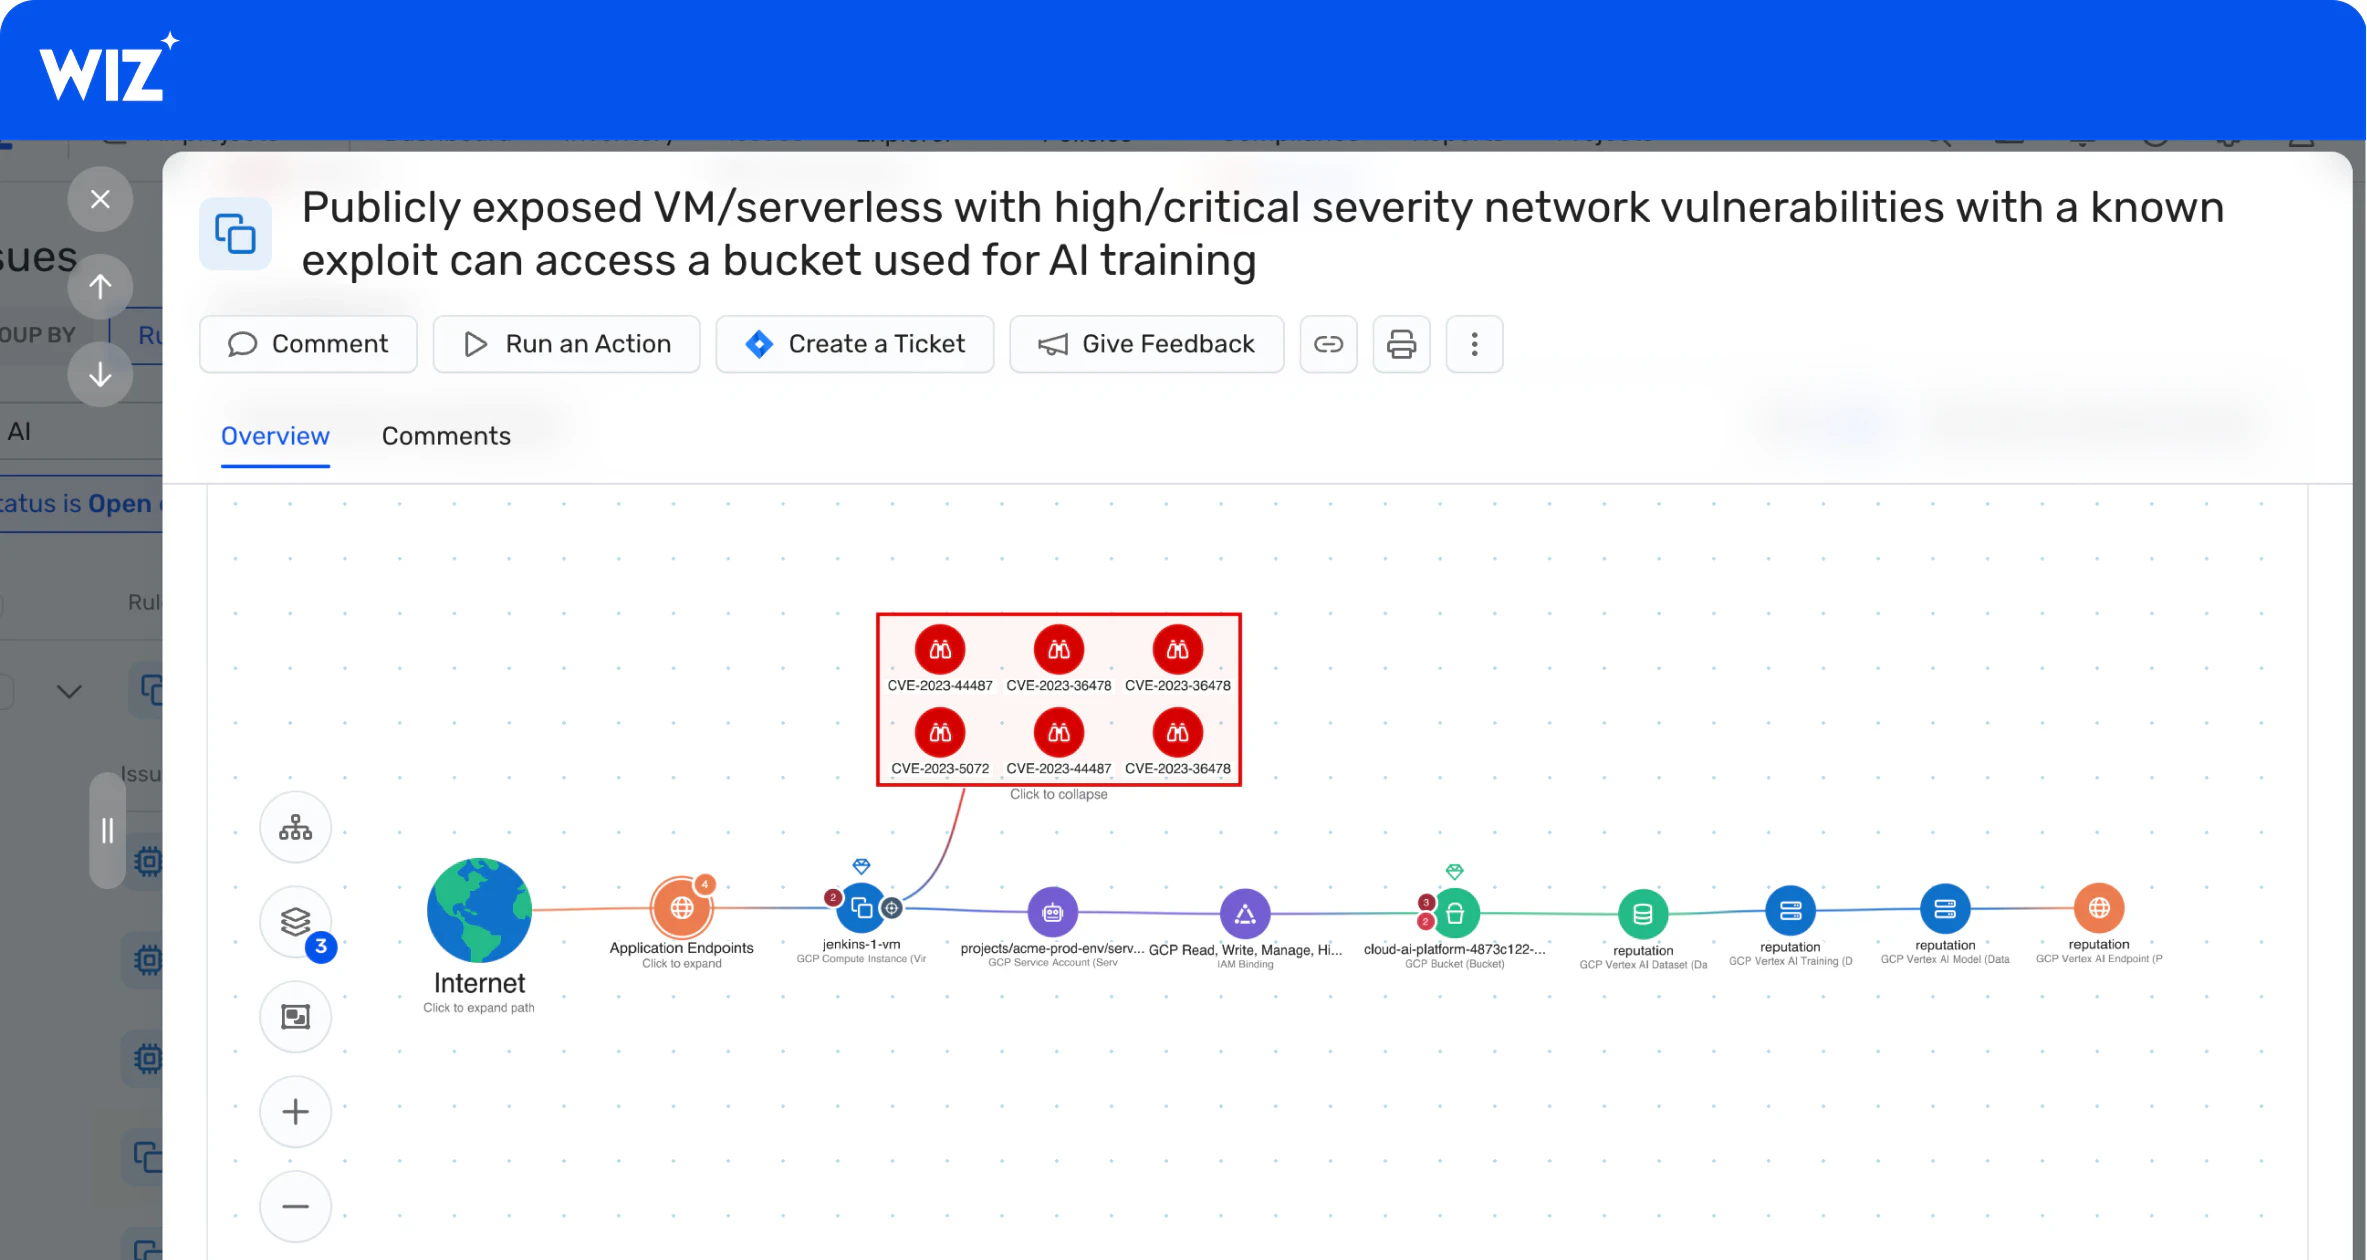
エンタープライズAIシステムは、顧客記録、財務情報、知的財産などの機密データを日常的に扱います。trainingに使うdatasets、フィーチャーストア(feature store)、prompt、検索ソースは、いずれも潜在的なexposureの起点になります。強固なデータgovernanceがなければ、misconfiguration、過度に広いアクセス権、想定外のmodel outputsを通じて機密情報が漏えいするおそれがあります。
このリスクを管理するには、AIパイプラインをデータがどう流れ、どのアイデンティティにそのデータへのアクセスが許可されているかを把握するvisibilityが必要です。
アイデンティティと権限の管理
AIワークフローは、データの取得や下流サービスの呼び出しにサービスアカウント、APIキー、マネージドアイデンティティを利用します。これらのアイデンティティがover-permissionedな状態だと、クラウド環境全体でlateral movementの足がかりになります。大企業では、misconfigurationのあるAIサービスのアイデンティティが1つあるだけで、複数のシステムやdatasetsが露出する可能性があります。
least privilegeに基づくアクセスと継続的な権限レビューは、blast radiusを抑えるうえで欠かせません。
AI特有の攻撃パターン
エンタープライズAIは、従来のアプリケーション制御では十分に対処できないセキュリティ課題をもたらします。検索拡張生成(Retrieval-augmented generation)のpipelinesは、データを動的にmodelのcontextへ取り込むため、攻撃対象領域を広げます。prompt injection攻撃によって検索ロジックやツール実行が操作されると、許可されていないデータソースへのアクセスや情報の持ち出しにつながる可能性があります。
大規模になると、整合性のリスクも生じます。データポイズニング(Data poisoning)でdatasetsが汚染されるとmodelの挙動が変わる可能性があり、敵対的な入力によって明らかな障害のsignalがないまま誤解を招くoutputsが生成されることもあります。システムが正常に動作しているように見えても、攻撃者がmodelの応答からtrainingに使われた機密データを推測できるケースもあります。
governanceとcomplianceの要件
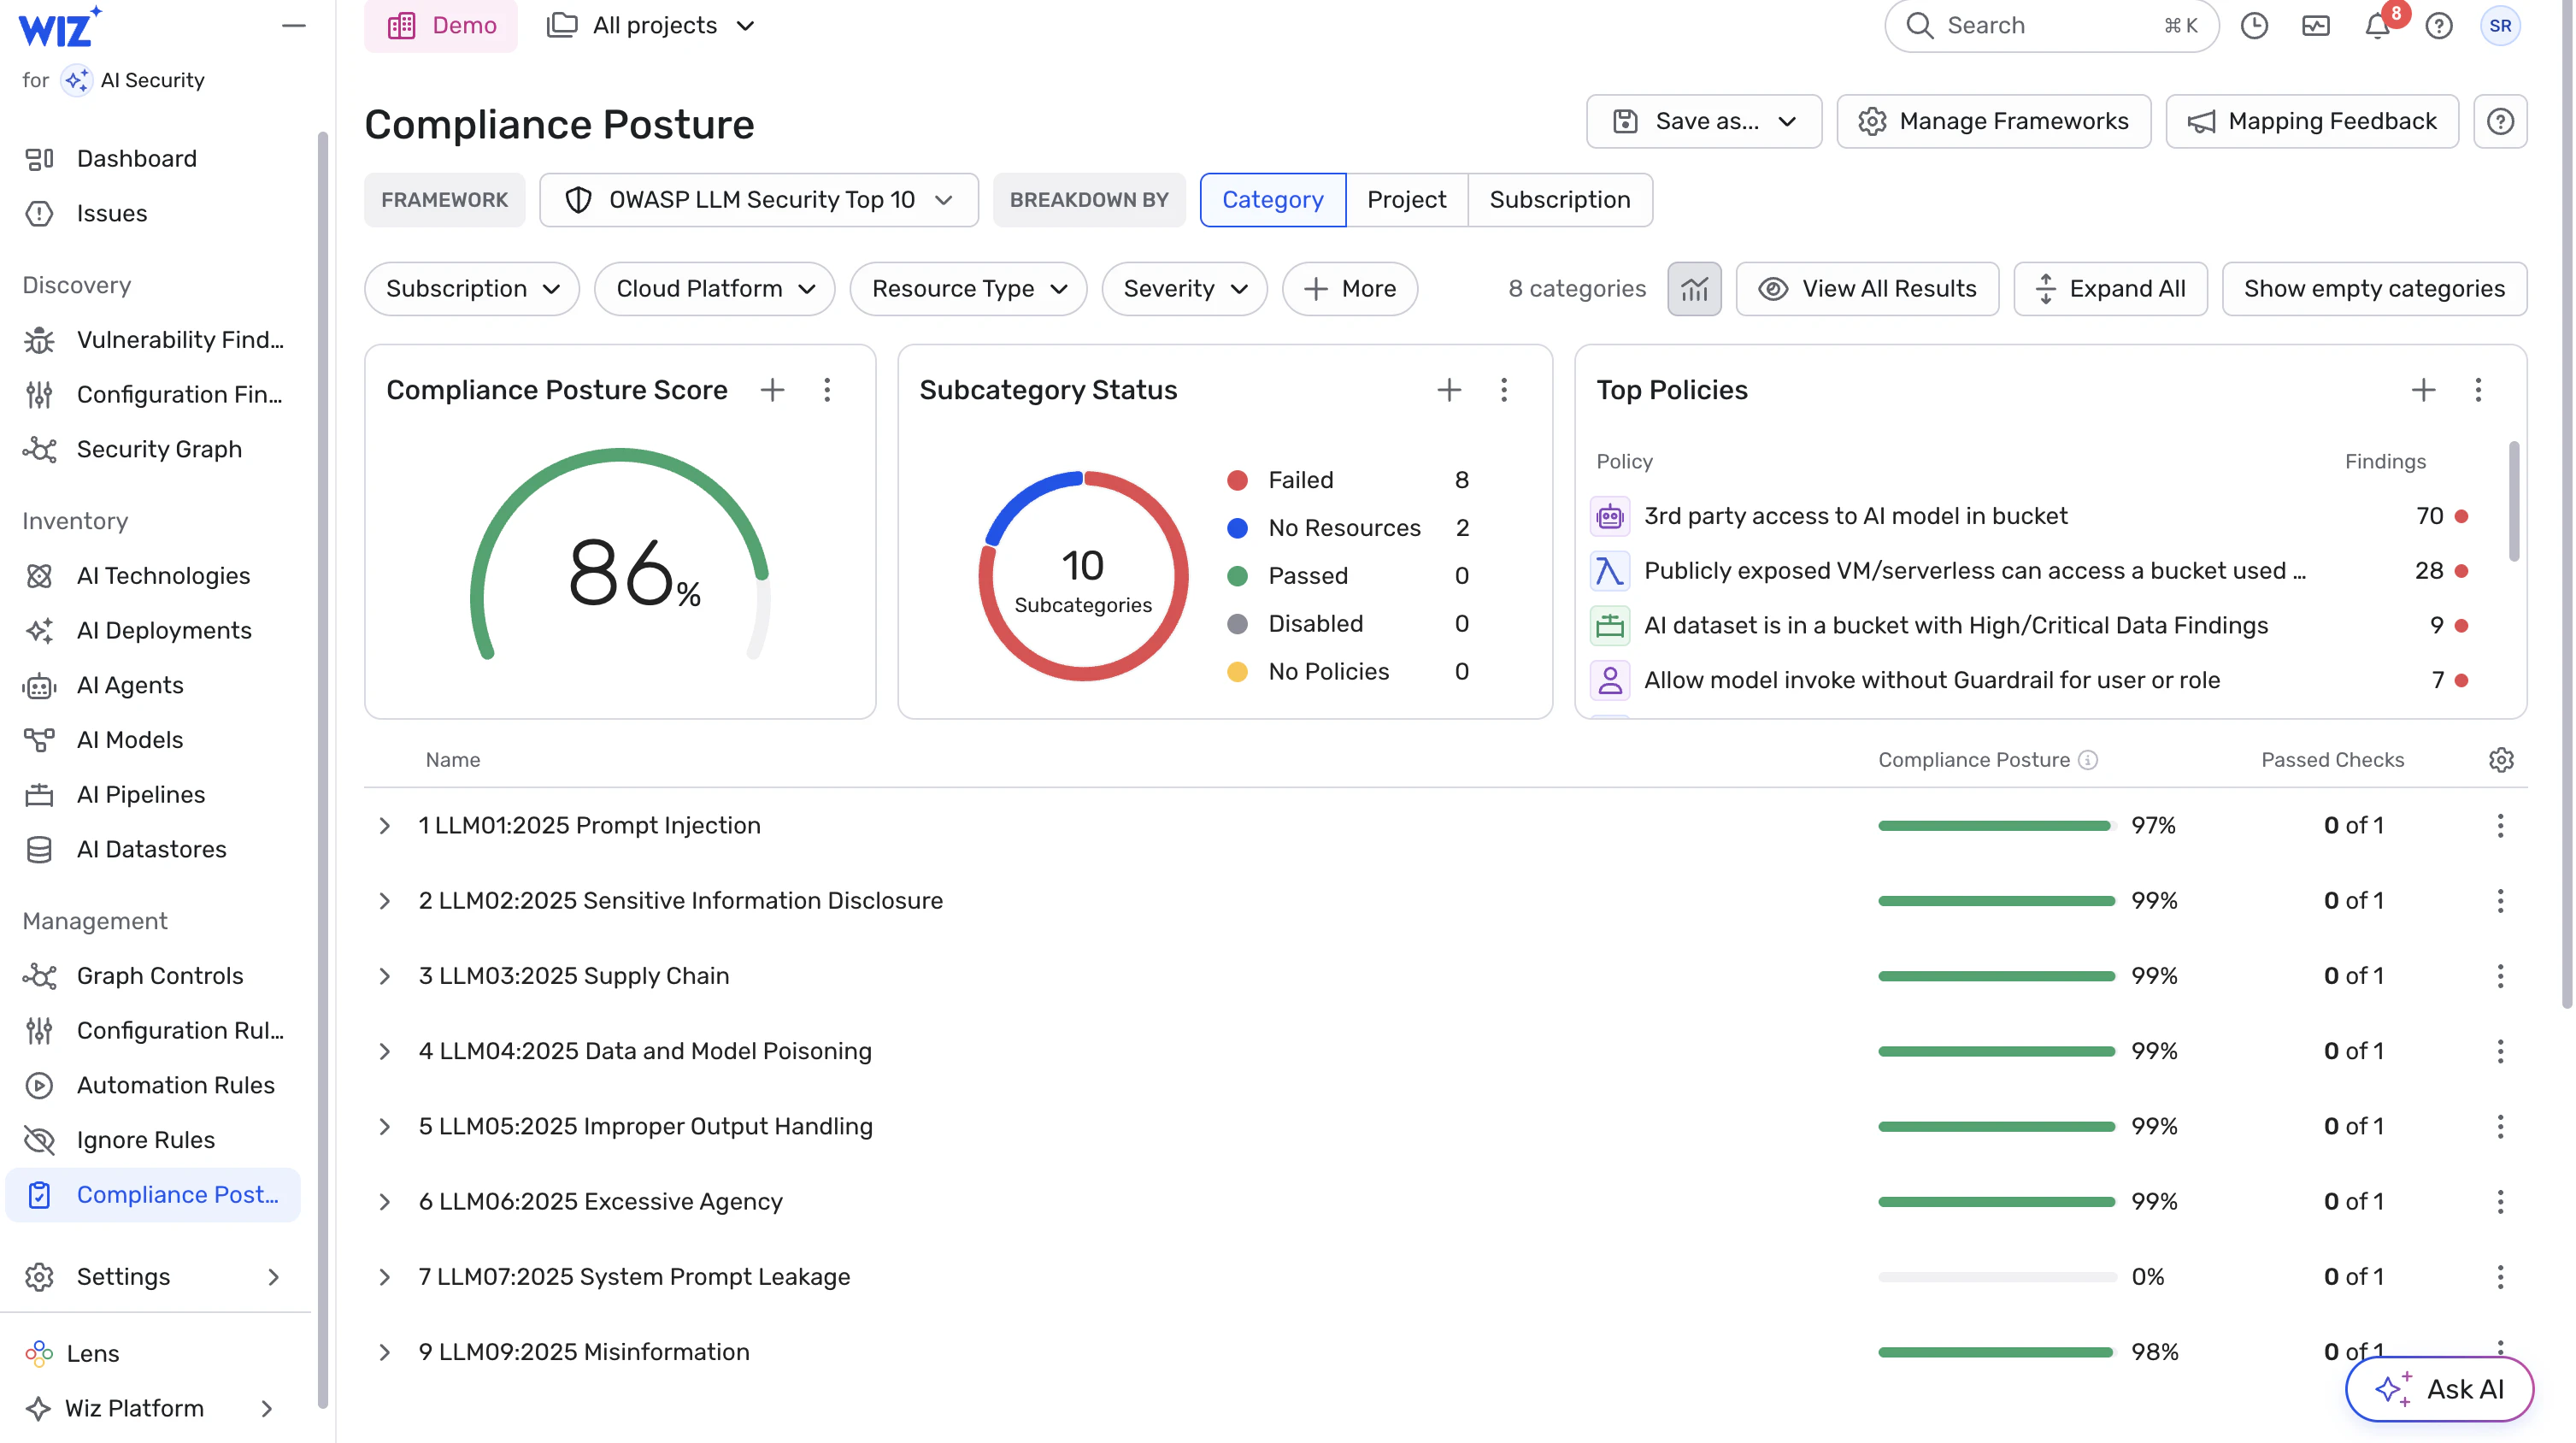
AIシステムが意思決定に影響を与え、ワークフローを自動化するようになると、governanceは必須になります。組織は、誰がmodelをデプロイできるのか、modelがどのデータにアクセスできるのか、outputsや意思決定をどのように記録・レビューするのかを定義する必要があります。明確なownershipと監査可能性がなければ、インシデントの調査やcomplianceの証明は難しくなります。
エンタープライズAIのデプロイは、GDPR、CCPA、SOC 2、ISO/IEC 27001、ISO/IEC 42001、NIST AI Risk Management Framework、さらに一部の地域ではEU AI Actといった規制やgovernanceのフレームワークにも準拠する必要があります。
目的はイノベーションを遅らせることではありません。AIが組織全体に広がっても、AIシステムの信頼性とコントロールを保ち続けることにあります。
エンタープライズがAI導入で直面する実装上の課題
エンタープライズAIの価値が明らかでも、パイロットを本番システムへ移行するのは簡単ではありません。課題の多くはmodelそのものではなく、既存環境へのAIの統合から生じます。
レガシーシステムとのAI統合
多くの企業は、リアルタイム分析やAI駆動のワークフローを想定せずに設計されたレガシーなデータベースやアプリケーションに依存しています。最新のAIサービスをこうしたシステムに接続するには、慎重なアーキテクチャ設計、データの正規化、アクセス制御が必要です。この下地がなければ、AIプロジェクトは実験段階から先へ進めません。
パイロットから本番への拡大
AIのPoCは、隔離された環境では成功しても、拡大の段階でつまずくことがよくあります。本番環境へのデプロイでは、信頼性、フェイルオーバー、監視、リージョンごとの可用性に対応しなければなりません。業界の調査では、AIシステムを大規模に運用できている組織はごく一部にとどまり、実験段階とエンタープライズでの本格運用との間に大きな隔たりがあることが示されています。
データの品質、アクセス、governance
AIシステムは高品質なデータに依存しますが、企業は機密性の高いdatasetsに対して厳格なアクセス制御も徹底しなければなりません。多くのチームが、modelの精度と、データ最小化やcompliance要件との両立に苦労しています。データの利用しやすさとセキュリティという相反する目標が、導入を遅らせ、運用上の摩擦を増やします。
チーム間で分断されたownership
エンタープライズAIの取り組みは、データエンジニアリング、データサイエンス、アプリケーション開発、セキュリティの各チームにまたがります。ownershipが不明確だと、modelの再training、アクセスレビュー、インシデント対応といった責任が抜け落ちることがあります。visibilityとpolicy enforcementを一元化することで、チーム間の引き継ぎが減り、time to remediationが短縮されます。
環境と設定の不一致
AIシステムは、設定のdriftやアクセスポリシーの不一致により、開発、ステージング、本番の各環境で異なる挙動を示すことがよくあります。こうした差異はトラブルシューティングを難しくし、影響に対する十分なvisibilityがないまま変更を本番へ反映するとリスクにつながります。
shadow AIと管理されていないツール
開発者は、一元的な承認を経ずにSaaS platformを通じてAIツールを簡単に導入できます。イノベーションは加速しますが、確立されたgovernanceやセキュリティ統制の外で動作する、shadow AIとしてのAIパイプラインも生まれます。こうしたツールに対するvisibilityがなければ、組織はリスクのexposureを正確に評価できません。
visibilityとコスト管理の課題
多くの組織は、クラウド環境全体にわたるAI workloads、model、データフローを一元的に把握できていません。そのため、セキュリティ態勢の評価、一貫したポリシーの適用、コストの管理が難しくなります。オブザーバビリティ(可観測性)がなければ、AIインフラへの支出がビジネス価値を上回るペースで膨らむおそれがあります。
こうした課題が、初期の成功後にエンタープライズAIの導入が停滞しがちな理由です。解決には、より優れたmodelだけでなく、明確なownership、強力なvisibility、AI workloadsの拡大に合わせてスケールするセキュリティ統制が必要です。
セキュアなエンタープライズAIのリファレンスアーキテクチャ
セキュアなエンタープライズAIのアーキテクチャは、データ、model、アプリケーションをつなぎ、各レイヤーに明確なセキュリティ境界を設けます。目的はすべてを締め付けることではなく、AI lifecycle全体を通じてアクセスを意図的で、観測・監査が可能な状態に保つことです。
データソース、取り込み、データレジデンシー
エンタープライズAIシステムは、CRM、ERP、ログ、サードパーティサービスなどの業務platformからデータを取り込み、一元化されたデータレイクやレイクハウスに集約します。取り込みの時点でデータを分類・タグ付けしておくことで、機密度とアクセスポリシーが下流へ引き継がれます。
マルチリージョン環境や規制対象の環境では、データをどこで処理・保存するかを定義することも重要です。データレジデンシーとデータ主権の統制により、training、inference、検索のpipelinesが地域ごとの要件や契約上の義務に準拠できるようになります。
特徴量エンジニアリングとフィーチャーストア
機械学習modelが使用する加工済みの特徴量は、一元化されたフィーチャーストアに保存され、trainingとinferenceの間で一貫性が保たれます。アクセス制御によって特定の特徴量セットを読み取れるmodelとチームを制限し、データの系統(データフロー)を追跡することで、監査やインシデント調査の際に特徴量を元のdatasetsまでたどれます。
このレイヤーは、modelが機密データや利用が制限されたデータを気付かないうちに取り込むのを防ぐ役割を果たします。
modelのtraining、検証、レジストリ
modelは、承認済みのdatasetsと一時的な認証情報を使い、隔離された環境でtrainingされます。すべてのデータアクセスはログに記録され、blast radiusを抑えるためにアウトバウンド通信は制限されます。
本番環境へ昇格させる前に、modelはセキュリティと整合性のチェックを通過する必要があります。具体的には、想定外のデータ漏えいのスキャン、modelカードやドキュメントの検証、バックドアや安全でない挙動を検出する敵対的テスト(adversarial testing)などが挙げられます。承認されたmodelは、trainingに使ったdatasets、パフォーマンス指標、想定用途を含むメタデータとともにレジストリへ登録されます。
デプロイ、inference、入力検証
modelは、管理された継続的インテグレーション/継続的デリバリー(CI/CD)のpipelinesを通じて、マネージドなinferenceエンドポイントやコンテナ化された環境にデプロイされます。ネットワークポリシーとAPIゲートウェイが、認証、認可、レート制限を適用します。
inferenceの段階では、入力の検証とサニタイズが欠かせません。ユーザー入力や上流からのsignalは、modelに届く前にprompt injectionの試みや不正な形式のリクエストが含まれていないか検査してください。これにより、攻撃者がmodelの挙動を操作したり、許可されていない操作を実行させたりするリスクを減らせます。
検索拡張生成のpipelines
検索拡張生成を使う場合、vectorデータベースには承認済みのソースから生成したembeddingsのみを保存します。検索サービスはアクセス制御を適用し、特定のユーザーやアプリケーションがどのドキュメントを取得できるかを検証します。
取得したcontextはユーザー入力と明確に分離し、間接的なprompt injectionのリスクを抑えます。outputsの検証では、ユーザーに結果を返す前に、レスポンスに機密データの漏えいやポリシー違反がないかをチェックします。
オブザーバビリティ、監視、敵対的テスト
AIスタック全体のログとメトリクスは、一元化された監視システムに集約されます。セキュリティチームは、予期しないデータアクセス、modelの異常な利用パターン、不審なAPIの挙動に目を光らせます。
受動的な監視に加えて、デプロイ済みのmodelに対して定期的なレッドチーミングと敵対的テストを実施することが推奨されます。こうした演習により、ガードレールの有効性を検証し、回避手法を洗い出し、modelやデータが変化しても統制が機能し続けることを確認できます。
スタック全体のpolicy enforcement
policy enforcementは、クラウドネイティブなIAM(アイデンティティとアクセス管理)とplatformレベルの統制を組み合わせて実現します。least privilegeのポリシーによって、誰がデータにアクセスし、modelをtrainingし、エンドポイントをデプロイし、inferenceを呼び出せるかを定義します。
開発、ステージング、本番で一貫して適用することで設定のdriftが減り、エンタープライズAIの導入拡大に合わせてセキュリティもスケールさせられます。
このレイヤー構造のアーキテクチャは、共有のvisibilityを維持しながら、データ、ML、platform、セキュリティの各チームの責任を切り分けます。明確な境界、継続的な検証、定期的なテストにより、企業はセキュリティとgovernanceのコントロールを失わずにAIを大規模に展開できます。
エンタープライズAIの導入を拡大する際は、クラウド環境、アイデンティティ、データフローを横断して把握し、リスクを継続的に管理することが重要です。WizがAIワークロードのセキュリティ態勢の可視化と管理をどのように支援できるかをご確認ください。 Wizを実際に体験する