

Unterschiede zwischen KI-Fehlkonfigurationen und klassischen Cloud-Fehlkonfigurationen
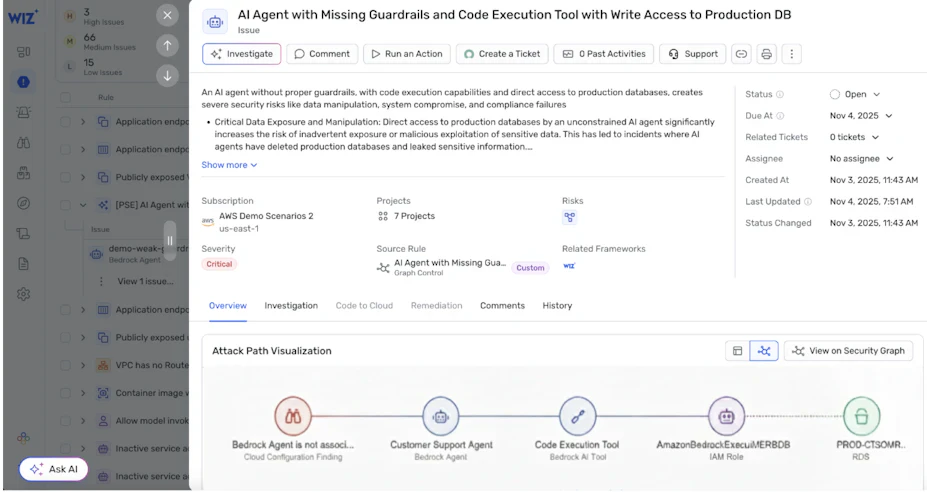
KI-Fehlkonfigurationen sind Sicherheitsfehler in der Einrichtung von KI-Systemen. Sie entstehen, wenn KI-Infrastruktur, Modelle oder Services falsch eingestellt sind, zu weitreichende Berechtigungen haben oder mit unsicheren Standardwerten laufen. Das setzt Unternehmen unnötigen Risiken aus.
Klassische Cloud-Fehlkonfigurationen betreffen meist Compute-, Speicher- oder Netzwerkressourcen. Typische Beispiele sind ein offener S3-Bucket, eine falsch konfigurierte Sicherheitsgruppe oder eine öffentlich erreichbare Datenbank. KI-Fehlkonfigurationen betreffen dagegen KI-spezifische Komponenten, die auf diesen Ressourcen aufsetzen und zusätzliche Ebenen der Komplexität mitbringen.
Diese Komponenten machen den Unterschied:
Datastores für Trainingsdaten: Sie enthalten die Datasets, mit denen Modelle lernen, und oft auch sensible Informationen.
Modell-Registries: Hier liegen trainierte Modelle und Artefakte, die erhebliches geistiges Eigentum darstellen.
Inferenz-Endpunkte: Über diese APIs nehmen Modelle Anfragen entgegen und liefern Vorhersagen zurück.
ML-Pipelines: Sie automatisieren den Weg von den Daten über das trainierte Modell bis zum Deployment.
KI-Services bauen auf denselben Identitätsgrundlagen in der Cloud auf: AWS-IAM-Rollen, Azure RBAC und GCP-Servicekonten. Häufig kommen jedoch neue Muster für Zugangsdaten hinzu, etwa API-Schlüssel, Service-Tokens und serviceübergreifende Berechtigungen. Sind diese Zugangsdaten zu weit gefasst, langlebig oder schlecht verwaltet, werden sie zu einem folgenreichen Zugriffspfad in KI-Systeme und deren Daten.
KI-Workloads ändern sich häufig. Teams trainieren Modelle neu, passen Prompts an und starten laufend neue Inferenz-Pipelines. Dieses Tempo erhöht mit der Zeit das Risiko von Konfigurationsdrift.
Bei fehlkonfigurierten KI-Services steht mehr auf dem Spiel als die Infrastruktur. Offenliegen können auch proprietäre Modelle, Algorithmen oder Trainingsdaten, die bestimmen, wie sich eine KI verhält und was sie weiß.
Typische Arten von KI-Fehlkonfigurationen
Die meisten KI-Sicherheitsvorfälle gehen nicht auf ausgefeilte Exploits oder neuartige Angriffstechniken zurück. Sie entstehen durch einfache Konfigurationsfehler, die isoliert harmlos wirken. Gefährlich werden sie erst in Verbindung mit Identitätsberechtigungen, Netzwerkerreichbarkeit und Zugriff auf sensible Daten.
Offen erreichbare KI-Endpunkte und -Services
Ein Inferenz-Endpunkt ist eine API, die Eingaben entgegennimmt und Modellvorhersagen zurückgibt. Ist ein solcher Endpunkt ohne starke Zugriffskontrollen aus dem öffentlichen Internet erreichbar, kann jeder direkt mit dem Modell interagieren.
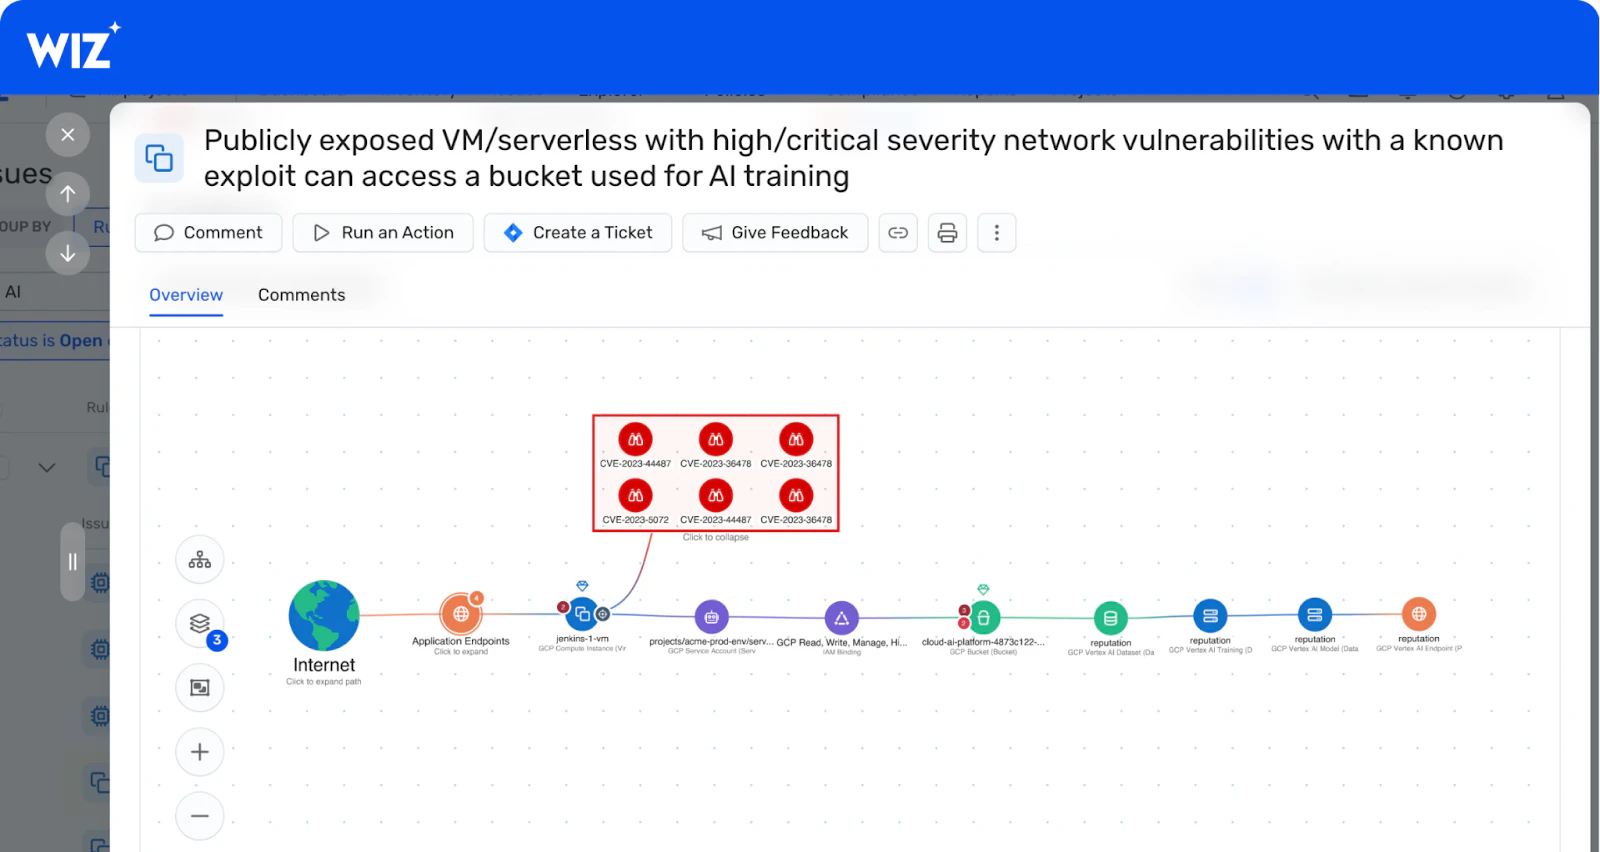
Öffentlich erreichbaren Inferenz-Endpunkten oder Entwicklungsumgebungen fehlen oft ausreichende Netzwerkbeschränkungen oder eine Authentifizierung. Das schafft einen einfachen Einstiegspunkt in KI-Systeme. Unbefugte können Modelle abfragen, ihr Verhalten ausloten oder versuchen, sensible Informationen zu extrahieren.
Identitäten von KI-Services mit zu weitreichenden Berechtigungen
Jeder KI-Service läuft unter einer Identität, etwa einer IAM-Rolle oder einem Servicekonto. Hat diese Identität mehr Berechtigungen als nötig, kann ein einziger kompromittierter Workload weit mehr preisgeben als den KI-Service selbst.
KI-Workloads greifen häufig auf Datastores, Feature-Pipelines und andere Cloud-Services zu. Überprivilegierte Identitäten können den Schadensradius deshalb erheblich vergrößern. Wird ein KI-Service missbraucht, übernehmen Angreifer sämtliche Berechtigungen dieser Identität.
Unsicher gespeicherte Trainingsdaten und Modelle
Trainings-Datasets und Modellartefakte enthalten oft proprietäre oder sensible Informationen. Fehlen ausreichende Verschlüsselung, Zugriffskontrollen oder eine Trennung zwischen Umgebungen, werden diese Ressourcen zu besonders attraktiven Zielen.
Unsicherer Zugriff auf Trainingsdaten oder feinabgestimmte Modelle kann geistiges Eigentum, regulierte Daten oder interne Geschäftslogik offenlegen, die in KI-Systemen steckt.
Unzureichendes Logging und fehlende Transparenz
Viele KI-Services gehen ohne umfassendes Logging und Monitoring in Betrieb. Erfassen Cloud-Native-Logging-Systeme die Aktivität von KI-Services nicht konsistent, fehlt Sicherheitsteams die Transparenz. Unklar bleibt dann, wer wie auf Modelle, Endpunkte und Datasets zugreift.
Ohne diese Transparenz lässt sich normale Nutzung kaum von Fehlkonfigurationen oder aktivem Missbrauch unterscheiden. Das gilt besonders, wenn KI-Systeme mit sensiblen Daten arbeiten oder in großem Maßstab laufen.
Schwache Authentifizierung und Autorisierung
KI-Workloads starten oft als Experimente mit gelockerten Sicherheitskontrollen, die bis in die Produktion bestehen bleiben. Öffentliche Endpunkte, gemeinsam genutzte Zugangsdaten oder langlebige Zugriffstoken bleiben häufig weit über die erste Entwicklungsphase hinaus in Gebrauch.
Sind Authentifizierung und Autorisierung über KI-Services hinweg uneinheitlich geregelt, können Angreifer diese Lücken nutzen. So verschaffen sie sich unbefugten Zugriff oder erweitern ihre Berechtigungen.
Unsichere Konfigurationen beim Modell-Deployment
Beim Deployment von KI-Modellen sind mehrere Ebenen beteiligt, darunter Container, CI/CD-Pipelines, API-Gateways und Orchestrierungsplattformen. Fehlkonfigurationen auf jeder dieser Ebenen können zusammen mit Identitäts- oder Netzwerkproblemen ernsthafte Risiken erzeugen.
Fehlt eine saubere Isolation zwischen Modellartefakten, Runtime-Umgebungen und unterstützenden Services, werden KI-Systeme womöglich unbemerkt für größere Teile der Cloud-Umgebung erreichbar.
Mandantenübergreifende Risiken und Isolation
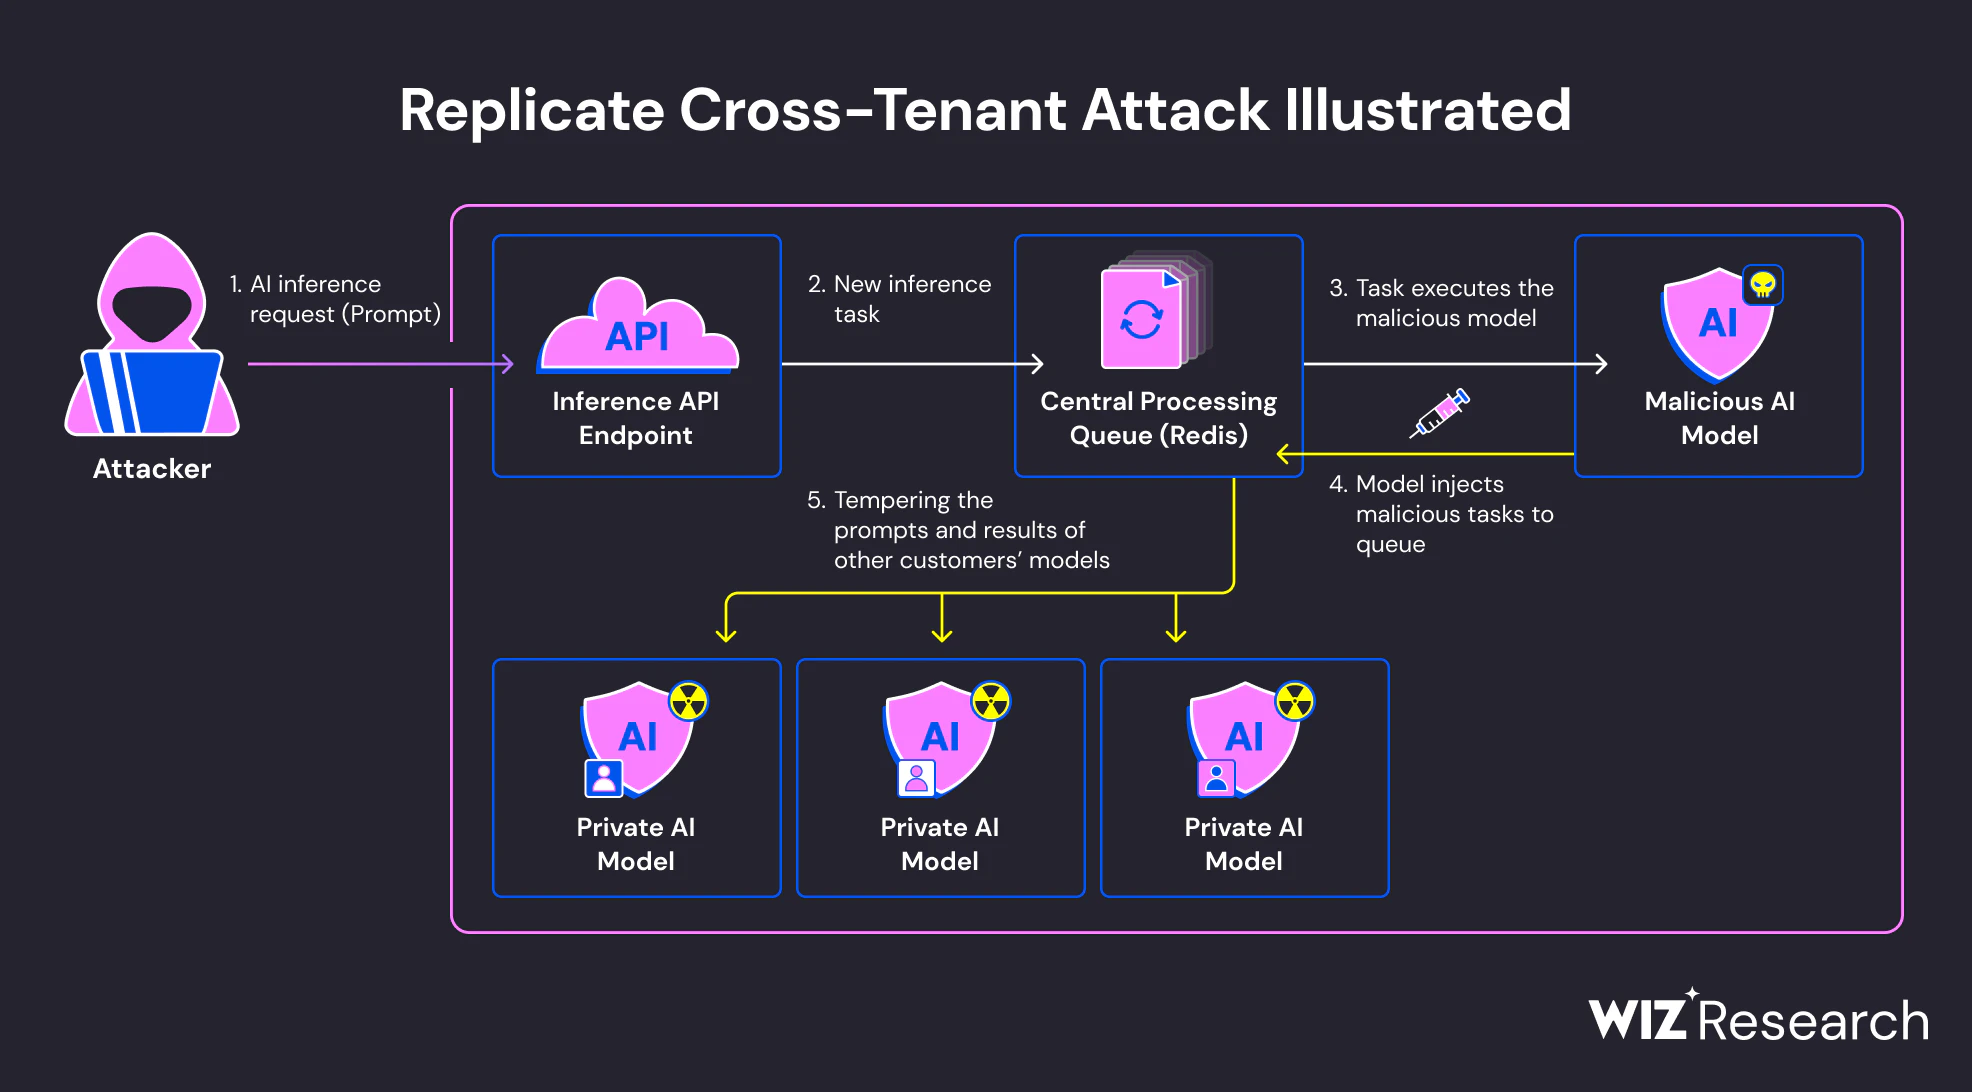
Verwaltete KI-Plattformen laufen auf gemeinsam genutzter Cloud-Infrastruktur mit starker, vom Anbieter durchgesetzter Isolation. Mandantenübergreifende Sicherheitsverletzungen auf Anbieterebene sind selten.
Die meisten Isolationsrisiken entstehen durch Fehlkonfigurationen auf Kundenseite. Dazu zählen zu freizügige Zugriffskontrollen, offene Netzwerkpfade oder eine unzureichende Trennung zwischen Projekten, Workspaces oder Umgebungen. Das kann zu ungewolltem Zugriff zwischen internen Teams oder durch externe Parteien führen.
Angriffspfade zu sensiblen Daten durch KI-Fehlkonfigurationen
Ein Angriffspfad ist die Abfolge von Bedingungen, über die Angreifer von einer ersten Schwachstelle zu einem wertvollen Ziel gelangen. KI-Fehlkonfigurationen lösen selten allein Vorfälle aus, bilden aber oft entscheidende Glieder in diesen Pfaden.
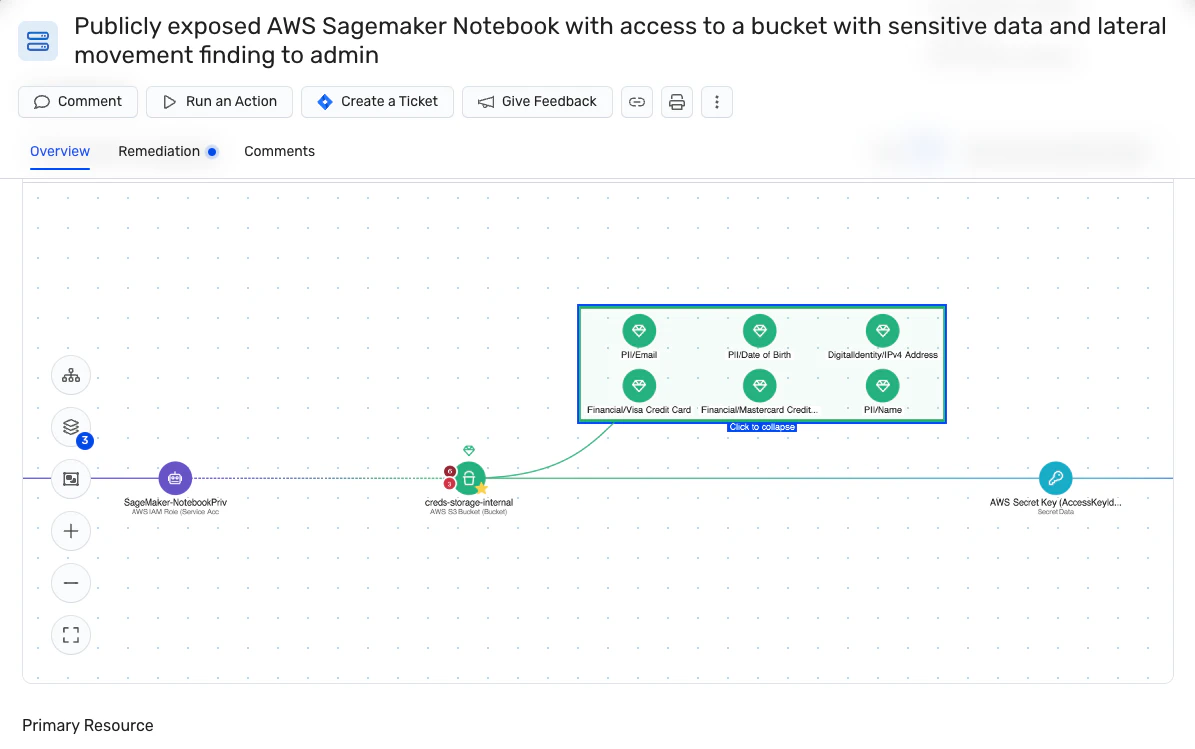
Anders als isolierte Infrastrukturprobleme überschneiden sich KI-Fehlkonfigurationen häufig mit Identitäten, Datenzugriff und Netzwerkerreichbarkeit. Treffen diese Elemente zusammen, entstehen toxische Kombinationen. Sie erhöhen die Wahrscheinlichkeit und die Auswirkungen einer Ausnutzung deutlich.
Entstehung toxischer Kombinationen
KI-Fehlkonfigurationen verstärken meist bestehende Cloud-Risiken, statt völlig neue zu schaffen. Typische Kombinationen sind:
Offener Endpunkt + überprivilegierte Service-Identität: Ein öffentlich erreichbarer Inferenz-Endpunkt mit weit gefasster Rolle kann Zugang zu Datastores, Feature-Pipelines oder nachgelagerten Services des Modells eröffnen.
Schwache Authentifizierung + sensible Trainingsdaten: Gemeinsam genutzte Zugangsdaten oder schlecht verwaltete Zugriffstoken können Trainings-Datasets mit Kundendaten, proprietären oder regulierten Informationen offenlegen.
Begrenztes Logging + hohes Inferenzvolumen: Ohne konsistentes Logging gehen ungewöhnliche Zugriffsmuster oder groß angelegte Versuche der Datenextraktion leicht in der normalen KI-Nutzung unter.
Einzeln wirken diese Probleme oft harmlos. Zusammen können sie direkte Pfade zu sensiblen Daten und KI-Ressourcen schaffen.
Lateral Movement über KI-Services
KI-Workloads sind häufig mit Speichersystemen, Daten-Pipelines und anderen Cloud-Services verbunden. Fehlkonfigurierte KI-Services können deshalb zu wirksamen Sprungbrettern für weitere Schritte werden.
Ein offener oder missbrauchter KI-Endpunkt, dessen Identität auf Trainingsdaten oder interne Services zugreifen kann, ermöglicht Lateral Movement über das KI-System hinaus. Angreifer müssen das Modell in solchen Szenarien gar nicht direkt ausnutzen. Die fehlkonfigurierten Zugriffspfade erledigen die Arbeit für sie.
Unbemerkte Datenpreisgabe über Inferenz
Fehlkonfigurationen können auch dazu führen, dass sensible Informationen im normalen KI-Betrieb abfließen.
Inferenz-Workflows, die vollständige Prompts, Antworten oder Zwischendaten ohne geeignete Kontrollen protokollieren, speichern unter Umständen unbemerkt personenbezogene oder vertrauliche Informationen. Mit der Zeit werden diese Logs zu sekundären Datastores. Sie sind oft schlechter geschützt und breiter zugänglich als die ursprünglichen Datasets.
Fehlen zusätzlich Zugriffskontrollen oder Monitoring, bleibt diese Offenlegung womöglich lange unentdeckt.
Wachsender Schadensradius
KI-Systeme verbinden oft mehrere Services miteinander. Eine einzelne Fehlkonfiguration, etwa eine zu freizügige Service-Rolle oder ein offener Endpunkt, kann den Schadensradius auf folgende Bereiche ausweiten:
Repositories für Trainingsdaten;
Modellartefakte und Registries;
Feature Stores und nachgelagerte Analysesysteme;
unterstützende Cloud-Services und APIs.
KI-Pipelines erstrecken sich über Entwicklung, Deployment und Runtime-Umgebungen. Eine Schwachstelle in einer Phase kann sich deshalb auf das gesamte System auswirken.
Herausforderungen im Risikomanagement für KI-Fehlkonfigurationen
Selbst erfahrene Cloud-Sicherheitsteams tun sich schwer, KI-Fehlkonfigurationen wirksam in den Griff zu bekommen. Das Tempo der KI-Einführung, verteilte Zuständigkeiten und begrenzte Transparenz in bestehenden Tools erschweren einen stabilen Sicherheitsstatus. Bei KI ist das deutlich anspruchsvoller als bei klassischer Cloud-Infrastruktur.
KI-Einführung schneller als Sicherheitskontrollen: KI-Services gehen oft schneller in Betrieb, als sich Sicherheitskontrollen weiterentwickeln. Neue Modelltypen, Managed Services, SDKs und Deployment-Muster erreichen die Produktion, bevor einheitliche Guardrails stehen. KI-Workloads übernehmen so Standardkonfigurationen oder Ad-hoc-Entscheidungen aus der Experimentierphase, und mit wachsender Nutzung steigt das Risiko von Fehlkonfigurationen.
Begrenzte Transparenz über KI-spezifische Ressourcen: Viele ältere Cloud-Sicherheitstools überwachen virtuelle Maschinen, Netzwerke und Speicher. Modell-Registries, Trainingsjobs, Prompt-Stores oder Inferenz-Pipelines erfassen sie nicht. Ohne Transparenz über diese KI-nativen Komponenten bleiben offene Endpunkte, überprivilegierte Identitäten oder sensible Datasets an KI-Workloads leicht unbemerkt.Verteilte Zuständigkeiten über Teams hinweg: KI-Services haben selten nur eine verantwortliche Stelle. Die Verantwortung verteilt sich oft auf:
Data-Science-Teams, die Modelle und Notebooks verwalten;
Plattformteams, die Cluster, Pipelines und CI/CD betreiben;
Sicherheitsteams, die Richtlinien festlegen und auf Vorfälle reagieren.
Shadow AI und nicht verwaltete Deployments: KI-Services entstehen häufig außerhalb formaler Sicherheitsprozesse. Teams setzen Modelle über verwaltete Cloud-Services, Open-Source-Frameworks oder APIs von Drittanbietern ein, ohne sie in zentralen Inventaren zu registrieren. Solche Deployments von Shadow AI umgehen Standard-Zugriffskontrollen, Logging und Monitoring und sind entsprechend schwer zu finden und zu bewerten.
Alarmrauschen ohne Kontext: Rohe Befunde wie „öffentlicher Endpunkt“ oder „schwache Zugangsdaten“ sagen wenig, solange unklar ist, auf welche Daten der KI-Service zugreift und wie er mit anderen Systemen verbunden ist. Ohne Abgleich mit Identitätsberechtigungen, Netzwerkerreichbarkeit und Datensensibilität entsteht Alarmrauschen, und echte Risiken lassen sich kaum priorisieren.
Neue Compliance- und Governance-Anforderungen: Aufkommende KI-Regulierungen und Governance-Frameworks stellen zusätzliche Erwartungen an Transparenz, Zugriffskontrolle und Risikomanagement. Unternehmen müssen KI-spezifische Kontrollen nun neben bestehenden Pflichten zu Cloud, Datenschutz und Compliance abdecken. Für Teams, die bereits große Cloud-Umgebungen verwalten, steigt damit die Komplexität.
Cloud-Native-Sicherheitsansatz für KI-Fehlkonfigurationen
KI existiert nicht im luftleeren Raum. Jedes Modell, jede Pipeline und jeder Endpunkt läuft auf Cloud-Compute, Netzwerken, Identitäten und Datenservices. Wer nur Modellcode oder Prompts betrachtet, kann KI nicht absichern.
KI-Systeme hängen von Cloud-Infrastruktur, Identitäten und Datenservices ab. Ein Modell-Endpunkt mag für sich genommen sicher sein. Kann die Service-Identität dahinter aber auf sensible Datastores zugreifen, bleibt das Problem bestehen.
Risiken erstrecken sich oft gleichzeitig über Infrastruktur-, Daten- und KI-Ebene. Erst wer sieht, wie diese Ebenen zusammenhängen, erkennt, wo die echten Risiken liegen.
Punktuelle Prüfungen halten mit sich ändernden KI-Umgebungen kaum Schritt. Besser ist eine kontinuierliche Bewertung in Kombination mit privaten Endpunkten, Netzwerkisolation (AWS VPC, Azure VNet, GCP VPC), kundenverwalteten Verschlüsselungsschlüsseln (CMEK) und IAM-Rollen nach dem Prinzip der geringsten Berechtigung. So bleibt der Sicherheitsstatus stabil, während sich KI-Workloads weiterentwickeln.
Kontinuierliche Transparenz über alle Cloud-Ressourcen reduziert blinde Flecken bei KI-Risiken. Teams sollten unter anderem diese Fragen beantworten können:
Wo befinden sich alle KI-Services und Modell-Endpunkte?
Welche davon sind aus dem Internet erreichbar?
Welche können auf sensible Datastores oder hochprivilegierte Rollen zugreifen?
Ein horizontaler, kontextbasierter Ansatz verknüpft KI-Ressourcen, Identitäten, Netzwerke und Daten. So erkennen Teams toxische Kombinationen statt nur einzelner Befunde. Die ebenenübergreifende Transparenz zeigt, welche Fehlkonfigurationen echte Angriffspfade schaffen und welche isoliert kaum ein Risiko darstellen.
Genau diese Transparenz über alle Ebenen hinweg sollen CNAPP-Plattformen (Cloud-Native Application Protection Platforms) und Tools für AI Security Posture Management (AI-SPM) liefern.
Erkennung und Priorisierung von KI-Fehlkonfigurationen mit Wiz
KI-Fehlkonfigurationen sind letztlich Cloud-Sicherheitsprobleme, an denen KI-Systeme beteiligt sind. Modelle, Pipelines und Inferenz-Endpunkte hängen von Cloud-Infrastruktur, Identitäten, Netzwerken und Datenservices ab. Wer KI-Risiken verstehen will, braucht daher Transparenz über die gesamte Cloud-Umgebung und nicht nur über die KI-Ebene.
Aus Sicht der KI-Sicherheit ist diese Transparenz entscheidend. Fehlkonfigurationen auf Cloud-Ebene bestimmen oft, ob KI-Systeme sensible Daten offenlegen, unbefugten Zugriff erlauben oder Angriffspfade öffnen, die klassische Sicherheitskontrollen nicht erkennen.
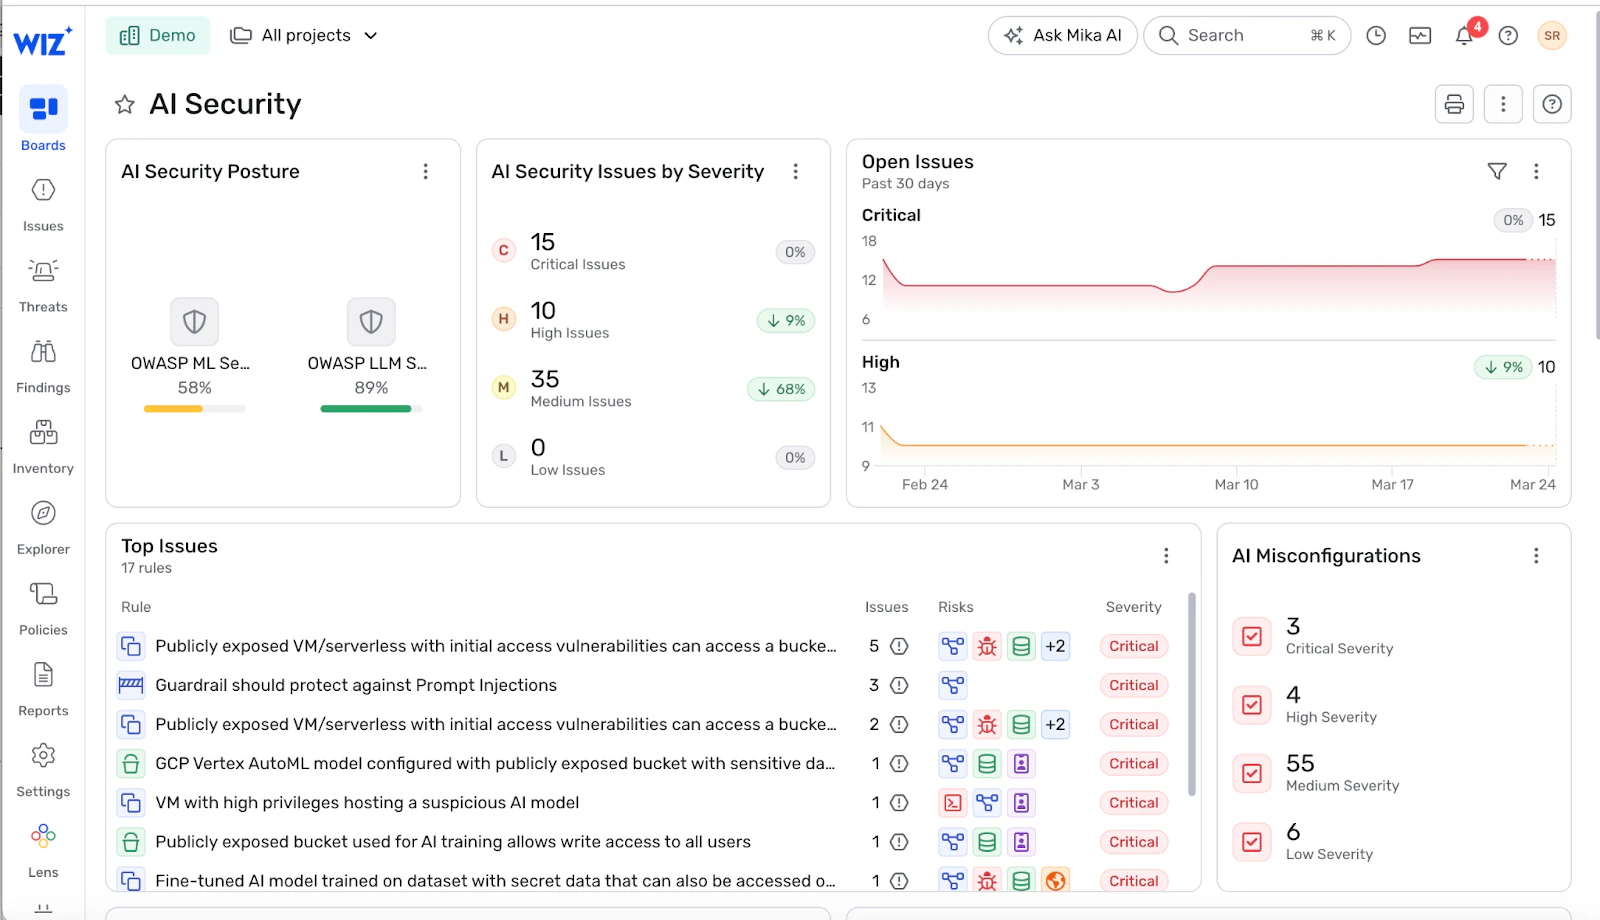
Wiz verschafft Sicherheitsteams per Agentless-Scanning Transparenz über KI-Services, Modelle und die zugrunde liegenden Cloud-Ressourcen in AWS, Azure und Google Cloud. Abgedeckt sind verwaltete KI-Plattformen ebenso wie eigene KI-Workloads in Kubernetes, auf virtuellen Maschinen oder in Serverless-Services. Dafür sind keine Agenten nötig, und die Modell-Performance bleibt unberührt.
Der entscheidende Faktor ist Kontext. Wiz verknüpft KI-Fehlkonfigurationen mit Identitätsberechtigungen, Netzwerkerreichbarkeit und Datensensibilität. So zeigt sich, wie einzelne Probleme zu echten Angriffspfaden zusammenwachsen.
Statt isolierter Befunde wie „öffentlicher Endpunkt“ oder „überprivilegierte Rolle“ zeigt Wiz, wo sich diese Bedingungen überschneiden. Ein Beispiel ist ein offener Inferenz-Endpunkt, dessen Service-Identität auf sensible Trainingsdaten zugreifen kann.
Auf dieser Grundlage priorisieren Sicherheitsteams KI-Fehlkonfigurationen nach tatsächlichem Risiko und geschäftlicher Auswirkung statt nur nach Schweregrad. Auf einen Blick ist erkennbar, welche KI-Services erreichbar sind, worauf sie zugreifen können und welche Fehlkonfigurationen den Schadensradius spürbar vergrößern.
Genpact hat mit Wiz AI-SPM alle eigenen KI-Services erfasst und offene Endpunkte mit Verbindung zu sensiblen Trainingsdaten identifiziert. Gleichzeitig reduzierte das Unternehmen risikoreiche KI-Fehlkonfigurationen und brachte neue KI-Anwendungen schneller in den Betrieb.
Außerdem führt Wiz KI-Fehlkonfigurationen auf ihren Ursprung zurück. Taucht in der Produktion ein riskanter KI-Endpunkt auf, lässt er sich bis zur Infrastruktur oder Pipeline zurückverfolgen, die ihn erzeugt hat. Teams beheben so die Ursache, statt immer wieder Symptome zu behandeln.
Diese Code-to-Cloud-Transparenz hilft zu verhindern, dass Fehlkonfigurationen wiederkehren, während sich KI-Umgebungen weiterentwickeln.
Wiz integriert die Erkennung von KI-Fehlkonfigurationen in bestehende Cloud-Sicherheitsworkflows. Unternehmen steuern KI-Risiken so als Teil eines einheitlichen Cloud-Sicherheitsprogramms statt als isolierte Disziplin. Transparenz und Kontrolle bleiben erhalten, auch wenn die KI-Nutzung in Cloud-Umgebungen schnell wächst.
Erfahren Sie, wie Wiz Ihnen helfen kann, KI-Fehlkonfigurationen im Kontext von Identitäten, Netzwerken und sensiblen Daten zu bewerten und zu priorisieren. Wiz in Aktion erleben