
Bestandteile der KI-Lieferkette
Die KI-Lieferkette umfasst alles, was aus Rohdaten ein produktives KI-System macht. Sie beginnt lange vor dem Deployment eines Modells und reicht über Training und Packaging bis zur Inferenz. Jede Phase hängt von der Integrität der vorherigen ab, deshalb können sich Schwachstellen durch das gesamte System ziehen.
Das Fundament bildet die Datenebene. Dazu gehören die Datasets für Training und Fine-Tuning sowie die Pipelines, die Daten zwischen Systemen bewegen. Hinzu kommen Labeling- und Anreicherungsdienste, die prägen, wie Modelle lernen. Diese Datasets enthalten oft sensible oder proprietäre Informationen und sind deshalb ein häufiges Ziel für Manipulation oder Exfiltration.
Darauf folgt die Entwicklungsebene, auf der Modelle entworfen und trainiert werden. Sie umfasst Modellarchitekturen, Trainings-Frameworks wie PyTorch oder TensorFlow, Systeme für Experiment-Tracking und die Arbeitsumgebungen der Data-Science-Teams. Sicherheitsprobleme sehen hier nicht immer wie klassische Schwachstellen aus. Missbrauchte Zugangsdaten, unsichere Serialisierung oder nicht vertrauenswürdige Abhängigkeiten können Risiken einführen, bevor ein Modell die Produktion erreicht.
Die Ebene der Modellartefakte verwaltet die Outputs des Trainings. Trainierte Modelle, Gewichte, Konfigurationsdateien und Metadaten liegen in Registries und Versionierungssystemen, damit Teams sie prüfen, freigeben und ausrollen können. Fehlen Signaturen, Integritätsprüfungen und Zugriffskontrollen, können Angreifer Modelle austauschen oder verändern, ohne dass die Kompromittierung auffällt.
Auf der Deployment- und Inferenzebene werden Modelle paketiert und bereitgestellt. Dazu gehören Container-Images, Serving-Runtimes, Orchestrierungsplattformen wie Kubernetes, API-Gateways und Inferenz-Endpunkte. Authentifizierung, Autorisierung, Rate Limiting und verschlüsselte Übertragung bestimmen, wer ein Modell aufrufen darf und worauf es im laufenden Betrieb zugreift. Transparenz über Endpunkte, Identitäten und Netzwerkpfade ist hier entscheidend, denn die tatsächliche Erreichbarkeit zeigt sich selten allein in der Konfiguration.
Schließlich hängen die meisten KI-Systeme von Komponenten aus Drittquellen ab. Dazu zählen vortrainierte Modelle und Gewichte aus öffentlichen Hubs, Open-Source-Bibliotheken, Tokenizer, Konfigurationsdateien, kommerzielle KI-APIs, Vektordatenbanken und verwaltete KI-Dienste. Weil diese Komponenten tief in Trainings- und Inferenz-Workflows eingebunden sind, kann sich eine vorgelagerte Kompromittierung unbemerkt bis in die Produktion ausbreiten.
Besonders anspruchsvoll wird die KI-Lieferkette dadurch, dass diese Ebenen eng miteinander verbunden sind. Ein vergiftetes Dataset kann ein Modell korrumpieren. Ein manipuliertes Modell kann bei der Inferenz Daten preisgeben, und ein Deployment mit zu weit gefassten Berechtigungen kann alles Nachgelagerte offenlegen. Wer die KI-Lieferkette absichern will, muss diese Abhängigkeiten verstehen, statt jede Komponente isoliert zu schützen.
Wachsende Bedeutung der KI-Lieferkettensicherheit
KI-Lieferkettensicherheit rückt in den Fokus, weil KI auf eine Weise entwickelt und ausgerollt wird, die für die meisten Unternehmen neu ist. Teams beziehen Modelle, Daten und Tools aus vielen Quellen, verbinden sie schnell miteinander und stellen sie über APIs bereit. Oft fehlt dabei ein klares Bild davon, welchen Komponenten sie unterwegs vertrauen.
Vor einigen Jahren lief KI meist in Forschungsumgebungen. Heute laufen dieselben Modelle in der Produktion und sind mit Kundendaten, internen Systemen und automatisierten Entscheidungsprozessen verbunden. Damit steigt die Tragweite: Ein kompromittiertes Modell ist mehr als ein technisches Problem, denn es kann sich direkt auf Nutzende, Ergebnisse und Geschäftsabläufe auswirken.
Auch die Art, wie KI zusammengesetzt wird, lässt Lieferkettenrisiken leichter untergehen. Moderne KI-Systeme stützen sich auf vortrainierte Modelle, Open-Source-Bibliotheken, Trainings-Datasets, Vektordatenbanken und verwaltete Cloud-Dienste. Vieles davon ist eine Blackbox. Teams wissen vielleicht, was sie einsetzen, aber nicht, woher es stammt, wie es trainiert wurde oder worauf es nach dem Deployment zugreifen kann.
Gleichzeitig ist die Angriffsfläche gewachsen. Modelle sind heute meist über Inferenz-Endpunkte, Chat-Oberflächen und APIs erreichbar. Angreifer brauchen also weder Quellcode noch Dateizugriff, um mit KI-Systemen zu interagieren, denn sie können sie direkt sondieren. In manchen Fällen reicht das bereits, um Modellverhalten zu extrahieren, auf Trainingsdaten zu schließen oder unsichere Aktionen auszulösen.
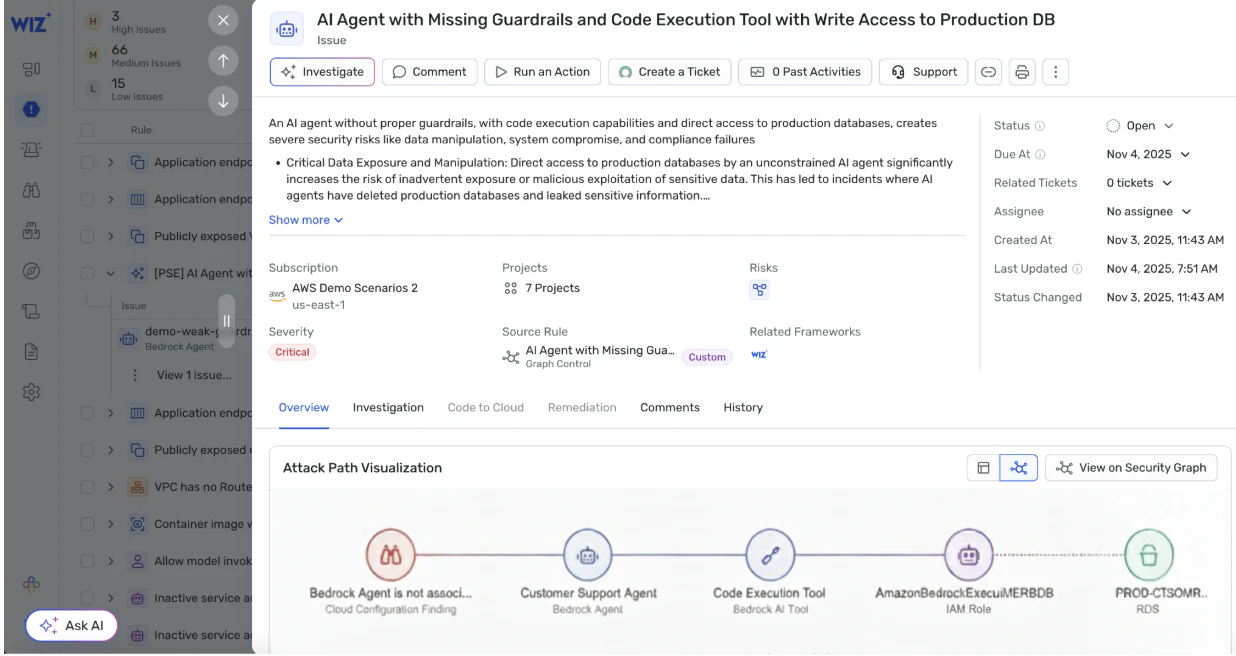
Erschwerend kommt hinzu, dass Probleme nicht immer wie Fehler aussehen. Ein vergiftetes Dataset oder ein Modell mit Backdoor kann sich die meiste Zeit völlig normal verhalten. Auffälligkeiten zeigen sich womöglich nur bei bestimmten Eingaben oder Bedingungen. Deshalb rutschen sie beim Testen leicht durch und sind nach dem Deployment schwer zu diagnostizieren.
Auch die Erwartungen verändern sich. Regulierungsbehörden, Kundschaft und Partnerunternehmen wollen zunehmend klare Antworten darauf, woher KI-Systeme stammen und wie sie kontrolliert werden. Fragen zu Herkunft, Integrität und Verantwortlichkeit sind längst nicht mehr theoretisch: Sie tauchen in Audits, Beschaffungsprüfungen und Kundengesprächen auf.
Kurz gesagt gewinnt KI-Lieferkettensicherheit an Bedeutung, weil KI-Systeme heute vernetzter, leichter erreichbar und folgenreicher sind als noch vor kurzer Zeit. Je mehr Unternehmen KI für echte Arbeit einsetzen, desto unverzichtbarer wird es, ihren Aufbau zu verstehen und abzusichern.
Einfallstore für Angriffe auf die KI-Lieferkette
Die meisten Angriffe auf die KI-Lieferkette beginnen unspektakulär. Am Anfang stehen kleine Kompromittierungen vertrauenswürdiger Komponenten wie Trainingsumgebungen, Abhängigkeiten oder Modellartefakte. Von dort wandern sie still bis in die Produktion.
Ein häufiger Einstiegspunkt ist die Trainings- und Runtime-Umgebung selbst. KI-Workloads nutzen oft hochprivilegierte GPU-Treiber, Container-Runtimes und Low-Level-Bibliotheken. Wiz Research hat gezeigt, wie Schwachstellen in KI-naher Infrastruktur ganze Umgebungen offenlegen können. Angreifer können so Berechtigungen ausweiten oder auf sensible Workloads in gemeinsam genutzten Systemen zugreifen.
Ein weiterer häufiger Angriffspfad führt über Open-Source-KI-Bibliotheken und -Repositories. Viele KI-Teams beziehen verbreitete Frameworks und Tools direkt aus Repositories auf GitHub oder aus Paket-Registries. In realen Vorfällen, die Wiz Research untersucht hat, kompromittierten Angreifer weit verbreitete KI-Bibliotheken und schleusten Schadcode ein, der nach dem Deployment Kryptomining betrieb. Der Code verbreitete sich unbemerkt in Trainings- und Inferenzumgebungen.
Auch Modellartefakte und serialisierte Dateien sind ein Bereich mit hohem Risiko. Trainierte Modelle gelten oft als statische Ressourcen, doch unsichere Serialisierungsformate können beim Laden eines Modells Code ausführen. Wiz Research hat Supply-Chain-Angriffe dokumentiert, bei denen schädliche Payloads in vertrauenswürdige Artefakte eingebettet wurden. So wird der Ladevorgang des Modells selbst zum Ausführungsvektor.
Lieferkettenrisiken entstehen außerdem über Integrationen und Abhängigkeiten von Drittanbietern. KI-Pipelines laden regelmäßig externe Modelle, Gewichte, Tokenizer und Konfigurationsdateien. Kompromittieren Angreifer eine vorgelagerte Abhängigkeit, kann der Schadcode in KI-Workflows gelangen, ohne dass klassische Anwendungsschwachstellen ausgenutzt werden müssen.
Offen erreichbare Inferenz-Endpunkte ermöglichen Angreifern schließlich die direkte Interaktion mit Modellen. Auch ohne Zugriff auf Infrastruktur oder Quellcode lassen sich Modelle mit wiederholten Abfragen sondieren, um ihr Verhalten zu extrahieren oder auf Trainingsdaten zu schließen. Solche Angriffe gehen leicht im normalen Datenverkehr unter und sind ohne kontextbezogenes Monitoring schwer zu erkennen.
Heikel sind diese Angriffe vor allem, weil sie sich so gut tarnen. Eine kompromittierte Abhängigkeit sieht weiterhin wie eine legitime Bibliothek aus. Ein vergiftetes Modell verhält sich die meiste Zeit normal, und eine verwundbare Runtime-Komponente arbeitet wie erwartet, bis sie ausgenutzt wird. Angreifer müssen nicht die gesamte KI-Pipeline kompromittieren: Ein einziges vertrauenswürdiges Glied genügt, den Rest erledigt die Lieferkette.
Herausforderungen bei der Absicherung der KI-Lieferkette
Eine der größten Herausforderungen besteht schlicht darin, zu wissen, was überhaupt existiert. KI-Ressourcen entstehen oft außerhalb klassischer Software-Workflows, etwa in Data-Science-Teams, Experimentier-Notebooks oder Ad-hoc-Pipelines. Modelle, Datasets und Endpunkte tauchen schnell in Cloud-Konten auf, ohne je eine zentrale Sicherheitsprüfung zu durchlaufen. So entsteht Schatten-KI, die sich nur schwer inventarisieren oder steuern lässt.
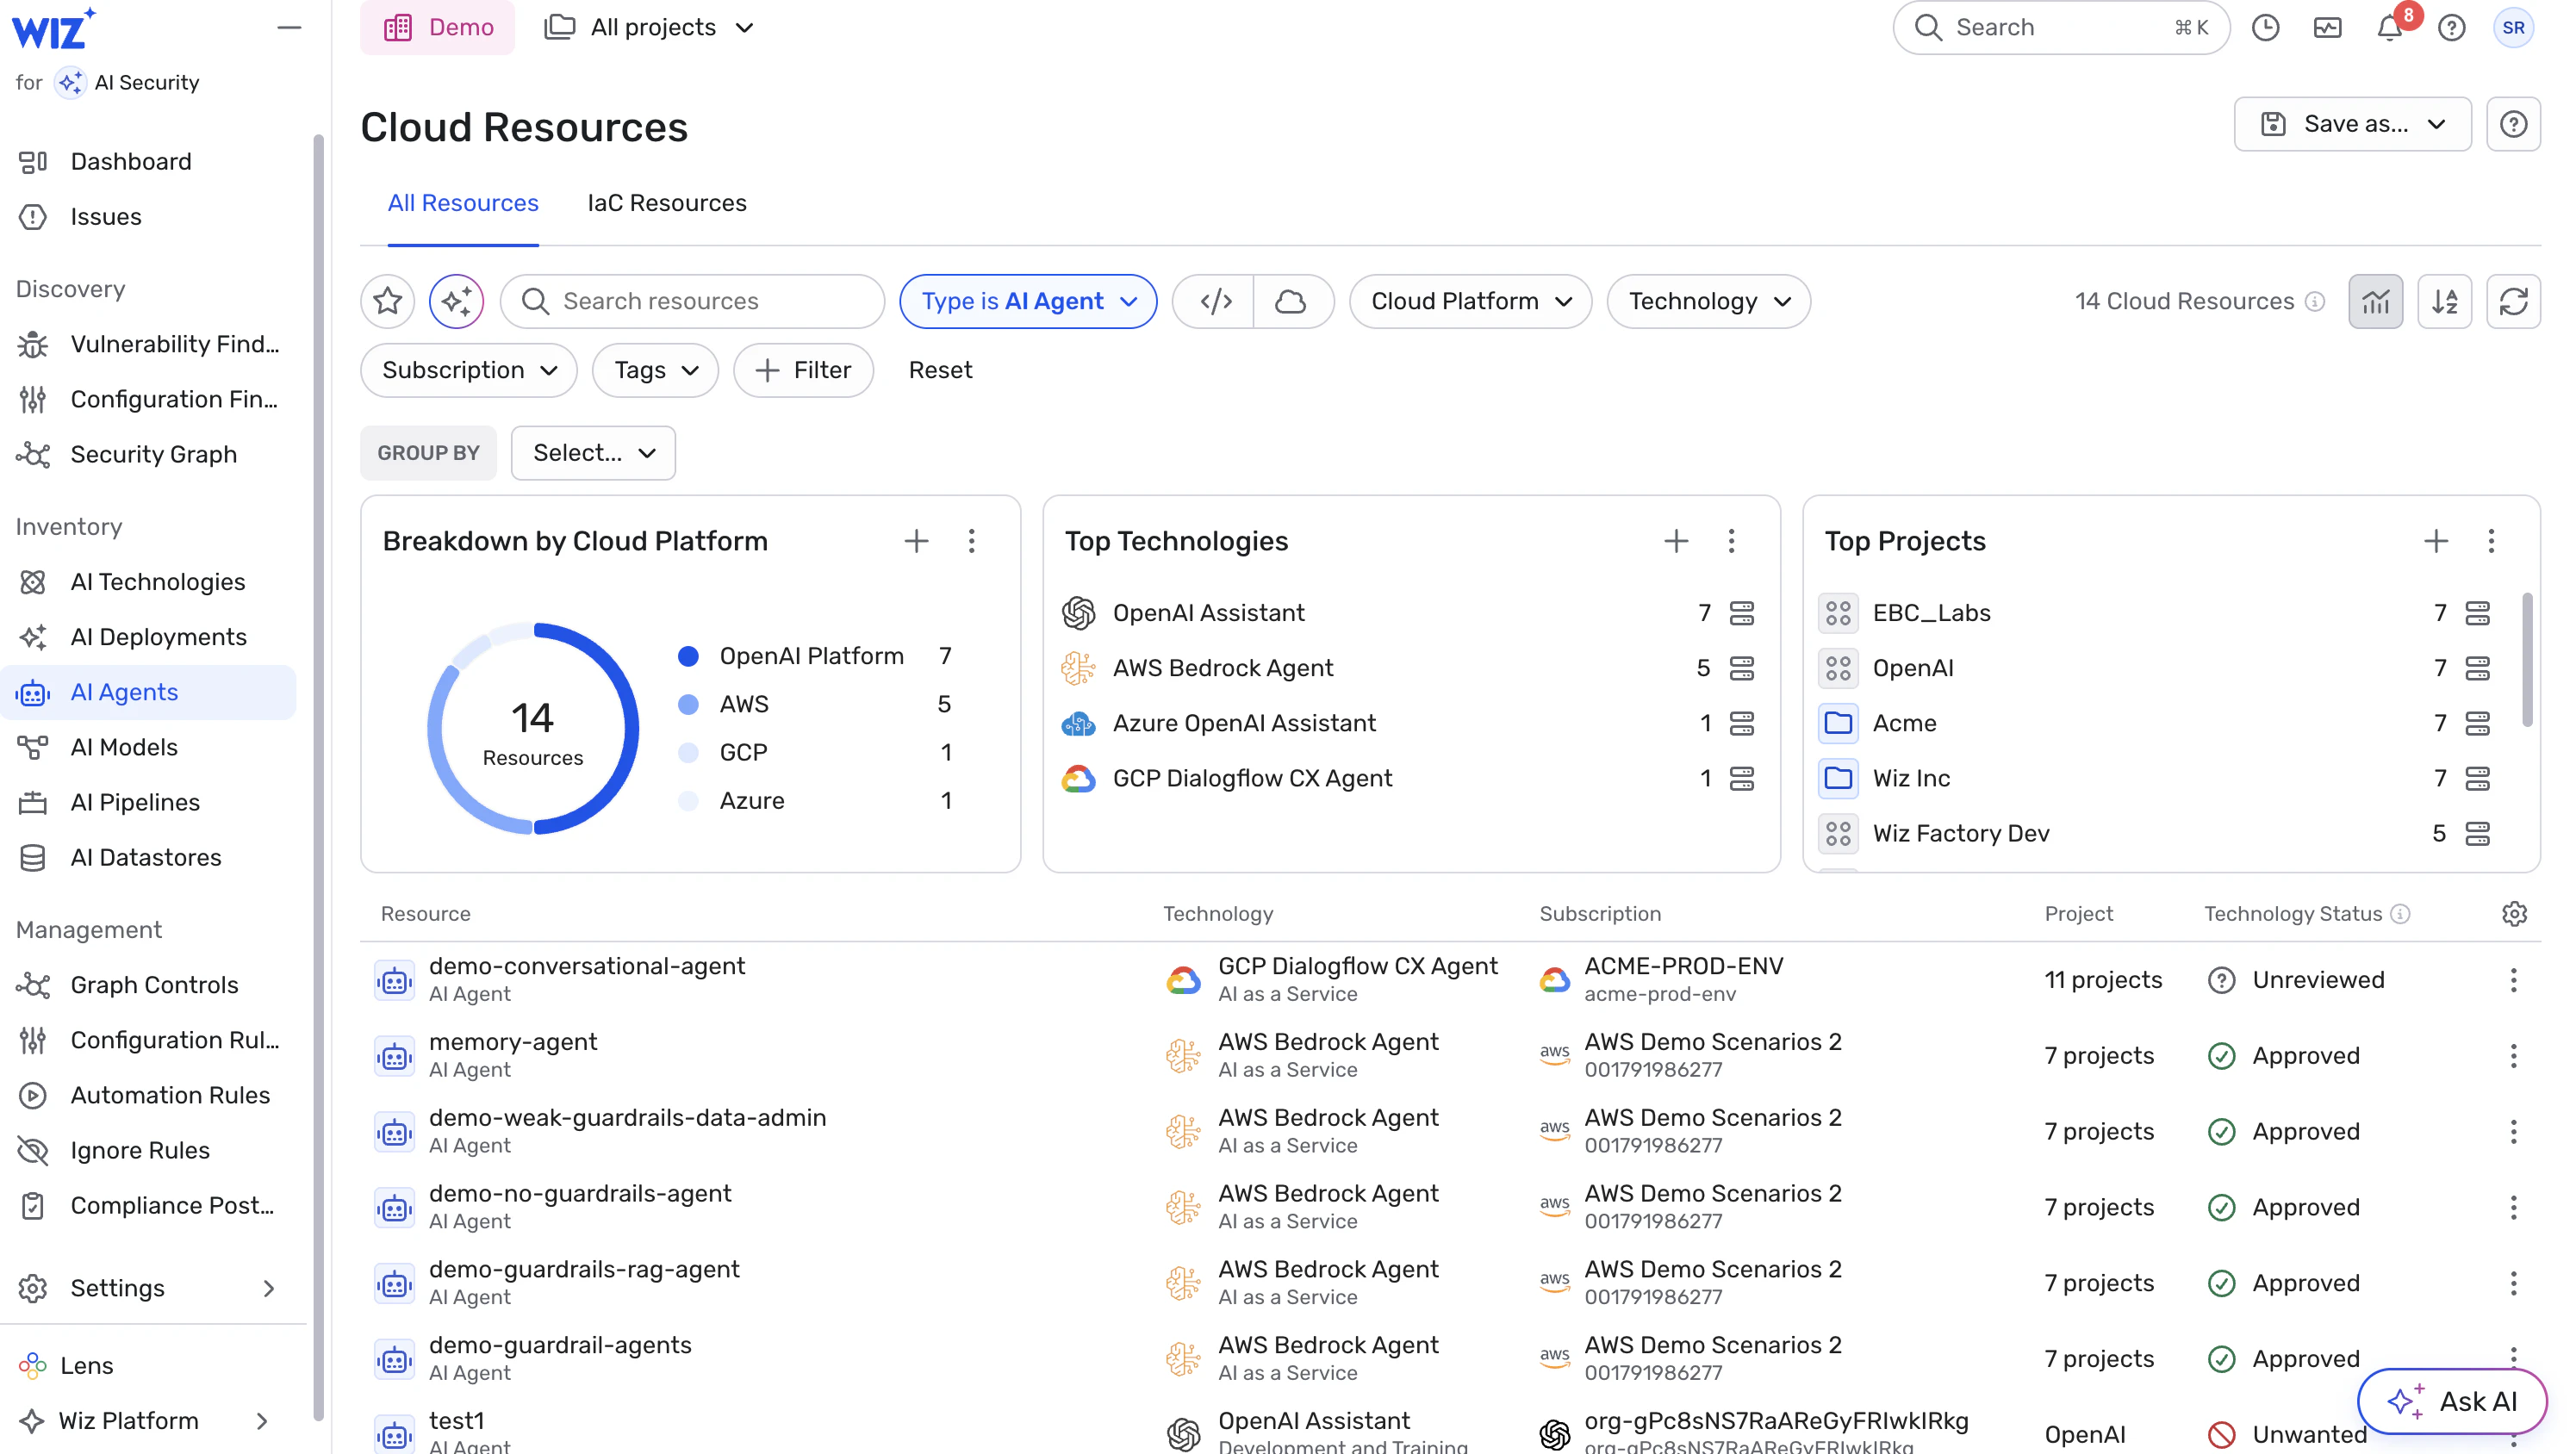
Selbst wenn alle Ressourcen bekannt sind, erschwert die Komplexität der Abhängigkeiten eine fundierte Risikobewertung. Ein KI-System kann von bestimmten Versionen von Open-Source-Bibliotheken, GPU-Treibern, Trainings-Frameworks, vortrainierten Gewichten und externen Datenquellen abhängen. Eine Schwachstelle auf einer beliebigen Ebene, ob Code, Daten oder Infrastruktur, kann das gesamte System untergraben. Trotzdem werden diese Abhängigkeiten selten gemeinsam an einem Ort erfasst.
Kurzlebige Trainingsumgebungen erschweren die Lage zusätzlich. Große Trainingsjobs können für kurze Zeit Tausende GPU-gestützte Instanzen starten, die danach wieder verschwinden. Klassische Sicherheitstools, die auf dauerhaft laufende Agenten oder manuelle Prüfungen setzen, übersehen solche Umgebungen oft komplett. Dadurch entstehen Transparenzlücken in einigen der sensibelsten Phasen des KI-Lebenszyklus.
Auch die Validierung von Modellen und Artefakten aus Drittquellen ist anspruchsvoll. Öffentliche Model Hubs und Repositories erleichtern die Wiederverwendung bestehender Arbeit, geben aber nur begrenzt Aufschluss über Trainingsweise, verwendete Daten oder nachträgliche Veränderungen an Artefakten. Ohne belastbare Kontrollen für Herkunft und Integrität müssen Teams undurchsichtigen Komponenten in kritischen Systemen vertrauen.
Die Erkennung wird durch das probabilistische Verhalten von KI erschwert. Ein kompromittiertes Modell kann weiterhin plausible Outputs liefern, sodass sich natürlicher Drift, Performance-Probleme und gezielte Manipulation kaum unterscheiden lassen. Anders als bei klassischer Software gibt es oft keinen einzelnen „korrekten“ Output, an dem sich das Ergebnis validieren lässt.
Organisatorische Reibung spielt ebenfalls eine Rolle. KI-Systeme betreffen Data-Science-, Engineering-, Sicherheits- und Plattform-Teams, die jeweils eigene Prioritäten und Tools haben. Ohne gemeinsame Transparenz und klare Zuständigkeiten fallen Lieferkettenrisiken leicht zwischen die Teams, statt durchgängig behandelt zu werden.
Multi-Cloud-Umgebungen machen die Absicherung von KI-Lieferketten in großem Maßstab noch schwieriger. KI-Workloads verteilen sich oft auf mehrere Anbieter, um bestimmte Dienste oder Hardware zu nutzen, was konsistente Richtlinien und Kontrollen erschwert. Ohne einheitliche Sicht sichern Teams womöglich einzelne Umgebungen ab, übersehen aber cloudübergreifende Angriffspfade.
KI-Lieferkettensicherheit als Teil der Cloud-Sicherheit
KI-Lieferkettensicherheit ist keine von der Cloud-Sicherheit getrennte Disziplin, beschränkt sich aber auch nicht allein auf die Cloud. Manche Unternehmen betreiben On-Premises-Trainingscluster, Edge-Inferenz oder hybride Deployments, um Kosten, Latenz oder Datenresidenz zu steuern. Trotzdem laufen die meisten modernen KI-Lieferketten letztlich in der Cloud-Infrastruktur zusammen.
Selbst wenn Modelle außerhalb der Cloud trainiert oder ausgerollt werden, durchlaufen kritische Teile des Workflows sie häufig. Trainingsdaten liegen zwischenzeitlich in Cloud-Speicher, und Modelle stammen aus Registries in der Cloud. Pipelines werden über verwaltete Dienste orchestriert, oder Inferenzsysteme authentifizieren sich über Cloud-Identitäten. Deshalb zeigen sich Risiken in der KI-Lieferkette oft über Cloud-Berechtigungen, Netzwerkerreichbarkeit und Datenzugriffspfade.
Umgekehrt haben nicht alle Risiken der KI-Lieferkette einen Cloud-Native-Ursprung. Kompromittierte Open-Source-Modellgewichte, vergiftete Datasets von Drittanbietern oder Schwachstellen in ML-Frameworks können Risiken einführen, bevor überhaupt Cloud-Infrastruktur beteiligt ist. Solche Probleme entstehen früher im Lebenszyklus und begleiten Modelle überallhin, wo sie laufen.
Entscheidend wird die Cloud, weil sich diese Risiken dort bündeln und gegenseitig verstärken. Ein manipuliertes Modell richtet den größten Schaden an, wenn es hinter einem öffentlichen Endpunkt läuft. Ein vergiftetes Dataset wirkt am stärksten, wenn damit Modelle neu trainiert werden, die mit sensiblen Produktionsdaten arbeiten. Und ein verwundbares ML-Framework wird zum ernsthaften Sicherheitsvorfall, wenn es unter einer überprivilegierten Cloud-Identität läuft.
Deshalb ist KI-Lieferkettensicherheit so eng mit zentralen Cloud-Sicherheitspraktiken verknüpft. Das Management des Cloud-Sicherheitsstatus regelt, wie Trainingsdaten und Modellartefakte gespeichert werden. Identitäts- und Zugriffsmanagement steuert, wer und was mit Modellen und Pipelines interagieren darf. Datensicherheit schützt sensible Datasets, Embeddings und Inferenz-Logs, während Schwachstellenmanagement die Container, Images und Abhängigkeiten für Training und Serving absichert.
Neu bei KI ist, wie eng diese Ebenen miteinander gekoppelt sind. Eine sichere Cloud-Umgebung kann durch ein unsicheres Modellartefakt dennoch untergraben werden. Ein hochwertiges Modell wird zum Risiko, wenn es mit übermäßigen Berechtigungen läuft. Risiken in der KI-Lieferkette zeigen sich selten als einzelner Fehler, sondern entstehen aus dem Zusammenspiel von Daten, Modellen, Abhängigkeiten, Identitäten und Zugriffswegen.
Für die meisten Unternehmen bedeutet wirksame KI-Lieferkettensicherheit, bestehende Cloud-Sicherheits-Workflows um KI-spezifische Ressourcen und Abhängigkeiten zu erweitern. Risiken mit Ursprung außerhalb der Cloud bleiben dabei im Blick. Kontinuierliche Transparenz darüber, wie Modelle, Daten, Infrastruktur und Identitäten zusammenhängen, hilft Teams, Lieferkettenrisiken früh zu erkennen, bevor sie Produktionssysteme und geschäftskritische Entscheidungen erreichen.
Absicherung der KI-Lieferkette mit Wiz
Wiz unterstützt Unternehmen dabei, den KI-Sicherheitsstatus entlang der gesamten KI-Lieferkette abzusichern. KI-Ressourcen, Infrastruktur und offen zugängliche Daten werden in derselben Plattform transparent, die Teams bereits für Cloud-Risiken nutzen. Wiz ersetzt weder Modell-Governance noch Fairness-Prüfungen oder regulatorische Konformitätsbewertungen, schließt aber eine wichtige Lücke: Die Plattform zeigt, wie KI-Systeme in realen Cloud-Umgebungen tatsächlich offengelegt, missbraucht oder ausgenutzt werden können.
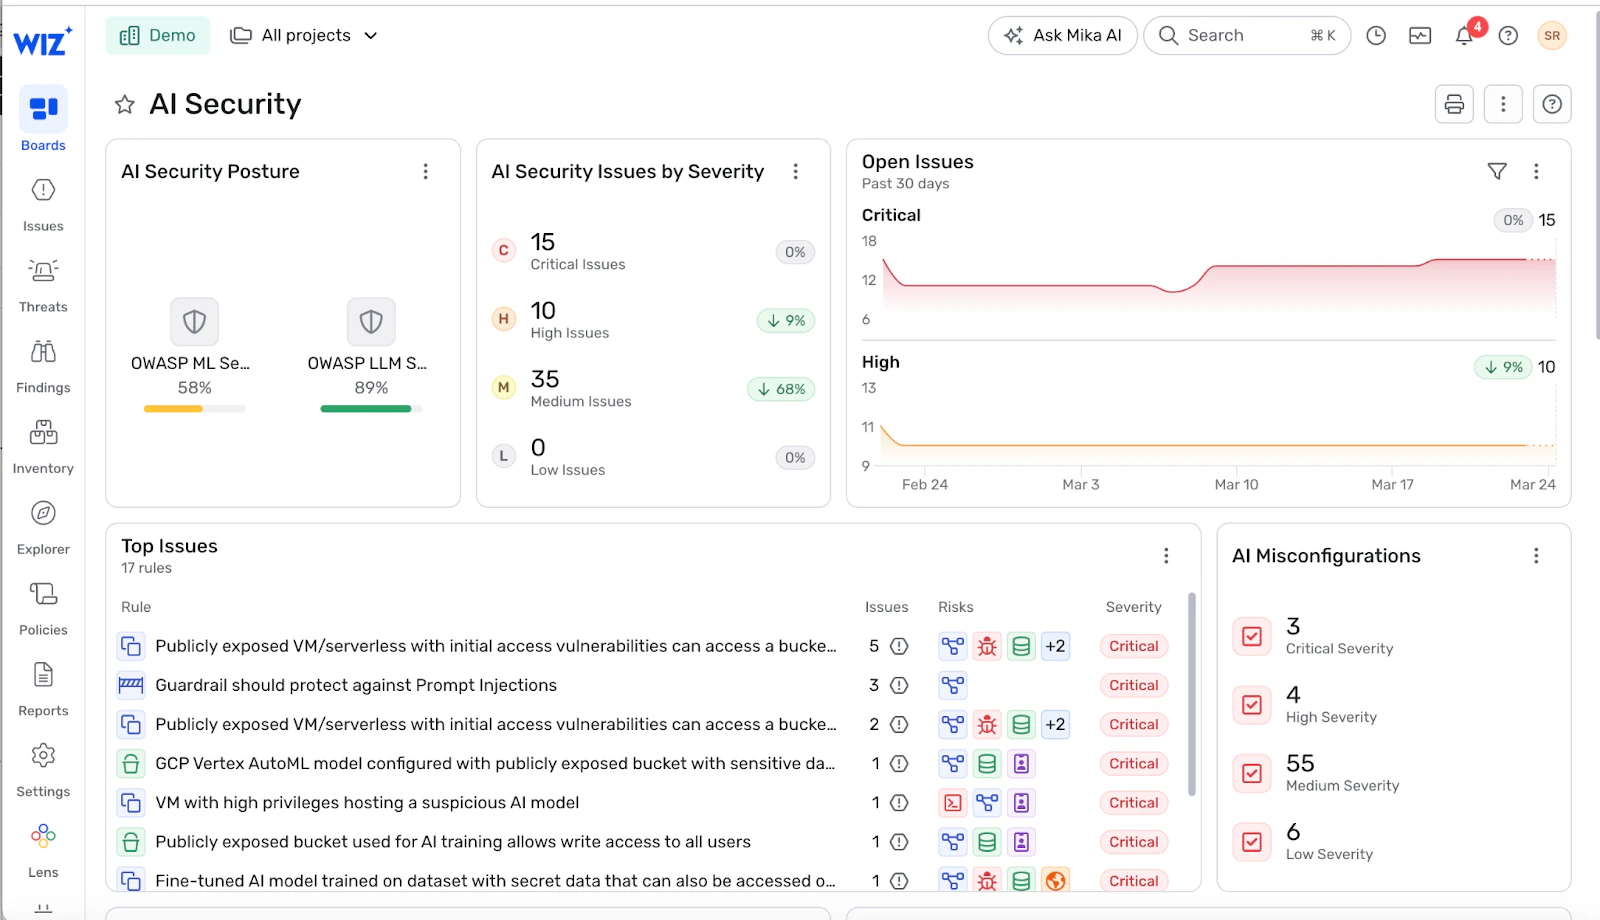
Mit einem Agentless-Ansatz erkennt Wiz kontinuierlich KI-Dienste, Trainingsumgebungen, Modell-Endpunkte, Speicherorte und unterstützende Infrastruktur in AWS, Azure und GCP. Dazu gehören verwaltete Plattformen wie Amazon SageMaker und Bedrock, Azure OpenAI Service und Azure Machine Learning sowie Google Vertex AI. Ebenso erfasst werden eigene KI-Workloads auf Kubernetes oder virtuellen Maschinen.
Aus dieser Erkennung entsteht eine AI Bill of Materials (AI-BOM). Damit inventarisieren Teams Modelle, Datasets, Pipelines, Identitäten und Dienste und decken Schatten-KI auf, die außerhalb der Standardkontrollen liegt.
Über den Security Graph verknüpft Wiz diese KI-Ressourcen mit Cloud-Kontext wie Identitäten, Netzwerkerreichbarkeit, Schwachstellen und sensiblen Daten. Statt einzelne Fehlkonfigurationen zu melden, zeigt Wiz Angriffspfade auf, also Kombinationen aus Erreichbarkeit, Berechtigungen und Datenzugriff, die aus kleinen Problemen echte Lieferkettenrisiken machen. So sehen Teams, welche KI-Komponenten sich missbrauchen ließen, um Daten zu exfiltrieren, sich innerhalb des Netzwerks auszubreiten (Lateral Movement) oder unbefugten Zugriff auf KI-gestützte Systeme zu erlangen.
Wiz unterstützt die KI-Lieferkettensicherheit zudem über den gesamten Lebenszyklus. Die durchgängige Transparenz von code to cloud führt offen erreichbare KI-Dienste auf die Pipelines oder Infrastructure-as-Code-Definitionen zurück, die sie eingeführt haben, damit Teams sie nachhaltig beheben können. Zur Runtime überwacht Wiz Defend die KI-Infrastruktur auf Missbrauchsmuster wie zweckentfremdete Service-Identitäten, Datenexfiltration oder Kryptomining. Im Fokus steht dabei, wie KI die Angriffsfläche in der Cloud vergrößert, nicht die Bewertung von Modell-Outputs.
Erfahren Sie, wie Wiz Teams dabei unterstützt, KI-Ressourcen, Cloud-Kontext und potenzielle Angriffspfade entlang der KI-Lieferkette transparent zu machen. Wiz in Aktion erleben