
Adversarial AI im Überblick
Adversarial AI ist eine Form des Cyberangriffs, bei der leicht veränderte Daten in Systeme für künstliche Intelligenz (KI) und Machine Learning (ML) eingespeist werden. Das Ziel: Die Systeme sollen falsche Entscheidungen treffen.
Diese Angriffe machen genau die Fähigkeiten zur Waffe, die KI so wertvoll machen. Angreifer entwickeln schädliche Eingaben, um Guardrails zu umgehen, Trainingsdaten zu vergiften oder sensible Informationen aus dem Modellverhalten abzuleiten. Das Ergebnis sind KI-Systeme, die scheinbar normal funktionieren, aber unbemerkt die Ziele der Angreifer verfolgen.
Laufen diese Systeme in der Cloud, ist Adversarial AI selten ein reines Modellproblem. Meist hängt sie mit konkreten Cloud-Fragen zusammen: Wer darf den Endpunkt aufrufen, welche Daten kann das Modell lesen und was erreicht der Hosting-Workload, wenn er kompromittiert wird? Genau dieses Zusammenspiel macht Adversarial AI so gefährlich.
Gefahrenpotenzial von Adversarial-AI-Angriffen
KI hält rasant Einzug in geschäftskritische Systeme. Dadurch ist Adversarial AI zu einer dringenden Sicherheitspriorität geworden. Steuert KI die Betrugserkennung, autonome Fahrzeuge oder kundennahe Anwendungen, kann ein erfolgreicher Angriff realen Schaden in großem Maßstab anrichten.
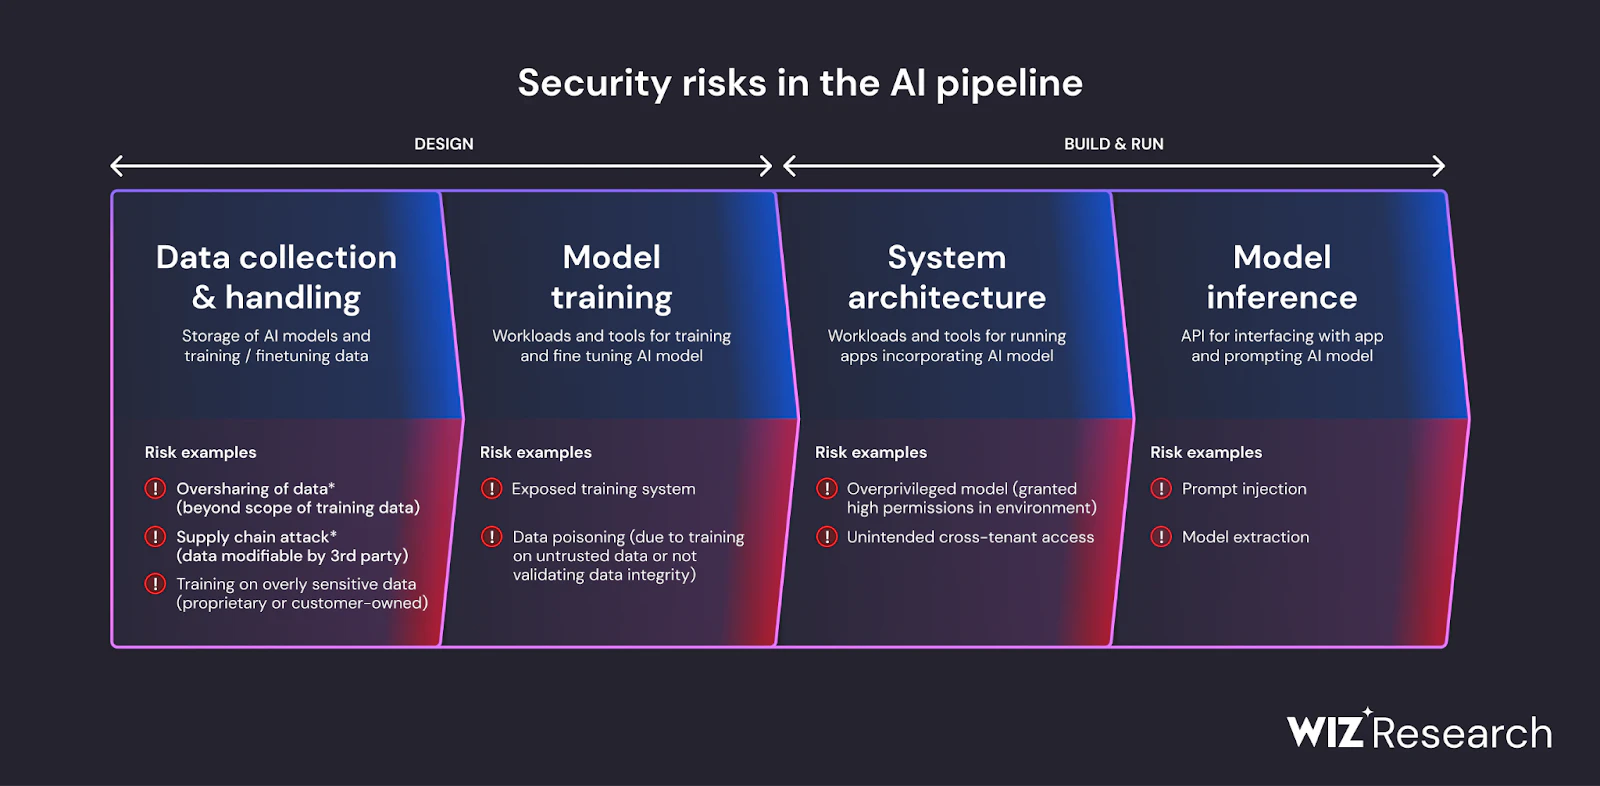
Laut einer Studie von Wiz nutzen 87 % der Sicherheitsfachkräfte KI-Services in irgendeiner Form. Jedes KI-Deployment kann dabei potenzielle Einfallstore für Adversarial-Manipulation öffnen, wie die folgende Abbildung zeigt:
Besonders gefährlich sind Adversarial-AI-Angriffe ohne offensichtliche Ausfälle. Gemeint sind subtile Manipulationen, die die Integrität eines Modells über längere Zeit untergraben und dabei unentdeckt bleiben. Angreifer umgehen Guardrails, ohne Alarme auszulösen, sodass kompromittierte Modelle unbemerkt in die Produktion gelangen.
Damit Unternehmen die Feinheiten und Risiken von Adversarial AI besser verstehen, hat MITRE die Adversarial Threat Landscape for Artificial Intelligence Systems (ATLAS) veröffentlicht. MITRE ATLAS ist eine umfassende Wissensdatenbank mit 155 Techniken und 52 Fallstudien zu Methoden, mit denen Angreifer KI-Systeme attackieren. Organisationen können sich damit gezielt gegen die verschiedenen Arten und Taktiken von Adversarial AI absichern.
Arten von Adversarial AI
Adversarial-AI-Angriffe lassen sich nach dem Wissensstand der Angreifer in zwei große Kategorien einteilen:
White-Box-Angriffe: Der Angreifer kennt Architektur, Trainingsdaten und Parameter des Zielmodells im Detail. Dieser Zugriff auf Insider-Niveau ermöglicht hochpräzise Angriffe, setzt aber umfangreiche Aufklärung oder Insider-Zugang voraus.
Black-Box-Angriffe: Der Angreifer hat keinen direkten Einblick in die Interna des Modells und leitet Schwachstellen aus dem Input-Output-Verhalten ab. In der Praxis sind diese Angriffe häufiger, weil sie lediglich API-Zugriff auf das Zielsystem erfordern.
Die meisten realen Adversarial-AI-Vorfälle sind Black-Box-Angriffe. Welche Methoden Angreifer dabei einsetzen, hängt von ihren Zielen, der Angriffsart und der Infrastruktur des Opfers ab.
Verteidiger sollten deshalb davon ausgehen, dass ihre Modelle von außen abgetastet werden können, und ihre Abwehr entsprechend auslegen. Dazu gehört der Schutz vor konkreten Angriffsarten, die auf unterschiedliche Phasen des KI-Lebenszyklus abzielen:
Evasion-Angriffe: Angreifer verändern Eingaben so, dass das Modell sie falsch klassifiziert, während die Bedeutung für Menschen gleich bleibt. Evasion-Angriffe sind entweder gezielt, wenn ein bestimmter falscher Output erreicht werden soll, oder ungezielt, wenn jede Fehlklassifizierung dem Angreifer nützt.
Poisoning-Angriffe: Angreifer schleusen ungenaue und schädliche Daten in Trainings-Datasets ein, teils genügt schon die Kontrolle über wenige Dutzend Trainingsbeispiele. Das beeinflusst den Lernprozess des Systems und damit künftige autonome Entscheidungen und Outputs.
Transfer-Angriffe: Cyberkriminelle entwickeln ein Adversarial-AI-Modell für ein bestimmtes Opfer. Anschließend nutzen sie dieses Modell, um die KI- und ML-Systeme weiterer potenzieller Ziele zu kompromittieren.
Model-Extraction-Angriffe: Bedrohungsakteure stehlen proprietäre Machine-Learning-Algorithmen, um schnell und kostengünstig eigene illegale Kopien zu erstellen.
Byzantinische Angriffe: Angreifer legen ein verteiltes ML-System lahm, indem sie verschiedene Modelle und Komponenten mit manipulativen und widersprüchlichen Daten und Eingaben versorgen.
Trojaner-Angriffe auf KI: Täter verankern während der Trainingsphase einen Trigger im KI- oder ML-Modell. Das Modell funktioniert dadurch größtenteils normal und startet den eigentlichen Angriff erst, wenn der Trigger ausgelöst wird.
Model-Inversion-Angriffe: Angreifer analysieren die Outputs eines KI- oder ML-Modells, um Rückschlüsse auf Details der Trainingsdaten zu ziehen. Das geschieht typischerweise dann, wenn sie keinen Zugriff auf die Trainings-Datasets haben.
Membership-Inference-Angriffe: Bedrohungsakteure untersuchen KI- und ML-Modelle, um herauszufinden, ob die Trainingsdaten ausnutzbare sensible Informationen über Personen oder Institutionen enthalten.
Ablauf von Adversarial-AI-Angriffen
Viele klassische Cyberbedrohungen versuchen, die Fähigkeiten ihres Ziels zu umgehen. Adversarial-AI-Angriffe machen dagegen die inhärenten Fähigkeiten von KI zur Waffe. KI-Systeme treffen autonome Entscheidungen und erzeugen Outputs auf Basis von Trainingsdaten und Prompts, und genau das nutzen diese Angriffe aus.
Adversarial-AI-Angriffe folgen typischerweise einem strukturierten Ablauf:
Aufklärung: Angreifer untersuchen die KI-Systeme des Ziels, um Schwachstellen in Modellarchitekturen, Guardrails und der zugrunde liegenden Infrastruktur zu finden. Dazu zählen öffentliche Recherche ebenso wie Reverse Engineering des Modellverhaltens per API-Probing.
Gestaltung der Eingaben: Mit diesem Wissen entwickeln Angreifer schädliche Eingaben, die gezielt bestimmte Schwachstellen ausnutzen. Im Visier stehen Systeme, bei denen Genauigkeit entscheidend ist, etwa Betrugserkennung, Bilderkennung oder Natural Language Processing.
Ausnutzung: Die präparierten Eingaben gelangen ins System und korrumpieren das Modellverhalten. Die Folgen reichen von subtiler, unbemerkter Manipulation der Outputs bis zu großflächigen Ausfällen, die Geschäftsbetrieb und Reputation schädigen.
Eskalation: Während Verteidiger noch herausfinden, was schiefgelaufen ist, nutzen Angreifer die Verwirrung für Lateral Movement, für weitere Exploits oder für die Verbreitung KI-generierter Desinformation.
Adversarial-AI-Angriffe können den gesamten Weg eines KI- oder ML-Modells betreffen, von der Entwicklung bis zum Deployment.
Praxisbeispiele für Adversarial AI
Nach dem Überblick über die verschiedenen Angriffsarten folgen einige Beispiele aus der Praxis.
1. MadRadar
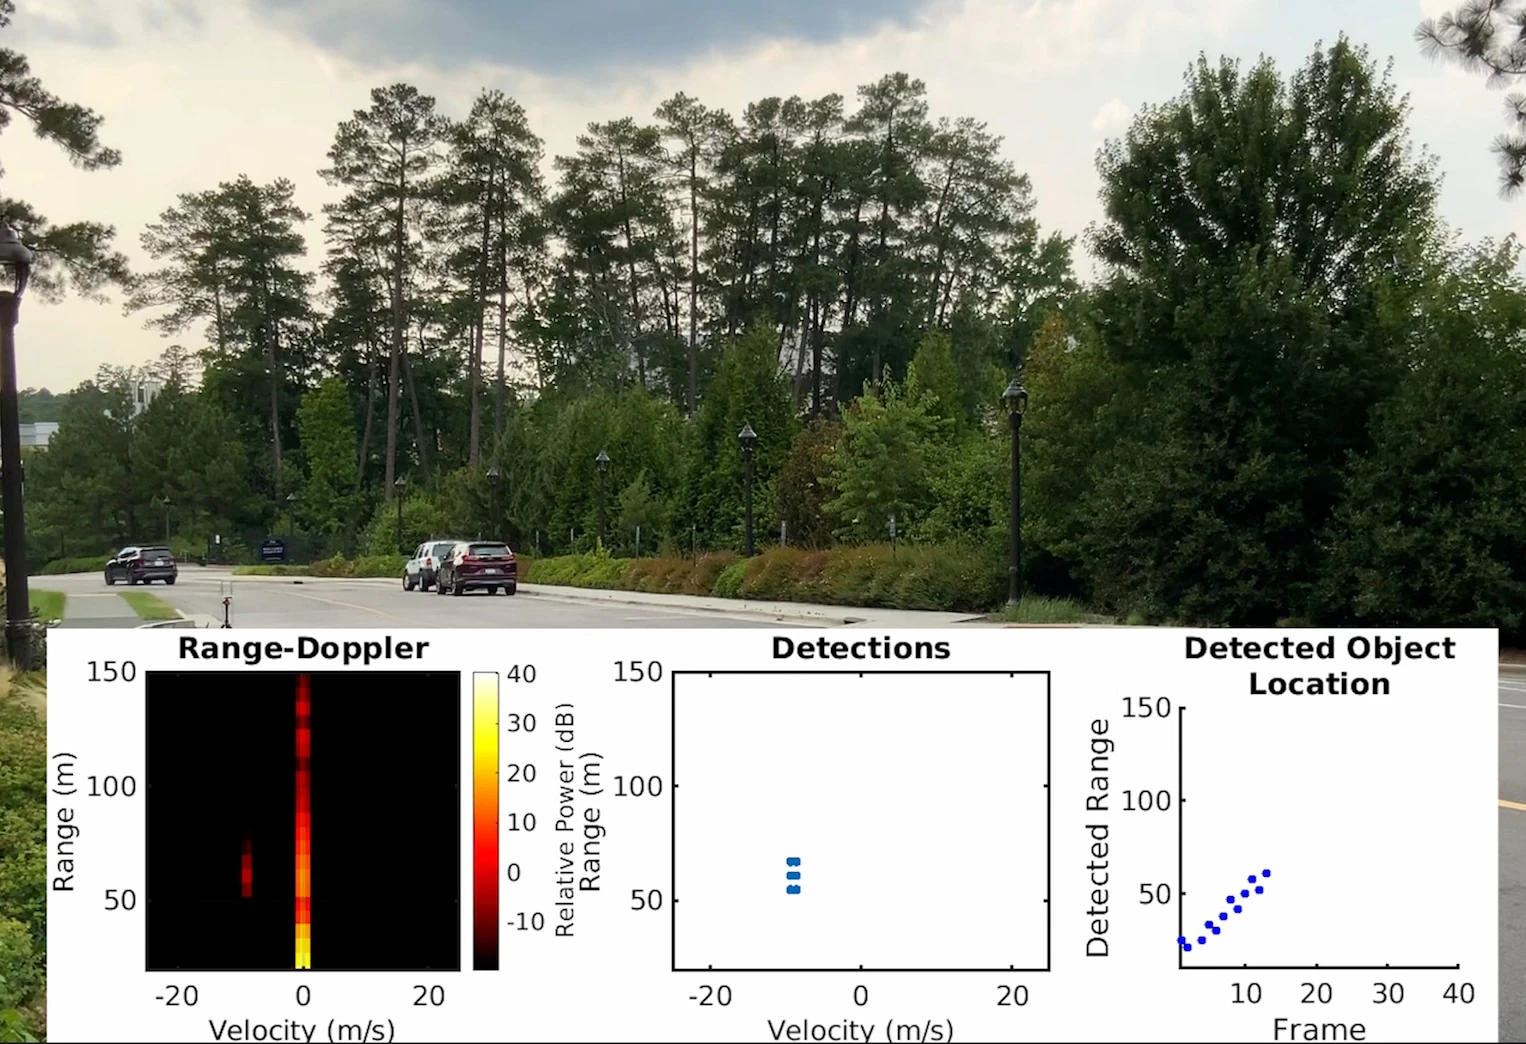
Ingenieure der Duke University haben die Radarsysteme autonomer Fahrzeuge gehackt und sie andere Autos „halluzinieren“ lassen. Würden Angreifer Fahrzeuge dazu bringen, Phantomfahrzeuge wahrzunehmen, könnte das schwere Unfälle verursachen.
2. Search Generative Experience von Google
Die genauen Gründe für die schädlichen Outputs sind unklar. Dennoch leitet die neue KI-Suchmaschine von Google Nutzer mitunter auf schädliche Links mit Malware weiter, was auf eine Form von Adversarial AI hindeutet. Besonders bedenklich ist, wie realistisch und glaubwürdig die KI-Suche gefährliche Informationen präsentiert.
3. EchoLeak in Microsoft 365 Copilot
Aim Labs entdeckte in Microsoft 365 Copilot eine Schwachstelle namens EchoLeak, die Schutzmaßnahmen gegen Prompt-Injection-Angriffe aushebelte. Über diese Lücke konnten Angreifer mit einer einzigen E-Mail auf sensible Daten zugreifen. Der Fall zeigt, wo KI-Agenten und Copilots potenziell verwundbar sind.
Best Practices für den Schutz vor Adversarial AI
Die Abwehr von Adversarial AI erfordert mehrstufige Kontrollmaßnahmen und Methoden zur Eindämmung der Folgen über den gesamten Modell-Lebenszyklus, von der Integrität der Trainingsdaten bis zum Runtime-Monitoring.
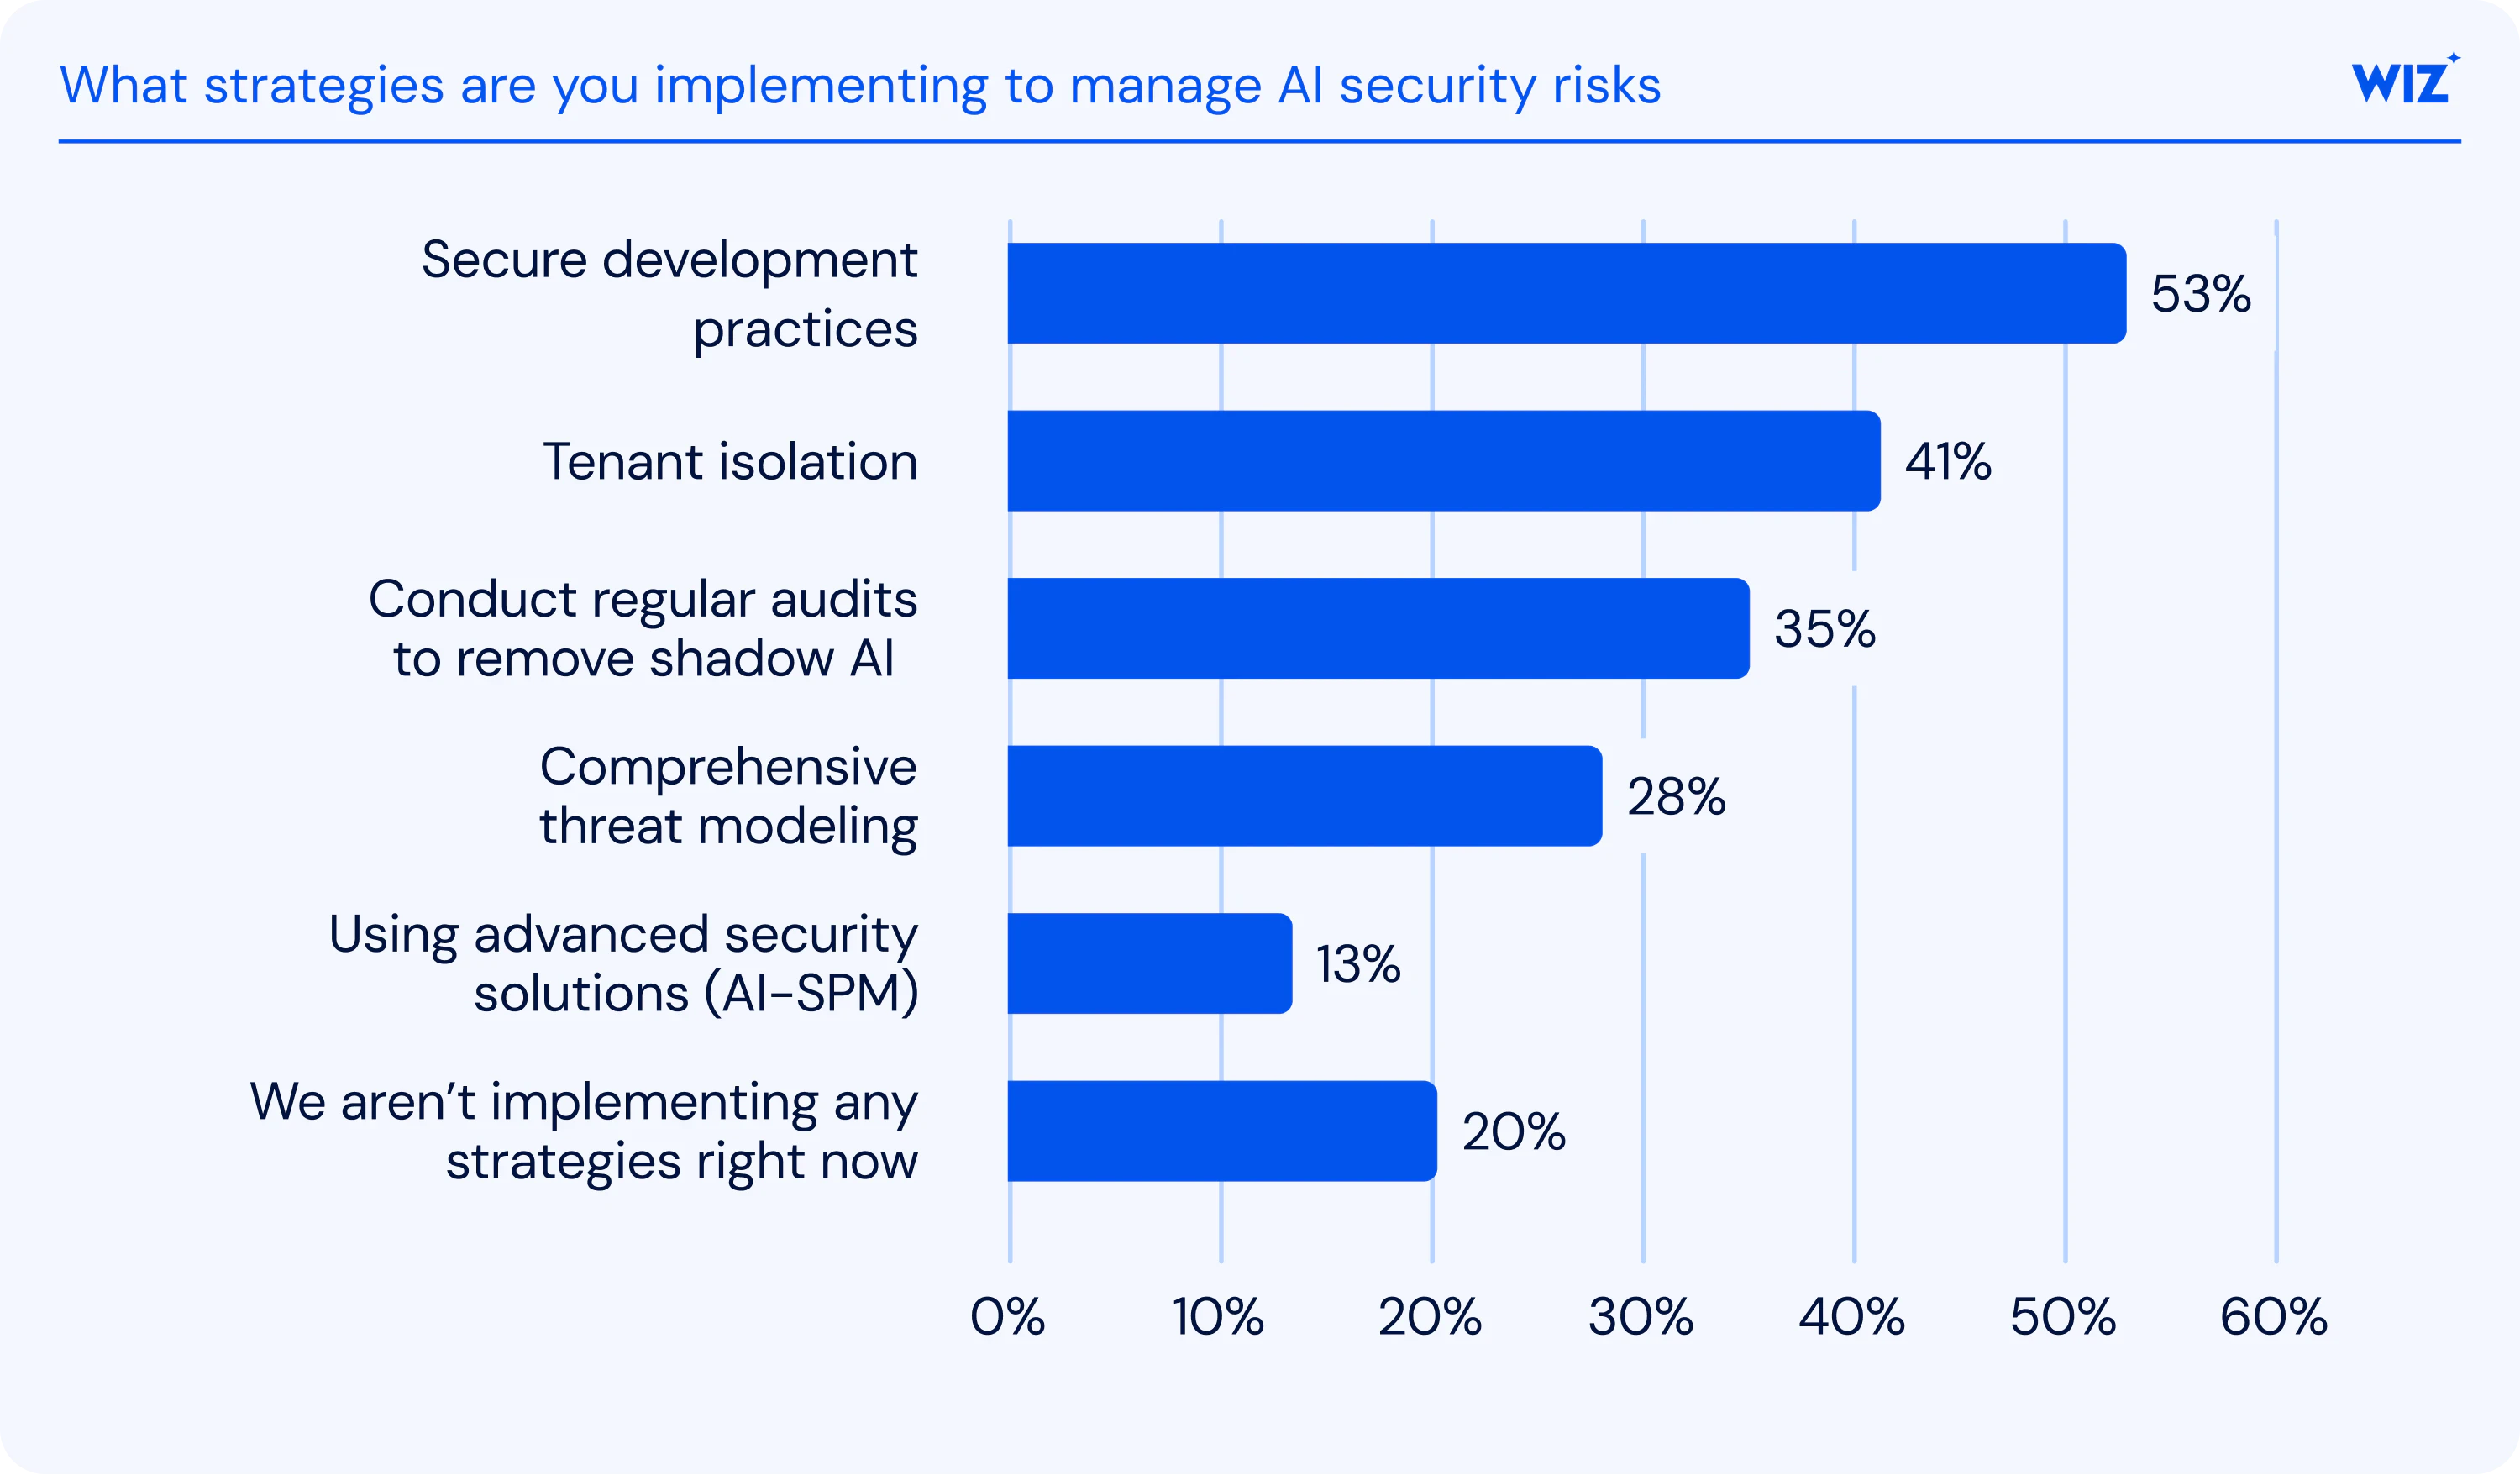
Für ein möglichst sicheres Setup haben sich folgende Best Practices bewährt:
24/7-Monitoring und Erkennung
KI-Systeme erfordern kontinuierliches Monitoring, das auf der klassischen Infrastrukturüberwachung aufbaut. Es prüft Eingabemuster des Modells auf Anomalien, überwacht die Verteilung der Outputs auf Drift und gleicht das KI-Verhalten mit Cloud-Aktivitätslogs ab.
Zeigt das Monitoring verdächtige Muster, etwa ungewöhnlich viele Abfragen oder Outputs, die von Baseline-Modellen abweichen, brauchen Sicherheitsteams Kontext für eine schnelle Untersuchung. Dafür muss die KI-Telemetrie mit der Cloud-Infrastruktur verknüpft sein, in der die Modelle laufen.
Adversarial Training
Beim Adversarial Training werden Modelle schon während des Trainings mit potenziellen Angriffen konfrontiert. So lernen sie, Manipulationen zu erkennen und ihnen standzuhalten. Häufig werden dafür mit bekannten Techniken Adversarial-Eingaben erzeugt, den Trainings-Datasets hinzugefügt und das Modell mit diesen erweiterten Daten neu trainiert.
Allerdings zeigen so trainierte Modelle bei normalen Eingaben mitunter eine etwas geringere Genauigkeit. Zudem schützt Adversarial Training nur vor Angriffsarten, denen das Modell im Training ausgesetzt war. Die Trainingsdaten müssen deshalb laufend aktualisiert werden.
Härtung von KI- und ML-Entwicklungsumgebungen
Unternehmen, die kritische Komponenten ihrer KI- und ML-Entwicklungsumgebungen absichern, stärken ihre gesamte KI-Sicherheitslage. Zu den wichtigsten Maßnahmen gehören die Bereinigung von Trainingsdaten sowie die Entwicklung oder Nutzung robusterer ML-Algorithmen, etwa solcher, die gegen byzantinische Angriffe resistent sind. Hinzu kommen KI, die ML-Algorithmen schreibt oder validiert und so menschliche Fehler reduziert, und Sicherheit, die so früh wie möglich in KI-Pipelines integriert wird.
Optimierte Architekturen für KI- und GenAI-Services
Unternehmen sollten sehr bewusst entscheiden, welches Tenant-Architekturmodell sie für Services mit GenAI-Komponenten nutzen. Es gibt drei grundlegende Typen von GenAI-Tenant-Architekturen: Multi-Tenant-, Single-Tenant- und hybride Architekturen.
Sinnvoll ist es, einige Komponenten der GenAI-Services auf mehrere Tenants zu verteilen und anderen dedizierte Tenants zuzuweisen. Das begrenzt großflächige Schäden und beschleunigt die Reaktion auf Vorfälle.
Vorverarbeitung von Eingaben
Vorverarbeitungstechniken, die vor der Übergabe an das Modell greifen, helfen dabei, Adversarial-Störungen zu erkennen und abzuschwächen. Feature Squeezing reduziert die Präzision der Eingabemerkmale und entfernt so Adversarial-Rauschen. Input Transformation stört gezielt präparierte Eingaben durch zufällige Größenänderungen, Padding oder andere Transformationen.
Ergänzend identifiziert die Anomalieerkennung mit statistischen Methoden Eingaben, die deutlich von erwarteten Mustern abweichen.
Einführung von AI Security Posture Management (AI-SPM)
Zum Schutz vor Adversarial-AI-Angriffen empfiehlt sich ein einheitliches Cloud-Sicherheitstool, in dem AI-SPM eine zentrale Funktion ist.
Laut dem AI Security Readiness Report von Wiz haben erst 13 % der Unternehmen AI-SPM-Lösungen eingeführt, obwohl 87 % aktiv KI-Services nutzen. Mit einem robusten AI-SPM-Tool haben Adversarial-AI-Angriffe dagegen kaum noch Auswirkungen auf die Einführung und Nutzung von KI im Unternehmen.
Erfahren Sie, wie Wiz Teams dabei unterstützt, Risiken für KI-Services im Cloud-Kontext zu erkennen und zu priorisieren. So können Sie potenzielle Angriffspfade und Fehlkonfigurationen gezielter untersuchen. Wiz in Aktion erleben