


AI-Modellsicherheit im Überblick
AI-Modellsicherheit schützt Modellartefakte vor Angriffen, die gezielt die besonderen Schwachstellen von AI ausnutzen. Das gilt für den gesamten Modelllebenszyklus, vom ersten Training über das Deployment in Produktion bis zur Nutzung in der Runtime.
Anders als bei klassischer Anwendungssicherheit geht es hier um probabilistische Systeme, die durch Daten geformt werden und nicht durch statischen Code. Dadurch entstehen neue Angriffsflächen, für die herkömmliche Sicherheitskontrollen nie ausgelegt waren. Adversarial Inputs können Vorhersagen manipulieren, gezielt formulierte Prompts umgehen die Guardrails von Sprachmodellen, und wiederholte Abfragen können sensible Trainingsdaten unbemerkt preisgeben.
Die gefährdeten Komponenten, zusammengefasst als Modellartefakte, verteilen sich über den gesamten Lebenszyklus. Trainingsdaten, Modellarchitekturen, gelernte Gewichte, Hyperparameter, versionierte Checkpoints und Inferenz-Endpunkte stehen jeweils für ein eigenes Fehlerszenario. Durch Data Poisoning manipulierte Trainingsdaten verfälschen das Modellverhalten im Kern; gestohlene Gewichte legen geistiges Eigentum offen und liefern eine Vorlage für Adversarial Attacks; fehlkonfigurierte Endpunkte werden zum Ausgangspunkt für Prompt Injection oder Datenexfiltration.
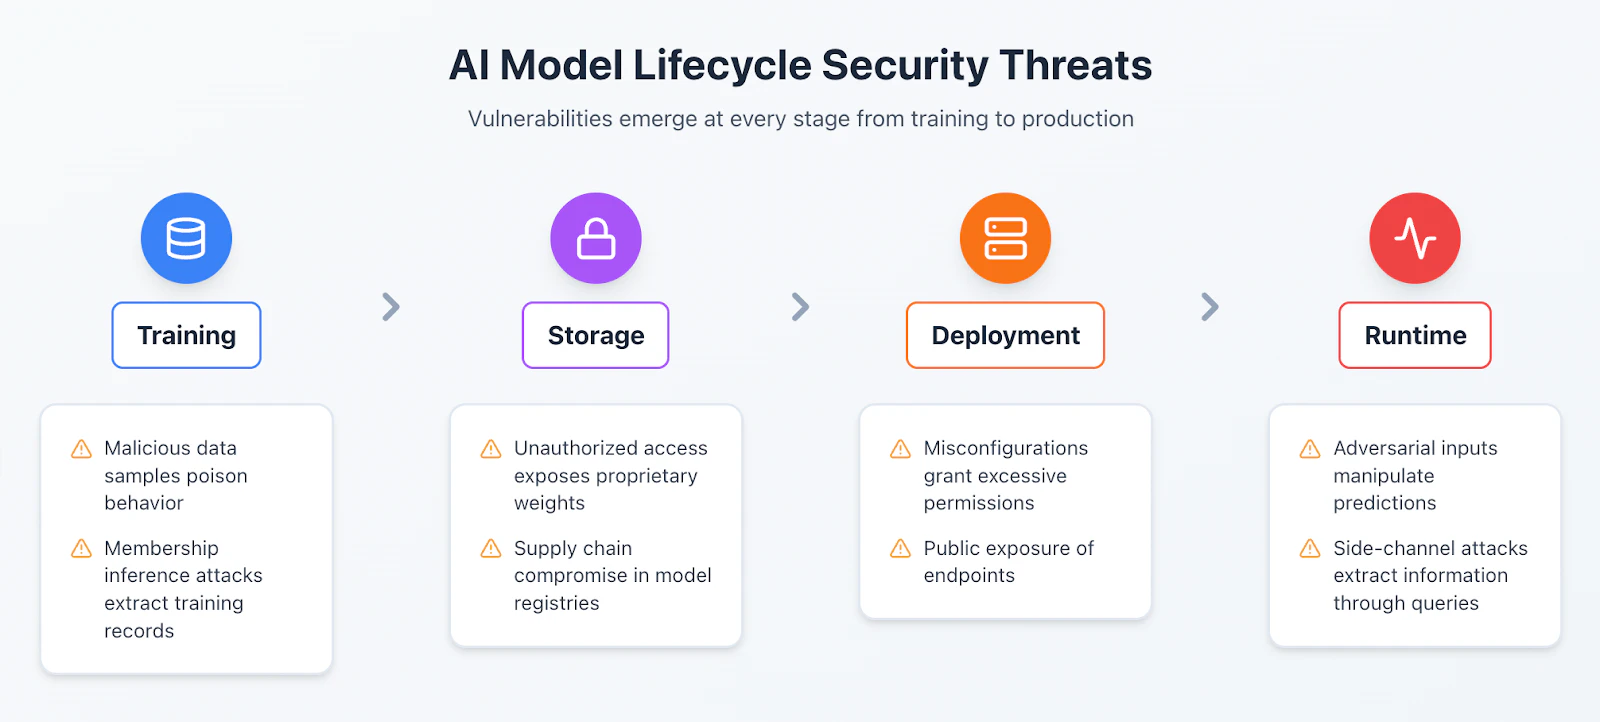
Mit jeder Phase des Lebenszyklus verschiebt sich auch die Bedrohungslage (siehe Abbildung 1). Frühe Schwachstellen können sich in spätere Phasen fortsetzen, während die Erreichbarkeit zur Runtime ganz neue Wege eröffnet, Modellverhalten zu beeinflussen oder auszulesen. Die Absicherung von AI-Modellen braucht deshalb Kontrollen, die den Lebenszyklus berücksichtigen: wie Modelle entstehen, gespeichert, abgerufen und abgefragt werden.
Bedeutung der AI-Modellsicherheit für Unternehmen
Der AI-Einsatz in Unternehmen wächst deutlich schneller als die Sicherheitsreife. Laut unserem Report State of AI in the Cloud laufen in 74% der Cloud-Umgebungen inzwischen AI-Services, wobei selbst gehostete Modelle 72% der Workloads ausmachen. Der Wechsel von Managed Services zu selbst trainierten Modellen hat die Angriffsfläche drastisch vergrößert. Ein aktueller IBM-Report zeigt, dass 13% der Unternehmen 2025 Sicherheitsvorfälle bei AI-Modellen erlebt haben.
Die Cloud verstärkt die Risiken für AI-Modelle auf ganz bestimmte Weise:
Werden Modelle über Regionen hinweg repliziert, entstehen uneinheitliche Zugriffskontrollen. Ein in us-east-1 abgesichertes Modell kann in eu-west-1 offen erreichbar sein.
Gemeinsam genutzte, mandantenfähige Trainingsinfrastruktur kann Modellgewichte und Trainingsdaten über Seitenkanäle oder Fehlkonfigurationen preisgeben.
Kurzlebige Trainingsumgebungen erzeugen blinde Flecken in der Data Lineage. Über APIs erreichbare Modelle sind Bedrohungen im Internetmaßstab ausgesetzt.
Über öffentliche Registries wie Hugging Face gelangen ungeprüfte Modelle in Workloads und können Backdoors einschleusen.
Cloud-Self-Service beschleunigt Shadow AI, weil Teams Modelle auch außerhalb zentraler Governance bereitstellen können.
Wird ein AI-Modell kompromittiert, reichen die Folgen weit über ein einzelnes System hinaus (siehe Abbildung 2).
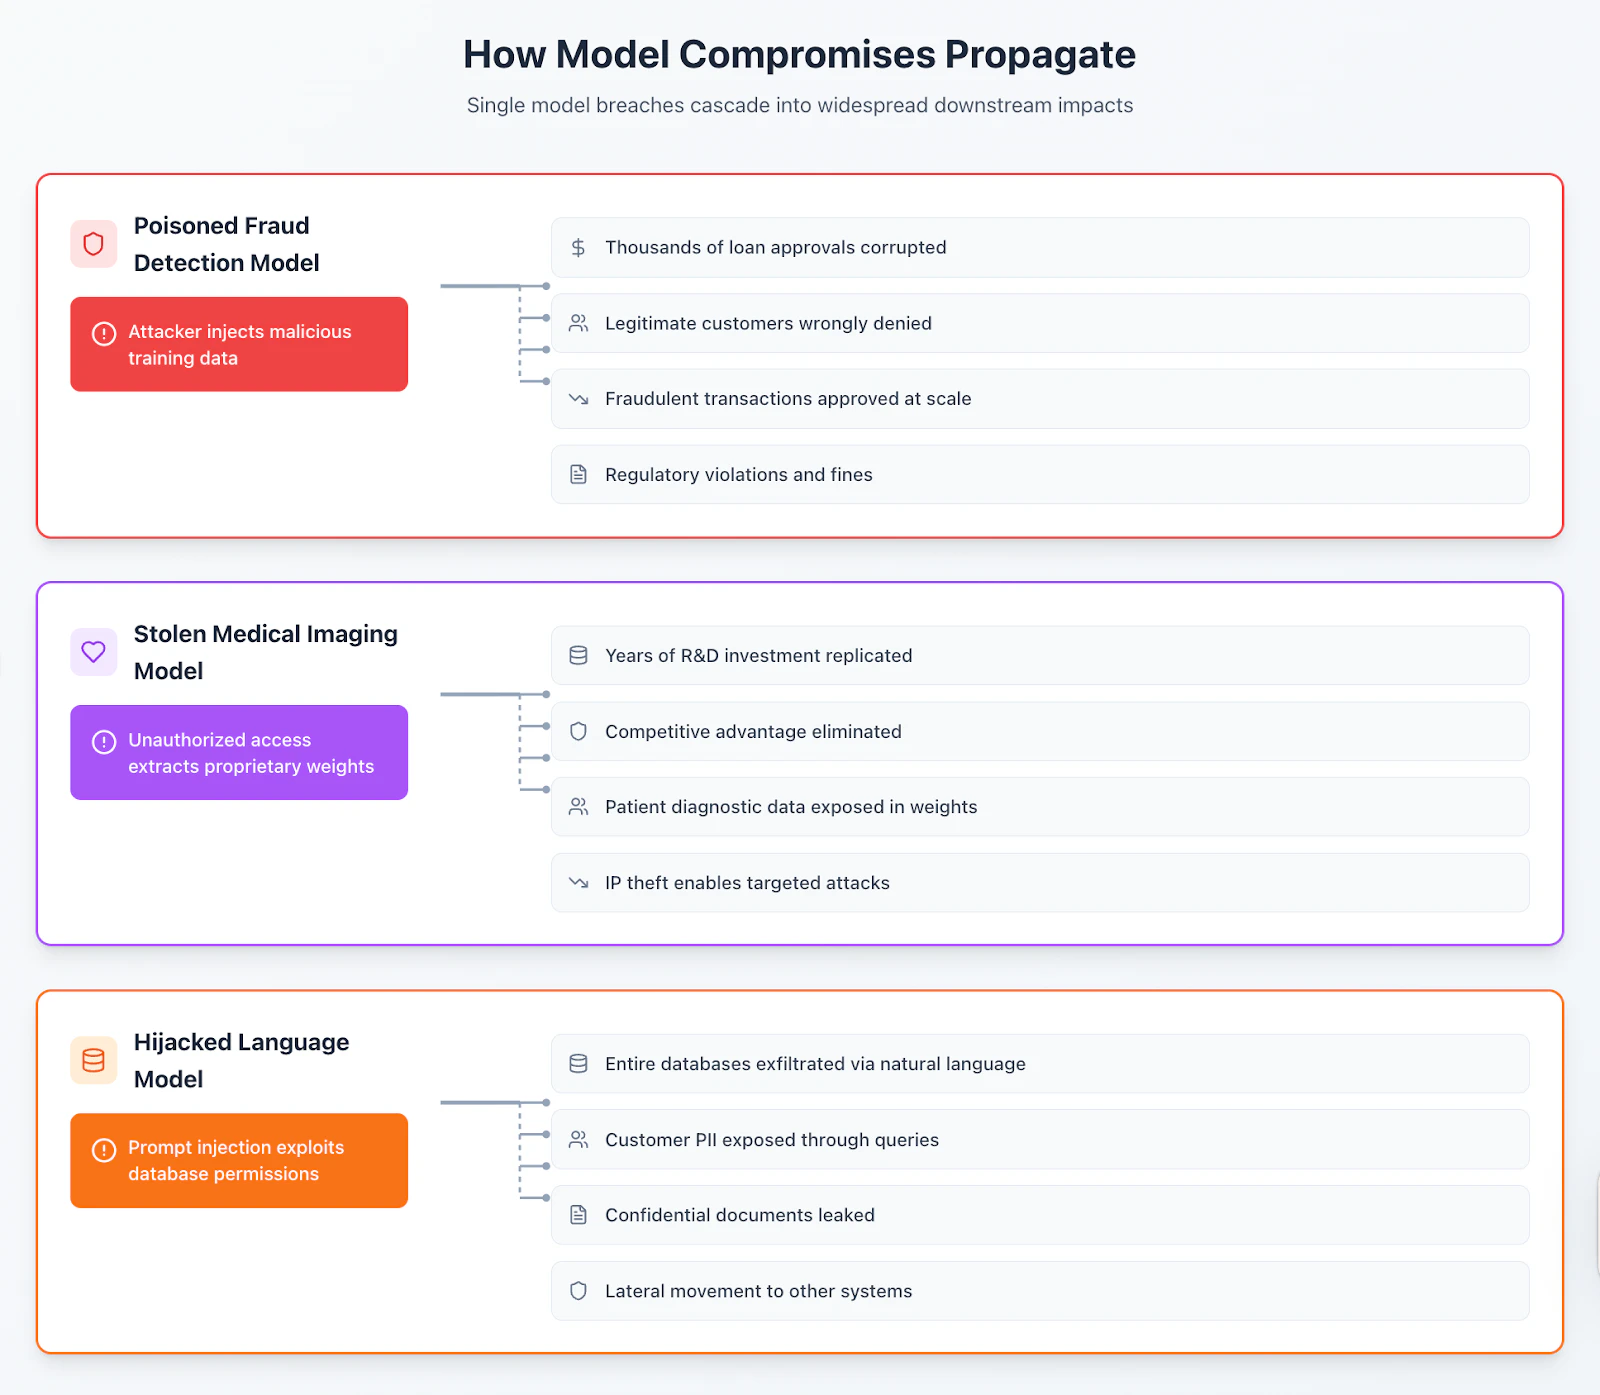
In der Finanzbranche, im Gesundheitswesen und bei autonomen Systemen gefährden diese Risiken unmittelbar Sicherheit und Compliance. Mit der zunehmenden Verbreitung von AI nutzen Angreifer diese Lücken bereits aktiv aus.
Herausforderungen der AI-Modellsicherheit
AI-Modelle bringen Sicherheitsherausforderungen mit sich, für die die meisten bestehenden Kontrollen nicht ausgelegt sind. Das liegt nicht daran, dass sie grundsätzlich unsicher wären. Sie verändern vielmehr, wie Risiken entstehen und wie Teams sie steuern. Modellverhalten kann sich durch erneutes Training, neue Deployments oder neue Datenanbindungen ändern, oft ganz ohne die Codeänderungen, die Sicherheitsteams normalerweise prüfen.
Diese Verschiebung hat handfeste Folgen für den Schutz. Sensible Informationen können direkt in Modellgewichte eingebettet werden, und diese Gewichte lassen sich weder verschlüsseln noch sinnvoll verschleiern, ohne die Funktion zu zerstören. Angreifer brauchen keinen Zugriff auf den Quellcode, um daraus Nutzen zu ziehen. Schon die Interaktion mit einem erreichbaren Inferenz-Endpunkt kann über gezielt formulierte Abfragen Rückschlüsse auf Trainingsdaten oder Modellverhalten erlauben.
Verschärft werden diese technischen Herausforderungen durch ein Sicherheitsökosystem, das mit dem Tempo der AI-Einführung noch nicht Schritt hält. Ausgereifte Programme für Anwendungssicherheit stützen sich auf etablierte Scanner, Analysetools und Review-Workflows. Vergleichbare Guardrails für AI-Systeme entstehen erst, sodass viele Unternehmen Modelle bereitstellen, bevor einheitliche Sicherheitskontrollen greifen.
Die Folge ist eine wachsende Reifelücke. Laut Untersuchungen von Wiz fehlt 25% der Unternehmen die Transparenz darüber, welche AI-Systeme in ihren Umgebungen laufen. Das schränkt selbst grundlegende Governance und Kontrolle ein. Mit dem steigenden AI-Einsatz überholen die Deployments die verfügbare Prüfkapazität immer weiter. Ungeprüfte Modelle gelangen in Produktion und erhöhen ein systemisches Risiko, für das klassische Prozesse nie ausgelegt waren.
Bedrohungslandschaft für AI-Modelle
Eine wirksame Abwehr setzt voraus, dass Teams verstehen, wie Angreifer modellspezifische Schwachstellen über den gesamten Entwicklungs- und Deployment-Lebenszyklus ausnutzen.
Data Poisoning schleust manipulierte Trainingsbeispiele ein, um Backdoors zu verankern, die Genauigkeit gezielt zu verschlechtern oder Datenextraktion zu ermöglichen.
Adversarial Attacks täuschen Modelle mit gezielt konstruierten Eingaben, von kaum wahrnehmbaren Bildstörungen bis zu Prompt Injections, die Guardrails umgehen. Sie nutzen statistische Lernmuster aus statt Implementierungsfehler.
Modelldiebstahl entwendet proprietäre Modelle durch Exfiltration aus dem Storage, abfragebasierte Rekonstruktion oder kompromittierte Infrastruktur. Gestohlene Modelle kopieren F&E-Investitionen und ermöglichen gezielte Angriffe.
Schwachstellen in der Lieferkette kompromittieren Pipelines über vortrainierte Modelle mit Backdoors, bösartige Framework-Abhängigkeiten und manipulierte Datasets.
Model Hijacking nutzt Systeme mit zu weit gefassten Berechtigungen aus: Sprachmodelle mit Datenbankzugriff werden zum Einfallstor für Injection über natürliche Sprache, AI-Agents mit Cloud-Berechtigungen lassen sich zur Datenexfiltration oder Rechteausweitung manipulieren. Selbst ausführliche Fehlermeldungen können sensible Informationen preisgeben.
Die rasche Weiterentwicklung dieser Angriffstechniken trifft auf einen wachsenden AI-Einsatz in Unternehmen und macht spezialisierte Abwehrmaßnahmen dringend nötig.
Zentrale Funktionen für AI-Modellsicherheit
Die Absicherung von AI-Modellen erfordert spezialisierte Funktionen, die ihre Besonderheiten über den gesamten Lebenszyklus abdecken. Cloud-Sicherheit bildet das Fundament, doch wirksame AI-Sicherheit reicht über mehrere Kontrollebenen: von der Transparenz über alle Ressourcen und der Integrität von Artefakten bis zu Datensicherheit und Runtime-Monitoring. Fünf AI-spezifische Funktionen sind für umfassenden Schutz unverzichtbar:
Erkennung und Inventarisierung: Teams erfassen kontinuierlich alle AI-Ressourcen in Cloud-Umgebungen, darunter Trainingsjobs, Inferenz-Endpunkte, Model Registries und unterstützende Infrastruktur. Dazu gehört auch, Versionen, Data Lineage, Shadow AI und Angriffspfade über die Infrastruktur nachzuverfolgen.
Schutz der Lieferkette: Diese Funktion senkt das Risiko, dass kompromittierte Komponenten in Produktion gelangen. Sie prüft die Herkunft, scannt vortrainierte Modellartefakte und ML-Frameworks auf Schadcode oder unsichere Konstrukte, erzwingt freigegebene Registries und pflegt eine Model Bill of Materials.
Datensicherheit und Klassifizierung: Sensible Trainingsdaten und Outputs bleiben geschützt, weil Datasets klassifiziert und riskante Zugriffspfade identifiziert werden. Zusätzlich werden Datenflüsse überwacht, Datenabfluss über Inferenz erkannt, Vorgaben zur Datenresidenz durchgesetzt und unnötige personenbezogene Daten (PII) reduziert.
Zugriffskontrollen und Secrets-Monitoring: Hier wird das Prinzip der geringsten Berechtigung für Trainingsinfrastruktur, Registries und Inferenz-Endpunkte überprüft. Im Fokus stehen Identitäten mit zu vielen Rechten, offengelegte Secrets und Fehlkonfigurationen, die unbefugten Zugriff oder den Missbrauch von Automatisierung ermöglichen.
Integrität von Modellartefakten und Deployments: Unautorisierte Modelländerungen, unsichere Serialisierungsformate und nicht freigegebene Deployments fallen auf, weil Modellartefakte, Konfigurationsdrift und das Ausführungsverhalten zur Runtime auf Systemebene überwacht werden.
Diese Funktionen greifen über AI Security Posture Management (AI-SPM) ineinander. AI-SPM bewertet AI-spezifische Risiken kontinuierlich und lässt sich in bestehende Workflows der Cloud-Sicherheit integrieren.
Best Practices für AI-Modellsicherheit
Die Absicherung von AI-Modellen braucht einen strategischen Ansatz, der Sicherheit als Wegbereiter für Innovation versteht. Die folgende Checkliste mit zentralen Kontrollen hilft, den aktuellen Sicherheitsstatus zu bewerten und Lücken in fünf kritischen Bereichen zu erkennen:
Absicherung der Entwicklungs-Pipeline für Modelle
Trainingsumgebungen über isolierte VPCs oder Accounts trennen;
alle Artefakte versionieren (Gewichte, Architekturen, Skripte, Datasets);
Code-Reviews für alle Pipeline-Änderungen verpflichtend machen;
reproduzierbare Builds erzwingen, um Konfigurationsdrift zu verhindern;
die Trainingsinfrastruktur kontinuierlich auf Schwachstellen scannen;
ausgehenden Netzwerkverkehr auf freigegebene Quellen beschränken.
Kontinuierliches Monitoring und Testing
Angriffe früh erkennen und Abwehrmaßnahmen proaktiv validieren;
Performance-Drift als Indikator für Data Poisoning verfolgen;
Endpunkte auf Adversarial-Muster überwachen;
in Staging gegen die OWASP Top 10 für LLMs testen;
Red-Team-Übungen gegen die Deployment-Architektur durchführen;
umfassende Zugriffsprotokolle führen.
Data Governance
sensible Daten über den gesamten Modelllebenszyklus schützen;
Trainingsdaten nach Sensibilität klassifizieren;
Datenminimierung umsetzen, um unnötige PII zu entfernen;
Zugriffsmuster auf unbefugte Datenbewegungen überwachen;
Zweckbindung durchsetzen;
Data Lineage pflegen, die Outputs bis zu ihren Quellen zurückverfolgt;
Aufbewahrungsrichtlinien anwenden.
Prüfung der Lieferkette
verhindern, dass kompromittierte Komponenten in Produktion gelangen;
freigegebene Registries festlegen und öffentliche Repositories als nicht vertrauenswürdig behandeln;
die Integrität über Prüfsummen verifizieren;
SBOM und AI-BOM pflegen;
vortrainierte Modelle auf Schadcode scannen;
Governance-Gremien einrichten, die externe Modelle freigeben.
Adversarial Testing und Validierung
Schwachstellen vor dem Deployment in Produktion identifizieren;
Red-Team-Übungen zu Modellextraktion und Data Poisoning durchführen;
Benchmarks anhand von OWASP und NIST AI RMF durchführen;
Adversarial Examples bereits während der Entwicklung erzeugen;
die Widerstandsfähigkeit gegen Jailbreaks testen;
Kontrollen validieren, die identifizierte Angriffe verhindern.
Diese Praktiken müssen sich mit der Bedrohungslage weiterentwickeln und auf den Grundlagen der Cloud-Sicherheit aufbauen. AI-spezifische Kontrollen bilden dabei eine zusätzliche Ebene über Identitäts-, Netzwerk- und Schwachstellenmanagement.
AI-Modellsicherheit mit Wiz über den gesamten Lebenszyklus
Wiz AI-APP sichert AI-Systeme über den gesamten Modelllebenszyklus auf Cloud- und Infrastrukturebene ab. Dafür vereint die Lösung AI Security Posture Management (AI-SPM), das Scannen von Modellartefakten, Datensicherheit, Angriffspfadanalyse, Code Security und Runtime-Erkennung in einer einzigen Cloud-Native-Plattform.
Statt AI-Modelle isoliert zu bewerten, verknüpft Wiz Findings aus allen Cloud-Umgebungen. So werden ausnutzbare Bedingungen und Angriffspfade erkennbar, mit vollem Kontext statt einzelner Schwachstellen.
Ein typisches Szenario: eine öffentlich erreichbare VM, auf der Trainings-Workloads laufen und die direkt auf sensible Trainingsdaten zugreifen kann.
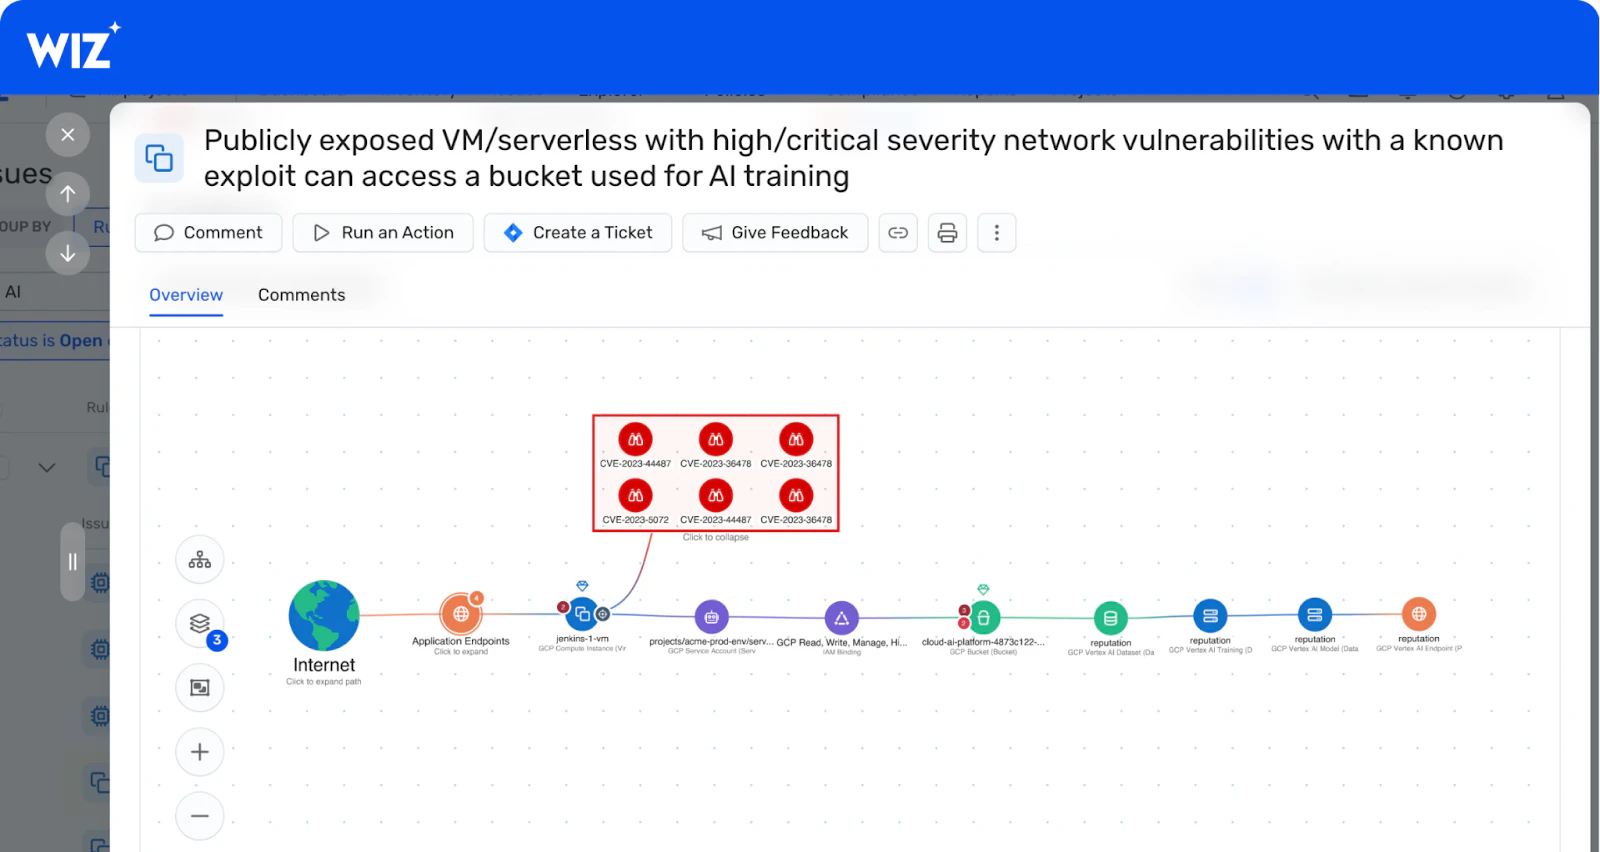
In diesem Szenario schaffen Erreichbarkeit aus dem Internet, Identitätsberechtigungen und Datenzugriff zusammen die Voraussetzungen für Manipulationen an Trainingsdaten oder für das Einschleusen kompromittierter Modellartefakte beim erneuten Training. Das kann die Modellintegrität beeinträchtigen und in großem Maßstab zu schädlichen nachgelagerten Entscheidungen führen. Wiz AI-APP hilft Sicherheitsteams, diese Angriffskette früh zu erkennen und zu unterbrechen:
AI-BOM Discovery: Agentless Scanning erkennt AI-Ressourcen in Cloud- und selbst gehosteten Umgebungen. Dazu zählen erreichbare Compute-Ressourcen, Trainingsinfrastruktur, Daten-Buckets, unterstützte Modellgewichte und Binärdateien sowie Inferenz-Endpunkte.
Security Graph: Der Graph verknüpft AI-Ressourcen mit Cloud-Identitäten, Berechtigungen und Netzwerkerreichbarkeit. So fallen Zugangsdaten mit zu weit gefassten Rechten und öffentlich erreichbare Infrastruktur mit direktem Pfad zu sensiblen Trainingsdaten und Modellartefakten auf.
Schutz der Lieferkette: Wiz scannt unterstützte Binärdateien und erzwingt freigegebene Quellen, bevor Artefakte in Trainings- oder Deployment-Pipelines gelangen. Das hilft zu verhindern, dass kompromittierte Modellartefakte in Produktion landen.
DSPM für AI: DSPM klassifiziert Trainingsdaten und Outputs, um sensible Informationen wie personenbezogene Daten (PII) und geistiges Eigentum zu identifizieren. Außerdem zeigt es, wo AI-Workloads unnötige oder riskante Zugriffe haben.
Angriffspfadanalyse: Die Analyse bildet ausnutzbare Pfade ab, an denen Erreichbarkeit, fehlkonfigurierte Identitäten und Zugriff auf sensible Daten zusammentreffen. Dadurch werden Bedingungen erkennbar, die Data Poisoning, unautorisierte Modelländerungen oder das Deployment kompromittierter Artefakte ermöglichen könnten.
Code Security: Wiz scannt AI-Pipelines, Abhängigkeiten und unterstützte Modellartefakte auf eingebetteten Schadcode und unsichere Serialisierungsmuster. Solche Funde könnten sonst Risiken in Trainings- oder Deployment-Workflows einbringen.
Runtime-Erkennung: Wiz überwacht AI-Workloads und unterstützende Infrastruktur auf auffälliges Verhalten auf Systemebene. Beispiele sind unerwartete Prozessausführungen, verdächtige Netzwerkaktivität oder unbefugte Zugriffsmuster, die auf eine aktive Ausnutzung hindeuten.
Wiz vereint AI-Sicherheitsstatus, Artefakt-Scans, Runtime-Signale und Cloud-Kontext und macht aus fragmentierten Findings priorisierte, umsetzbare Erkenntnisse. Damit reduzieren Unternehmen reales AI-Risiko in Trainings-, Deployment- und Inferenzumgebungen, ohne auf spekulative Analysen von Modellinterna angewiesen zu sein.
Erfahren Sie, wie Wiz Ihnen helfen kann, AI-Risiken über Trainings-, Deployment- und Inferenzumgebungen hinweg im Cloud-Kontext zu erkennen und zu priorisieren. Wiz in Aktion erleben