
Definition von Data Poisoning
Data Poisoning ist eine Form von Adversarial Attack, die auf die Trainings-Datasets von KI- und Machine-Learning-Modellen (ML) abzielt. Ziel ist es, das Modellverhalten zu verschlechtern oder zu steuern. Angreifer schleusen dazu irreführende oder falsche Informationen in das Trainings-Dataset ein: Sie fügen neue Daten hinzu, verändern vorhandene Daten oder löschen einzelne Daten, um das Verständnis des Modells zu verfälschen.
Branchen, die auf KI-gestützte Entscheidungen setzen, etwa Finanzwesen, Gesundheitswesen und autonome Systeme, sind besonders attraktive Ziele. Der Grund: Fehlverhalten von Modellen hat dort besonders große Auswirkungen.
Mögliche Auswirkungen eines Data-Poisoning-Angriffs
Data Poisoning kann die Zuverlässigkeit und Wirksamkeit datenabhängiger Systeme erheblich verringern. Laut dem Wiz-Report State of AI in the Cloud gilt: „70 % der Cloud-Umgebungen [nutzen] KI-Dienste.“
Angriffe auf KI und Large Language Models (LLMs) können unter anderem folgende Auswirkungen haben:
| LLM-Probleme | Auswirkungen |
|---|---|
| Teams treffen Entscheidungen auf Basis manipulierter Daten. | Schädliche Daten können Verzerrungen (Bias) einführen, die Ergebnisse und Entscheidungen auf Basis des manipulierten Datasets verfälschen. Fließen etwa ungenaue oder verzerrte Daten in ein Finanzmodell ein, kann das zu schlechten Investitionsentscheidungen führen, die die finanzielle Stabilität des Unternehmens belasten. Ebenso können verzerrte Daten in der Medizin zu falschen Diagnosen und Behandlungsempfehlungen führen und so die Patientengesundheit gefährden. |
| Unternehmen kämpfen mit geringer Präzision und ungenauem Recall. | Manipulierte Daten können die Gesamtgenauigkeit, die Präzision und den Recall von Vorhersagemodellen verschlechtern. Unzuverlässige Outputs und höhere Fehlerraten können folgen und ganze Systeme kompromittieren. Im Marketing kann das bedeuten, dass die falsche Zielgruppe angesprochen wird, in der Cybersicherheit, dass echte Probleme übersehen werden. Die geringere Wirksamkeit dieser Modelle mindert ihren Wert und kann erhebliche Verluste verursachen. |
| Sicherheitsteams sind mit möglichen Systemausfällen oder Ausnutzung konfrontiert. | Data Poisoning ermöglicht Backdoor-Angriffe: Angreifer platzieren Trigger in Datasets, die Systeme unvorhersehbar reagieren lassen. So können sie Sicherheitsmaßnahmen umgehen oder System-Outputs für schädliche Zwecke manipulieren. |
In kritischen Infrastrukturen können Schwachstellen, die Angreifer über Backdoor-Angriffe einschleusen, schwerwiegende Folgen haben. Die Hackergruppe LAPSUS$ etwa kombinierte bei ihren Versuchen, Daten von KI-Modellen zu manipulieren, mehrere Taktiken. Dazu gehörte auch eine Backdoor, um sich Zugang zum System zu verschaffen.
Funktionsweise eines Data-Poisoning-Angriffs
Data Poisoning tritt bei folgenden gängigen Angriffen auf:
Einschleusen falscher Daten: Angreifer manipulieren ein Dataset, indem sie fiktive oder irreführende Datenpunkte hinzufügen oder Prompt Injection nutzen. Das führt zu fehlerhaftem Training und falschen Vorhersagen. Werden etwa gefälschte Kundenbewertungen in ein Empfehlungssystem eingespeist, verändert das die Wahrnehmung der Produktqualität.
Verändern vorhandener Daten: Bei dieser Angriffsart verändern Angreifer echte Datenpunkte, um Fehler einzuführen und das System in die Irre zu führen, ohne neue Daten hinzuzufügen. Ein Beispiel ist das Ändern von Werten in einer Datenbank mit Finanztransaktionen. Das kann Systeme zur Betrugserkennung aushebeln oder zu Fehlberechnungen bei aufgelaufenen Gewinnen und Verlusten führen.
Löschen von Daten: Das Entfernen kritischer Datenpunkte erzeugt Lücken, die zu einer schlechten Generalisierung des Modells führen. Diese Lücken wirken sich häufig auf die Modellleistung bei Edge Cases aus, also genau bei den Szenarien, die viele sicherheitskritische Systeme erkennen sollen. So kann ein Cybersicherheitssystem bestimmte Netzwerkangriffe nicht mehr erkennen, wenn die zugehörigen Angriffsdaten fehlen.
Gezielte und ungezielte Data-Poisoning-Angriffe im Vergleich
Bei gezielten Data-Poisoning-Angriffen verfolgen malicious actors bestimmte Ergebnisse, etwa dass ein System bestimmte Eingaben falsch klassifiziert. Backdoor-Angriffe fallen in diese Kategorie: Bestimmte Trigger veranlassen das System, sich auf eine vordefinierte Weise zu verhalten. Ein Überwachungskamerasystem könnte beispielsweise ein Programm enthalten, das Eindringlinge mit einer bestimmten Verkleidung ignoriert.
Ungezielte Data-Poisoning-Angriffe hingegen untergraben Machine-Learning-Modelle, indem sie beschädigte oder irreführende Daten in Trainingsdaten einschleusen. Die Angriffe verschlechtern Genauigkeit und Zuverlässigkeit des Modells und führen zu fehlerhaften Outputs.
Bei einem ungezielten Data-Poisoning-Angriff könnte ein Angreifer etwa zufälliges Rauschen oder falsch gelabelte E-Mails in die Trainingsdaten eines Spamfilters einfügen. Das Modell würde dann wichtige E-Mails oder Tickets falsch klassifizieren und könnte Arbeitsabläufe im Unternehmen stören.
Zwei Praxisbeispiele für Data Poisoning
Wie sieht eine Data-Poisoning-Schwachstelle in der Praxis aus? Die folgenden zwei realen Beispiele zeigen es:
Forschungsergebnisse zu Data-Poisoning-Schwachstellen in KI-Systemen
Im Jahr 2024 entdeckten Forschende der University of Texas Data-Poisoning-Schwachstellen in KI-Systemen. In dem Projekt, das sie später ConfusedPilot nannten, untersuchten sie Modelle wie Microsoft 365 Copilot und konzentrierten sich auf Retrieval-Augmented Generation. Um ihre Annahmen zu testen, fügten sie schädliche Daten in Dokumente ein, auf die die KI zugriff.
Bei Suchanfragen griff die KI auf die manipulierten Daten zurück und beantwortete die Abfragen mit ungenauen und falschen Informationen. Selbst nachdem die Forschenden die Dokumente gelöscht hatten, lieferten Abfragen weiterhin irreführende Outputs.
ConfusedPilot zeigte, wie leicht manipulierte Daten Halluzinationen erzeugen können, selbst nach dem Löschen der schädlichen Quelldokumente. Je stärker Unternehmen auf KI setzen, desto eher können solche Datenpunkte Betriebsabläufe und Datenintegrität stören.
Hugging Face und Wiz im Einsatz gegen Data Poisoning in Pipelines
Bei der Zusammenarbeit mit Hugging Face stießen Wiz-Forschende auf ein kritisches Risiko: eine Schwachstelle, über die threat actors schädliche Daten auf die Plattform von Hugging Face hochladen konnten. Wären bei einem Angriff schädliche Daten in Unternehmensumgebungen gelangt, hätten Unternehmen ihre eigene KI-Pipeline kompromittieren können. Diese Form von Data Poisoning hätte Manipulationen in der gesamten Infrastruktur eines Unternehmens ermöglicht.
Wiz beugte künftigen Problemen vor, indem es Erkennungsfunktionen seiner Plattform integrierte, die KI-Komponenten in Kundenumgebungen überwachen. Die Lösung markierte außerdem verdächtiges Verhalten und schuf mit Funktionen wie AI Security Posture Management (AI-SPM) vollständige Transparenz.
Techniken zur Prävention von Data Poisoning

Die Abwehr von Data Poisoning erfordert einen ganzheitlichen Ansatz. Deshalb macht die Verbindung von robustem Datenmanagement und fortschrittlichen Erkennungstechniken im Umgang mit threat actors einen großen Unterschied.
Dafür gibt es mehrere Wege:
Robuste Datenvalidierung
Strenge Validierungsverfahren verhindern, dass manipulierte Daten überhaupt ins System gelangen. Zentrale Strategien sind:
Data Lineage: Die Überwachung von Data Lineage und Datenhistorie hilft, potenziell schädliche Datenquellen zu finden und zu entfernen. Denn zuverlässige Datenquellen können Data Poisoning verhindern.
Kreuzvalidierung: Die Validierung des Modells mit mehreren Teilmengen der Daten deckt Anomalien und Inkonsistenzen auf. Das senkt das Risiko einer Überanpassung (Overfitting) an manipulierte Daten und hilft sicherzustellen, dass die Modellleistung im erwarteten Verbesserungsrahmen bleibt.
Anomalieüberwachung auf Basis von Trainingsdaten und Modellverhalten
Eine automatische Anomalieerkennung macht ungewöhnliche Muster sichtbar, die auf Manipulation hindeuten können, und markiert sie. Zentrale Strategien sind:
Erkennung von Ausreißern in Datasets: Statistische Methoden und Clustering-Algorithmen wie DBSCAN identifizieren auffällige Datenpunkte. So lassen sich manipulierte Daten erkennen, bevor sie Modelle verfälschen.
Tracking des Modellverhaltens: Regelmäßige Überprüfungen vergleichen den Modell-Output mit Baselines. Eine unerwartete Veränderung von Präzision oder Leistung kann ein Zeichen für Data Poisoning sein. Canary-Tests helfen, solche Probleme frühzeitig zu finden.
Techniken zur schnellen Erkennung von Data Poisoning
Eine schnelle Erkennung von Vorfällen begrenzt den Schaden, den Data Poisoning im Unternehmen anrichtet. Mit den folgenden Maßnahmen lassen sich Probleme in Echtzeit beheben:
Einsatz von Algorithmen zur Anomalieerkennung
Ausgefeilte Algorithmen decken Datenanomalien auf, die auf Manipulationsversuche hindeuten. Zentrale Strategien sind:
Statistische Methoden: Sie finden Anomalien und Trends, die auf Datenmanipulation hindeuten können. Clustering-Verfahren etwa identifizieren Datenpunkte, die stark vom Mittelwert abweichen.
ML-basierte Erkennung: Als zusätzliche Schutzebene identifizieren ML-Modelle typische Muster in manipulierten Daten. Das hilft, Metriken und die Funktionsweise von Modellen im Blick zu behalten, die direkt mit sensiblen Informationen arbeiten.
Regelmäßige System-Audits
Regelmäßige System-Audits sichern die Verlässlichkeit der Daten und decken frühe Anzeichen von Data Poisoning auf. Zentrale Strategien sind:
Leistungsüberwachung: Wer die Systemleistung kontinuierlich anhand eines Validierungs-Datasets verfolgt, erkennt ungewöhnliche Einbrüche bei Genauigkeit, Präzision oder Recall, die auf Data Poisoning hindeuten können.
Verhaltensanalyse: Die Analyse des Systemverhaltens bei gezielten Testfällen oder Edge Cases kann Schwachstellen durch Data Poisoning aufdecken. Solche Schwachstellen entstehen, wenn Systeme Daten aus einer nicht angeforderten, unbekannten Quelle aufnehmen.
Datenintegrität ist entscheidend, denn sie bleibt in vielen Branchen die wichtigste Grundlage für Entscheidungen, besonders dort, wo KI schnell Einzug hält. Kontinuierliche Innovation und Zusammenarbeit sind daher nötig, um einen Vorsprung vor dem Wettbewerb zu halten und die Zuverlässigkeit und Sicherheit datengetriebener Systeme zu gewährleisten.
Aktionsplan für die schnelle Reaktion nach einem Data-Poisoning-Angriff
Was passiert, wenn ein manipulierter Datenpunkt plötzlich vor der Tür steht? Sicherheitsteams brauchen einen Plan zur Erkennung und Behebung, mit dem sich Schäden verhindern, begrenzen und beheben lassen.
Fünf Schritte helfen bei der Umsetzung:
1. Echtzeitüberwachung und Alarme
Die erste Verteidigungslinie ist eine kontinuierliche Überwachung. Sicherheitsteams können Automatisierung und Alarme nutzen, um Daten-Pipelines und KI-Modelle abzusichern und zu überwachen. Fortschrittliche Monitoring-Lösungen wie Wiz erkennen zudem Anomalien, validieren Daten und liefern priorisierte, kontextbezogene Risikobewertungen, damit Teams sich auf die kritischsten Bedrohungen konzentrieren können.
ÜBERWACHUNG UND ERKENNUNG LASSEN SICH SOFORT VERBESSERN: MIT AUTOMATISCHEN ECHTZEITPRÜFUNGEN, INDIVIDUELL ANGEPASSTEN ALARMSCHWELLEN UND DER INTEGRATION VON ALARMEN IN DIE INCIDENT-RESPONSE-PROZESSE.
2. Rollback auf ein sauberes Dataset oder einen sauberen Modellzustand
Wird Data Poisoning erkannt, müssen sich Systeme schnell auf eine intakte Infrastruktur zurücksetzen lassen, um Unterbrechungen zu vermeiden.
Am wirksamsten lässt sich ein Dataset bereinigen, wenn regelmäßige Backups der Trainings-Datasets und Modell-Checkpoints vorliegen. Für saubere Zustände eignen sich Versionskontrollsysteme wie Git für Code oder DVC für Daten. Automatisierte Rollback-Skripte ermöglichen zudem eine schnelle Wiederherstellung und minimieren Ausfallzeiten.
ZUR UMSETZUNG EIGNEN SICH AUTOMATISIERTE, VERSIONIERTE BACKUPS FÜR DATASETS UND MODELLE NACH FESTEM ZEITPLAN, TOOLS WIE DVC ZUR VERWALTUNG VON MODELLEN UND REPRODUZIERBAREN DATEN SOWIE SIMULIERTE ROLLBACK-PROZEDUREN, UM DIE EINSATZBEREITSCHAFT ZU TESTEN.
3. Vorfallsuntersuchung und Ursachenanalyse
Sobald Dataset und Modelle wieder im Normalzustand sind, gilt es zu klären, was passiert ist und welche Schwachstelle den Angriff ermöglicht hat. Im Fokus stehen dabei Data Lineage und Tracking, um festzustellen, wo das Poisoning stattgefunden hat.
AI-SPM von Wiz etwa schafft Transparenz über Datenflüsse, Modellrevisionen und Angriffspfade. Damit lassen sich Logs und Datenänderungen auswerten, um das Einfallstor zu finden.
BEI DER UMSETZUNG DIESER TRACKING-SCHRITTE SOLLTEN ALLE ERKENNTNISSE DOKUMENTIERT WERDEN, DAMIT SICH DER INCIDENT-RESPONSE-PLAN AKTUALISIEREN LÄSST.
4. Erneute Validierung und Bereinigung der Daten
Mit dem Rollback ist die Behebung nicht abgeschlossen. Jetzt müssen die Informationen erneut geprüft werden. Tools wie OpenRefine oder Trifacta Wrangler automatisieren das Entfernen verdächtiger Datenpunkte.
ALGORITHMEN ZUR ANOMALIEERKENNUNG UND CLUSTERING-ALGORITHMEN AUF NEUE UND HISTORISCHE DATEN ANWENDEN UND INFORMATIONEN MIT ANDEREN MASSGEBLICHEN ODER VERTRAUENSWÜRDIGEN QUELLEN ABGLEICHEN.
5. Patching und Härtung der Daten-Pipelines
Nach der Überprüfung der Daten sollten Sicherheitsteams neue Schritte und Anpassungen festlegen, damit sich ein ähnlicher Angriff nicht wiederholt.
Ein guter Anfang ist ein besseres Tracking der Data Lineage, ergänzt um strengere Zugriffskontrollen für alle Datenquellen. Anschließend lassen sich Daten über eine ELT-Pipeline-Architektur (Extract, Load, Transform) zusammenführen. Das zentralisiert die Prozesse und reduziert Risiken durch fragmentierte Abläufe. Zum Schluss sollten KI-Ressourcen und Pipelines konsequent auditiert und Penetrationstests durchgeführt werden.
DAS PRINZIP DER GERINGSTEN BERECHTIGUNG FÜR SENSIBLE DATENQUELLEN REGELMÄSSIG DURCHSETZEN UND ZUGANGSDATEN ROTIEREN. DAS BEGRENZT DIE ANGRIFFSFLÄCHE, FALLS ZUGANGSDATEN KOMPROMITTIERT WERDEN, UND STELLT SICHER, DASS NUR AUTORISIERTE PERSONEN AUF SENSIBLE DATEN ZUGREIFEN. SO SINKT DAS RISIKO VON DATA POISONING.
Wiz als einfachster Weg zur Erkennung und Eindämmung von Data-Poisoning-Risiken
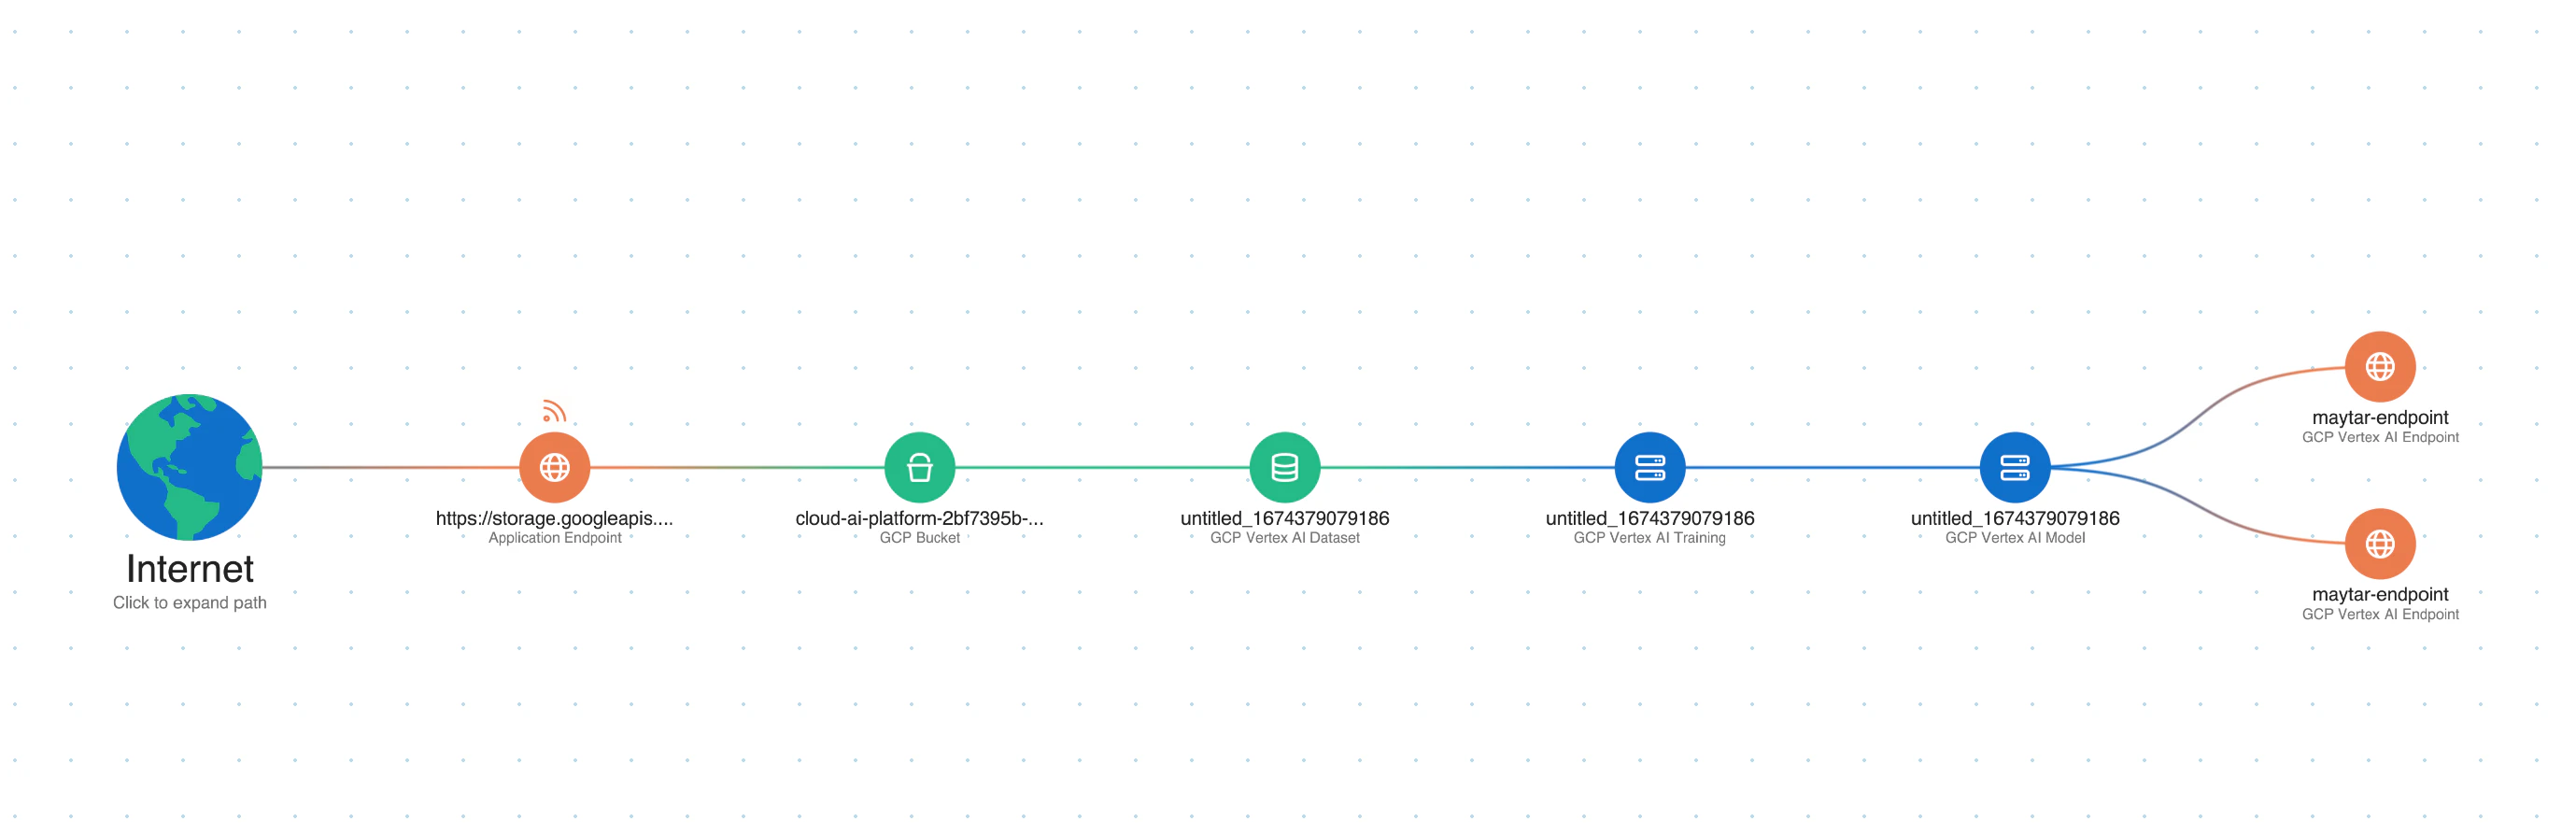
AI-SPM umfasst eine Reihe von Funktionen, die KI-Pipelines absichern und die Einführung von KI beschleunigen. Gleichzeitig schützt AI-SPM vor den damit verbundenen Risiken in Cloud-Umgebungen. Wiz war 2023 die erste CNAPP-Plattform (Cloud-Native Application Protection Platform), die AI-SPM-Funktionen mit nativen KI-Sicherheitsfunktionen eingeführt hat.
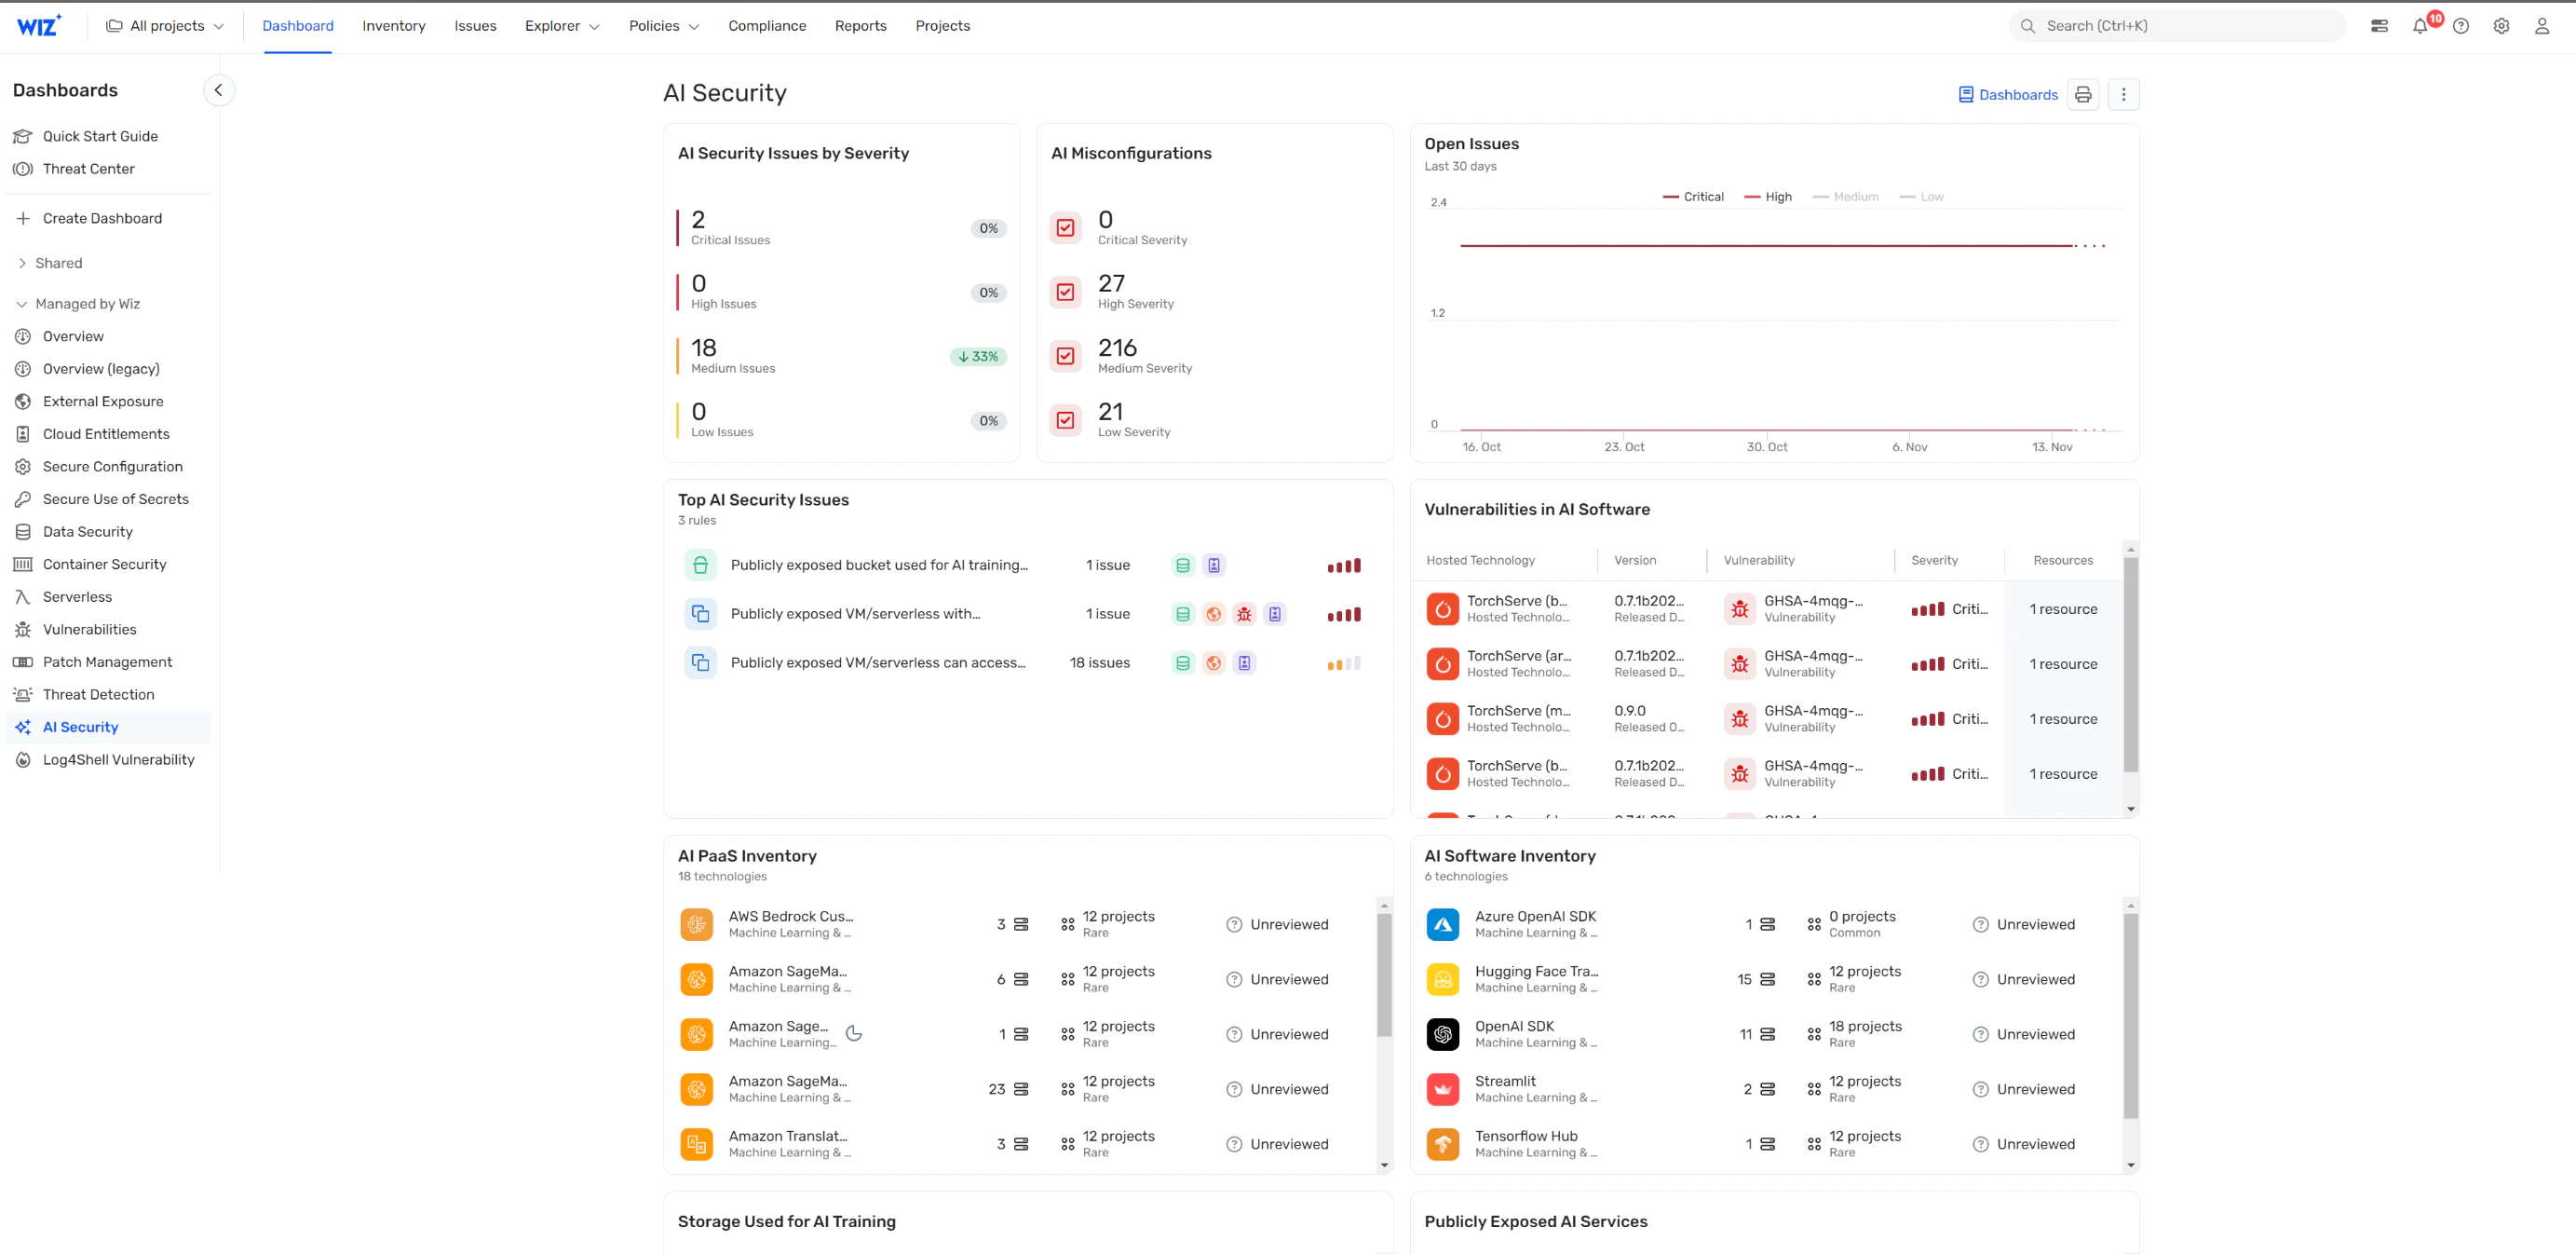
Wiz bietet mehrere Funktionen, mit denen Teams Data-Poisoning-Risiken in KI-Systemen erkennen und eindämmen können:
Full-Stack-Transparenz: Die AI Bill of Materials von Wiz schafft umfassende Transparenz über KI-Pipelines, Dienste, Technologien und Software Development Kits, und zwar ohne Agents. So lassen sich potenzielle Einfallstore für Data-Poisoning-Angriffe identifizieren.
Datensicherheit für KI: Die Plattform erweitert ihre Funktionen für data security posture management auf KI. Sie erkennt automatisch sensible Trainingsdaten und identifiziert Risiken durch Datenlecks. Das schützt vor unbefugtem Zugriff oder einer Manipulation von Trainingsdaten, die zu Poisoning führen könnte.
Attack path analysis: Die attack path analysis von Wiz erstreckt sich auch auf KI-Systeme. Damit lassen sich potenzielle Angriffspfade zu KI-Modellen und Trainingsdaten erkennen und Schwachstellen identifizieren, die für Data Poisoning ausgenutzt werden könnten.
Erkennung von KI-Fehlkonfigurationen: Die Lösung setzt sichere Konfigurations-Baselines für KI-Dienste durch und erkennt Fehlkonfigurationen mithilfe integrierter Regeln und KI-Risikomanagement. Korrekte Konfigurationen helfen, unbefugten Zugriff auf Trainingsdaten und Modelle zu verhindern.
Modell-Scanning: Wiz bietet Funktionen für Modell-Scanning, die potenzielle Probleme in KI-Modellen erkennen. Dazu gehören Anzeichen von Data Poisoning oder unerwartetes Verhalten infolge kompromittierter Trainingsdaten.
KI-Sicherheitsdashboard: Die CNAPP-Plattform bietet ein KI-Sicherheitsdashboard mit einem Überblick über die wichtigsten KI-Sicherheitsprobleme, einschließlich einer priorisierten Risiko-Warteschlange. So können KI-Entwicklungs- und Sicherheitsteams potenzielle Data-Poisoning-Bedrohungen schnell erkennen und beheben.
Im Zusammenspiel dieser Funktionen ermöglicht die AI-SPM-Lösung von Wiz Unternehmen, Data-Poisoning-Risiken in ihrer gesamten KI-Infrastruktur proaktiv zu erkennen und einzudämmen, von den Trainingsdaten bis zu den Modellen im Deployment.
Erfahren Sie, wie Wiz Teams dabei unterstützen kann, Risiken in KI-Pipelines und Trainingsdaten im Kontext ihrer Cloud-Umgebung zu erkennen und zu priorisieren. Wiz in Aktion erleben