
Enterprise AI: Definition und Grundlagen
Enterprise AI bezeichnet den Einsatz von KI-Technologien im gesamten Unternehmen, um Aufgaben zu automatisieren, bessere Entscheidungen zu unterstützen und messbare Geschäftsergebnisse zu erzielen. Dabei handelt es sich nicht um ein einzelnes Tool. Vielmehr geht es um eine Reihe von Fähigkeiten, die in die Systeme eingebettet sind, die Mitarbeitende und Kunden bereits nutzen.
In der Praxis ist KI damit in zentrale Geschäftsplattformen eingebunden: Enterprise Resource Planning (ERP), Customer Relationship Management (CRM), HR-Systeme und Supply-Chain-Tools. Statt einer separaten „KI-Anwendung“ am Rand fließt die Intelligenz direkt in bestehende Workflows ein. Mitarbeitende erhalten Empfehlungen, Prognosen und Automatisierung in ihren gewohnten Tools.
Weil Enterprise-AI-Systeme in zentrale Geschäftsplattformen eingebettet sind und sensible Daten verarbeiten, wird KI-Sicherheit zur Grundvoraussetzung. Wer Enterprise AI absichert, schützt nicht nur Modelle. Ebenso wichtig sind die Daten-Pipelines, Identitäten und die Cloud-Infrastruktur, auf die KI-Systeme angewiesen sind.
Moderne Enterprise AI setzt sich aus mehreren Kerntechnologien zusammen:
Machine Learning (ML): Algorithmen erkennen Muster in historischen Daten und sagen so etwa Nachfrage, Kundenabwanderung oder Betrug vorher.
Natural Language Processing (NLP): Modelle verstehen und erzeugen menschliche Sprache. Das ermöglicht Dokumentenanalyse, Chatbots und Sentiment-Analyse.
Computer Vision: Systeme interpretieren Bilder und Videos, etwa für Qualitätsprüfungen oder Identitätsverifizierung.
Generative KI und Large Language Models (LLMs): Sie erstellen Inhalte, schreiben Code, fassen Dokumente zusammen und unterstützen Mitarbeitende als „Copiloten“.
Enterprise AI arbeitet außerdem in einem deutlich größeren Maßstab als typische Nebenprojekte. Modelle bedienen unter Umständen Tausende Personen, verarbeiten Millionen Ereignisse pro Tag und laufen über mehrere Regionen und Clouds hinweg. Deshalb müssen sie mit hoher Zuverlässigkeit, starker Sicherheit und regulatorischen Kontrollen aufgebaut und betrieben werden. Dazu gehören klare Richtlinien zur Datenresidenz, Datenschutzmaßnahmen und klar definierte Grenzen der geteilten Verantwortung mit Cloud-KI-Anbietern (AWS Bedrock, Azure OpenAI Service, Google Vertex AI).
Enterprise AI im Unternehmensalltag
Enterprise AI lässt sich am besten verstehen, wenn man betrachtet, wo sie im Arbeitsalltag auftaucht. Die meisten Teams erleben KI über die Anwendungen, die sie bereits nutzen, statt über eine separate „KI-Plattform“.
Operations und Prozessautomatisierung nutzen KI, um Dokumente zu lesen, zu klassifizieren und ohne menschliches Eingreifen weiterzuleiten. Intelligent Document Processing extrahiert beispielsweise Daten aus Rechnungen oder Verträgen, validiert sie und überträgt sie in Back-Office-Systeme.
Vertriebs- und Marketingteams setzen Enterprise-AI-Lösungen ein, um Leads zu bewerten, Kunden zu segmentieren und Angebote zu personalisieren. Modelle lernen, welche Aktionen und Botschaften zu Abschlüssen oder mehr Engagement führen, und schlagen dem Vertrieb die nächstbesten Schritte vor.
Kundensupport-Teams begegnen KI in Chatbots, die häufige Fragen beantworten, und in intelligentem Routing, das Tickets an das richtige Team leitet. Das verkürzt die Bearbeitungszeit und hebt Fälle hervor, die tatsächlich menschliche Expertise brauchen.
Finanz- und Risikobereiche nutzen Enterprise Machine Learning, um Betrug zu erkennen, Kreditrisiken zu bewerten und die Einhaltung regulatorischer Vorgaben zu überwachen. Modelle suchen nach ungewöhnlichen Mustern in Transaktionen und alarmieren Teams, sobald etwas von den Richtlinien abweicht.
Engineering- und IT-Teams profitieren von KI-Copiloten, die bei Codegenerierung, Testerstellung und Infrastrukturautomatisierung unterstützen. Untersuchungen zeigen, dass diese Tools die Zykluszeit für PR-Reviews um 31,8 % verkürzen und so die Softwareauslieferung direkt beschleunigen. KI kann Konfigurationsänderungen vorschlagen oder bei der Fehlersuche helfen, indem sie Logs zusammenfasst und wahrscheinliche Ursachen benennt.
Fertigung und Logistik setzen auf Computer Vision und Zeitreihenmodelle für Predictive Maintenance und Qualitätsprüfung. Diese Anwendungen wirken sich direkt auf Verfügbarkeit, Kosten und Sicherheit aus.
Wissensmanagement verändert sich grundlegend durch LLM-basierte Unternehmenssuche, Dokumentenzusammenfassungen und interne Q&A-Assistenten. Statt sich durch Wikis und PDFs zu wühlen, stellen Mitarbeitende Fragen und erhalten kontextbezogene Antworten auf Basis von Unternehmensinhalten.
In all diesen Anwendungsfällen arbeitet KI mit sensiblen Daten, zentraler Geschäftslogik und kritischer Infrastruktur. Deshalb gehören Governance, Architektur und Sicherheit von Anfang an ins Design. Nachträglich angeflanscht funktionieren sie nicht.
Unterschiede zwischen Enterprise AI und KI-Einsatz im kleinen Maßstab
Enterprise AI unterscheidet sich von kleinen Experimenten oder Consumer-Tools vor allem in zwei Punkten: Sie ist tief im Unternehmen verankert, und Fehler haben eine entsprechend große Tragweite.
Auf Unternehmensebene arbeiten KI-Systeme in erheblichem Maßstab. Modelle werden unter Umständen mit historischen Daten aus vielen Jahren trainiert und liefern Prognosen oder Empfehlungen an Tausende Personen gleichzeitig. Diese Workloads laufen oft kontinuierlich und unterstützen zentrale Geschäftsfunktionen statt isolierter Anwendungsfälle.
Enterprise AI baut zudem auf gemeinsam genutzten Plattformen und Infrastrukturen auf. Modelle greifen häufig auf zentrale Data Lakes, geteilte GPU-Cluster und gemeinsame Messaging-Systeme zurück. Das steigert die Effizienz, erhöht aber auch das Risiko: Eine einzige Fehlkonfiguration in einem gemeinsam genutzten Dienst kann mehrere Teams und Geschäftsbereiche gleichzeitig betreffen.
Deployments verteilen sich typischerweise über mehrere Regionen und Clouds. Dieselbe KI-Plattform unterstützt etwa Finanzteams in Europa, Marketingteams in Nordamerika und Operations-Teams in Asien, jeweils mit eigenen regulatorischen Anforderungen und Vorgaben zur Datenresidenz. Sicherheits- und Governance-Kontrollen müssen diese Komplexität von Anfang an berücksichtigen.
Anders als kurzlebige Proofs of Concept sind Enterprise-AI-Systeme langfristig betriebene Produktionsdienste. Sie erfordern Versionierung, Monitoring und Incident-Response-Prozesse wie jede andere kritische Infrastruktur. Mit der Zeit entstehen Abhängigkeiten zu Daten-Pipelines, Identitäten und nachgelagerten Anwendungen, wodurch ihr potenzieller Schadensradius wächst.
Und schließlich verarbeitet Enterprise AI routinemäßig hochwertige und regulierte Daten, darunter Kundendaten, Finanzinformationen und geistiges Eigentum. Ein einziger offen erreichbarer Modell-Endpunkt oder ein überberechtigtes Service-Konto kann mehrere Systeme und Nutzergruppen gleichzeitig beeinträchtigen. Deshalb braucht Enterprise AI klare Zuständigkeiten, Verantwortlichkeit und Governance, die weit über das hinausgehen, was beim KI-Einsatz im kleinen Maßstab nötig ist.
Auswirkungen von Enterprise AI auf Sicherheit und Governance
Sobald KI Teil zentraler Geschäftsabläufe wird, reichen die Sicherheitsrisiken über einzelne Modelle hinaus. Enterprise-AI-Systeme übernehmen die Zugriffsrechte, Privilegien und das Vertrauen der Plattformen, in die sie integriert sind. Fehler können sich deshalb auf das gesamte Unternehmen auswirken.
Risiken durch Datenzugriff und Datenoffenlegung
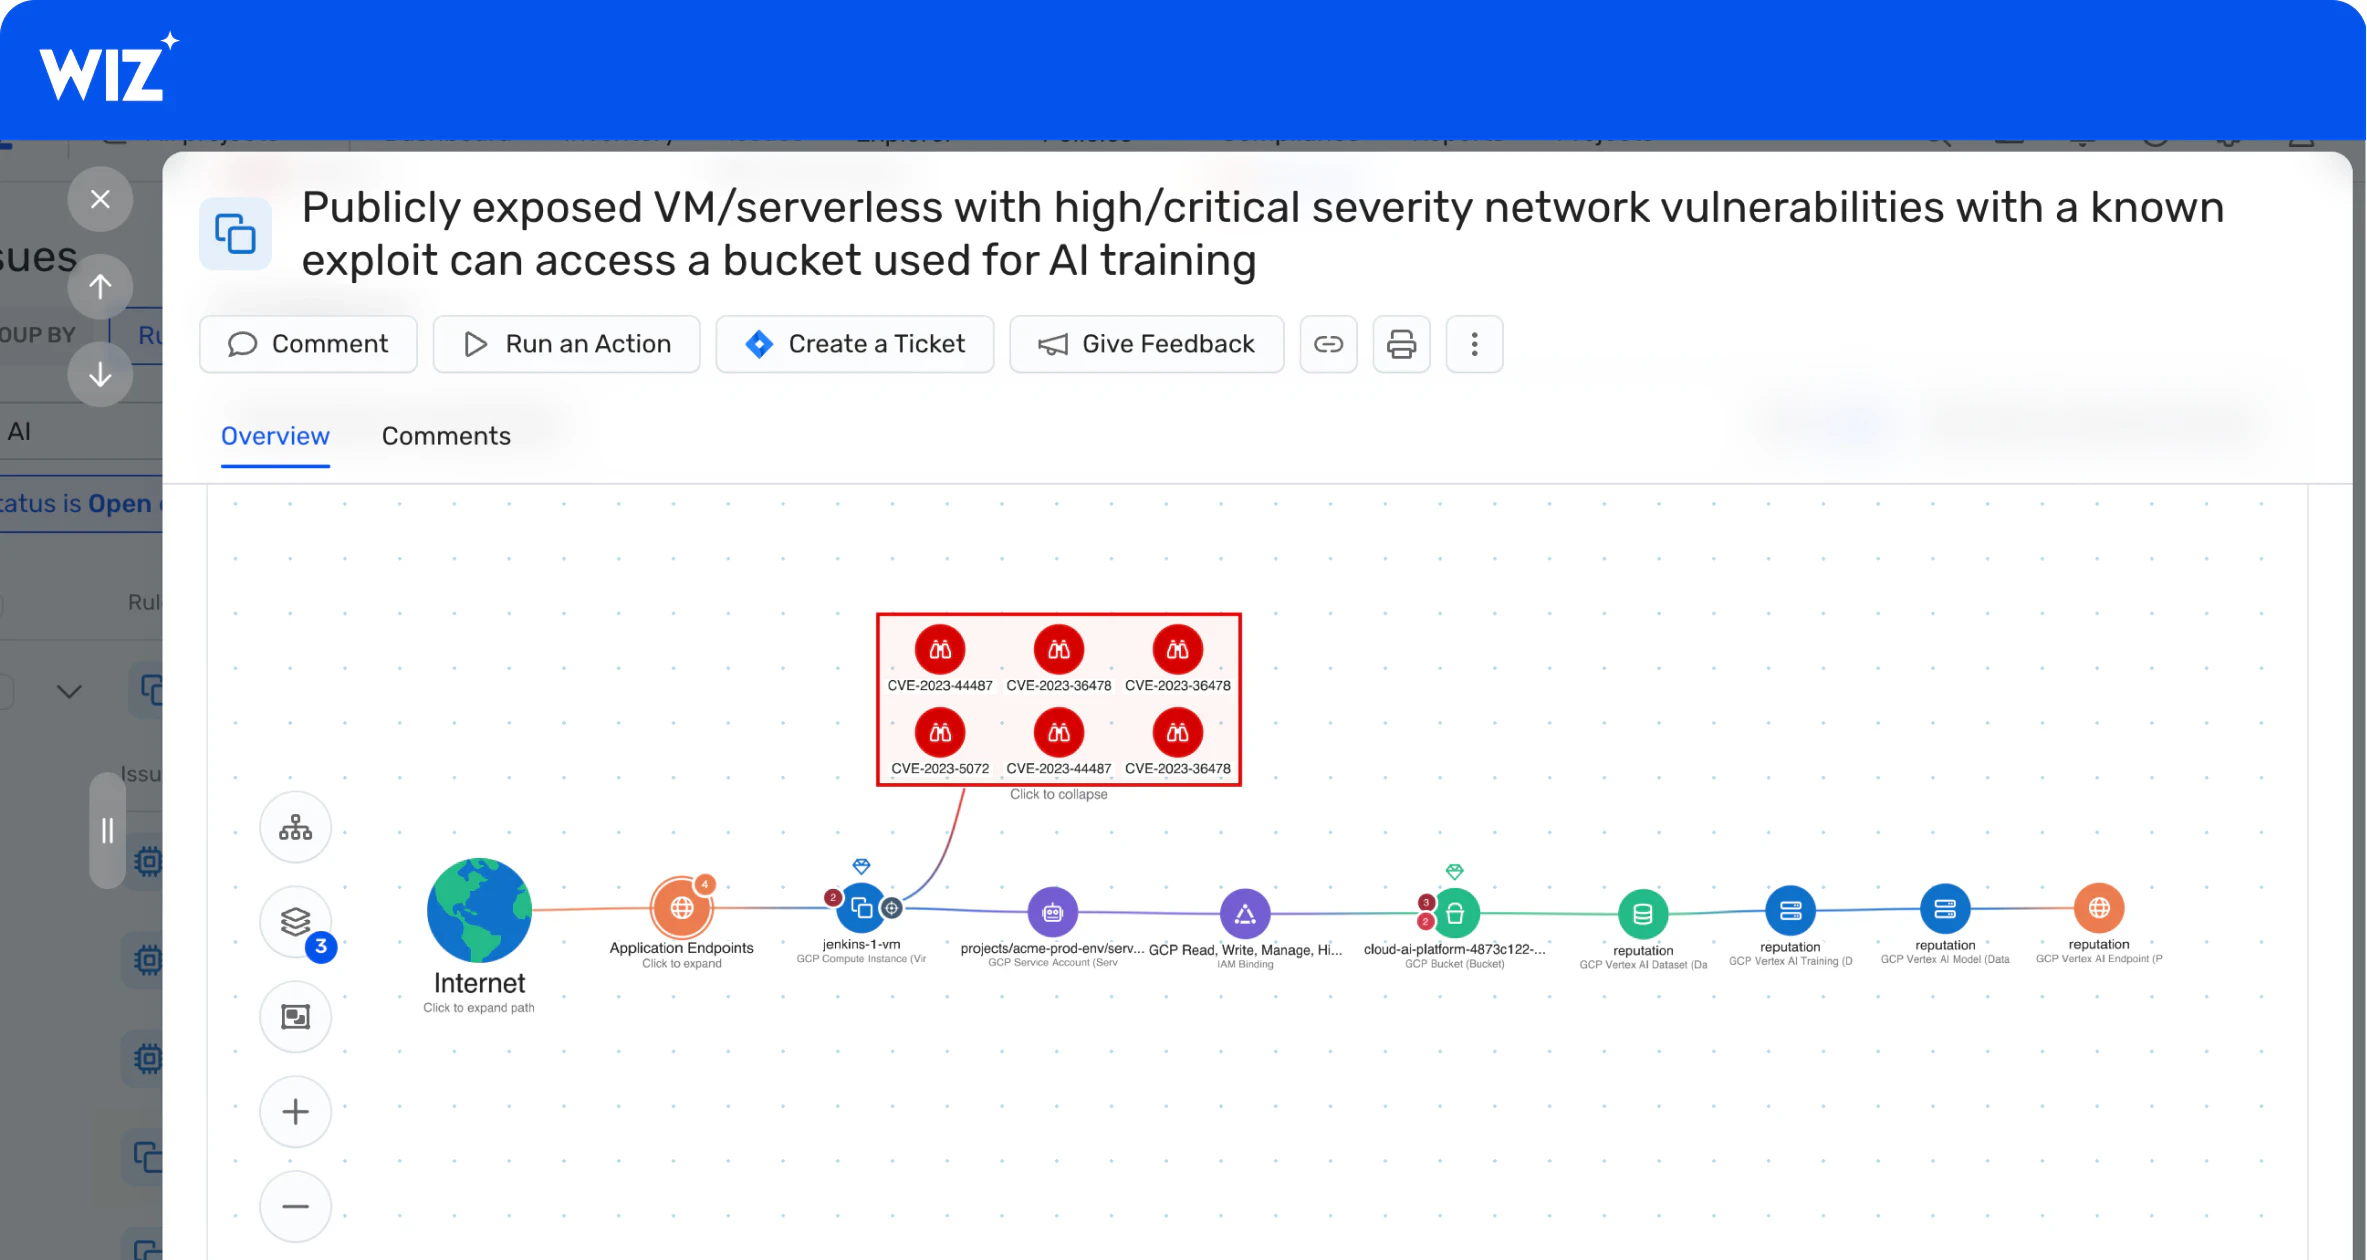
Enterprise-AI-Systeme interagieren routinemäßig mit sensiblen Geschäftsdaten wie Kundendaten, Finanzinformationen und geistigem Eigentum. Trainings-Datasets, Feature Stores, Prompts und Retrieval-Quellen sind jeweils potenzielle Einfallstore für Datenabfluss. Ohne starke Data Governance können sensible Informationen durch Fehlkonfigurationen, zu weit gefasste Zugriffsrechte oder ungewollte Modell-Outputs nach außen gelangen.
Um dieses Risiko zu steuern, braucht es Transparenz darüber, wie Daten durch KI-Pipelines fließen und welche Identitäten darauf zugreifen dürfen.
Identitäts- und Berechtigungsmanagement
KI-Workflows nutzen Service-Konten, API-Schlüssel und Managed Identities, um Daten abzurufen und nachgelagerte Dienste aufzurufen. Sind diese Identitäten überberechtigt, eröffnen sie Möglichkeiten für Lateral Movement über Cloud-Umgebungen hinweg. In großen Unternehmen kann eine einzige falsch konfigurierte KI-Service-Identität mehrere Systeme und Datasets offenlegen.
Zugriffe nach dem Prinzip der geringsten Berechtigung und eine kontinuierliche Überprüfung von Berechtigungen sind unerlässlich, um den Schadensradius zu begrenzen.
KI-spezifische Angriffsmuster
Enterprise AI bringt Sicherheitsherausforderungen mit sich, die klassische Anwendungskontrollen nicht vollständig abdecken. Pipelines für Retrieval-Augmented Generation (RAG) vergrößern die Angriffsfläche, weil sie Daten dynamisch in den Modellkontext laden. Angriffe per Prompt Injection können Retrieval-Logik oder Tool-Ausführung manipulieren, um auf nicht autorisierte Datenquellen zuzugreifen oder Informationen auszuleiten.
Im großen Maßstab entstehen zudem Integritätsrisiken. Vergiftete Trainingsdaten können das Modellverhalten verändern, während gezielt manipulierte Eingaben (Adversarial Inputs) irreführende Outputs erzeugen, ohne dass offensichtliche Fehlersignale auftreten. In manchen Fällen können Angreifer aus Modellantworten sogar auf sensible Trainingsdaten schließen, obwohl die Systeme scheinbar normal funktionieren.
Governance- und Compliance-Anforderungen
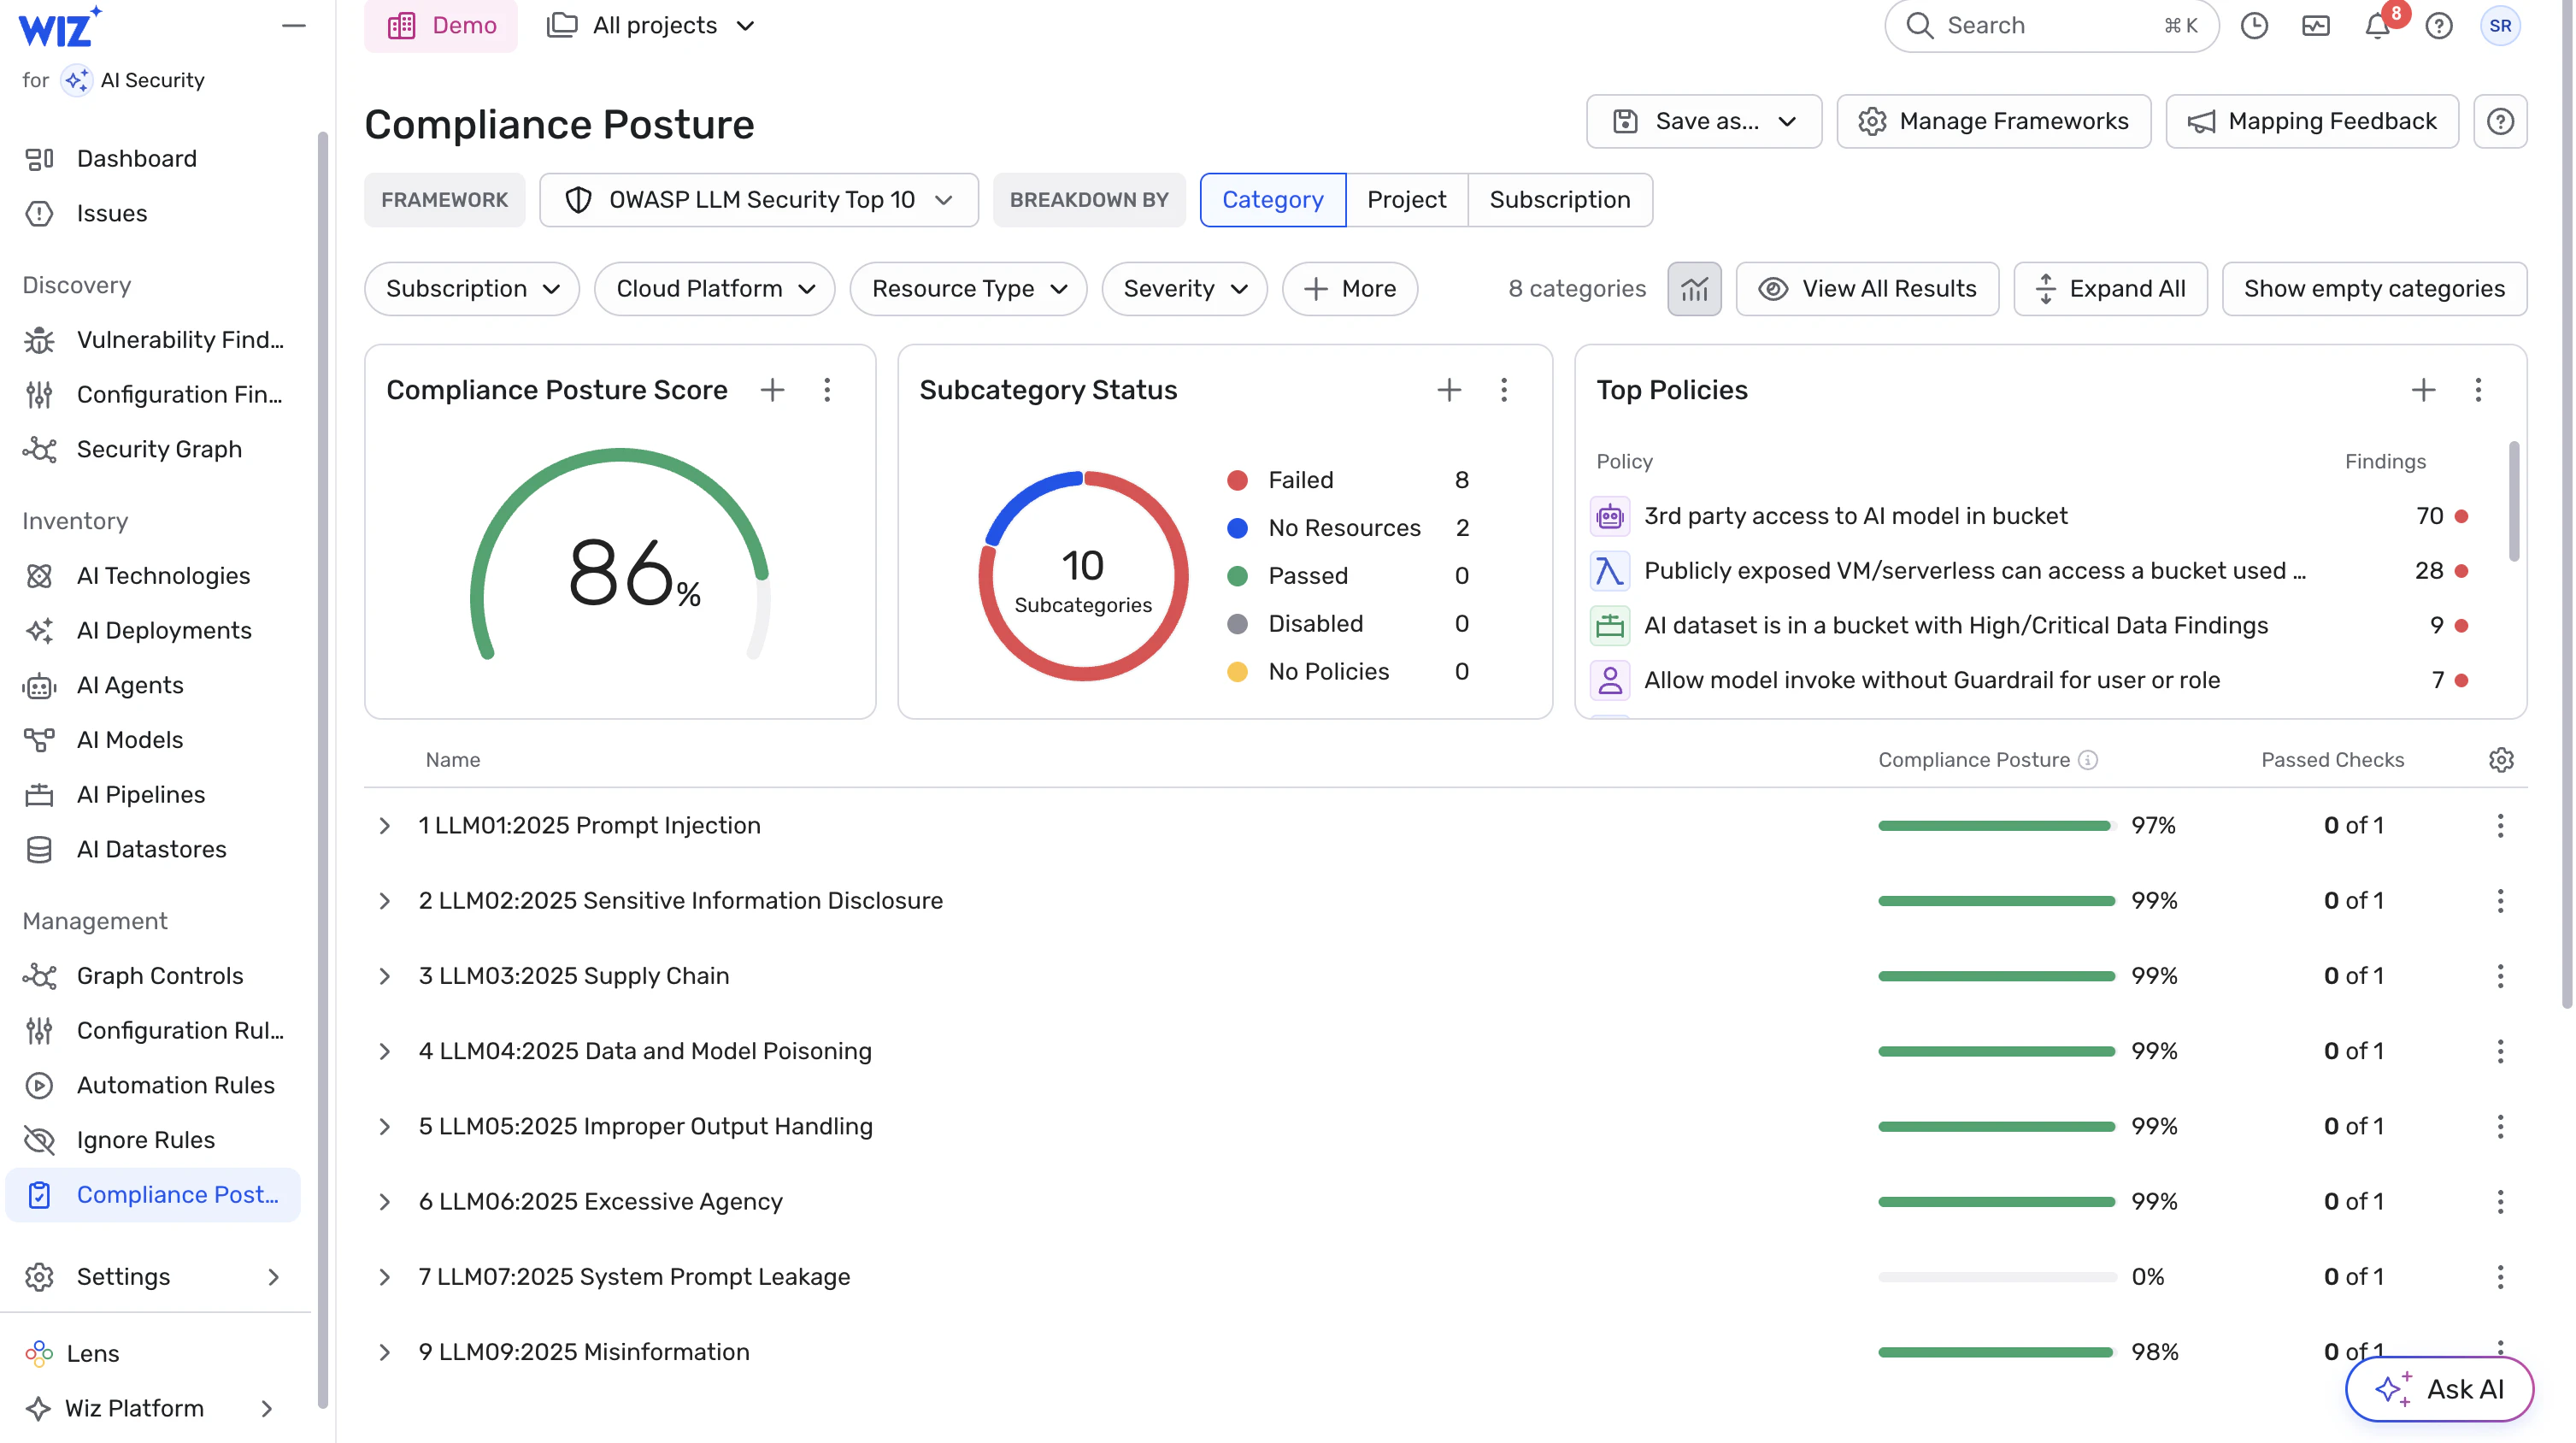
Sobald KI-Systeme Entscheidungen beeinflussen und Workflows automatisieren, wird Governance zur Pflicht. Unternehmen müssen festlegen, wer Modelle bereitstellen darf, auf welche Daten diese zugreifen können und wie Outputs und Entscheidungen protokolliert und geprüft werden. Ohne klare Zuständigkeiten und Nachvollziehbarkeit lassen sich Vorfälle nur schwer untersuchen, und der Nachweis der Compliance wird schwierig.
Enterprise-AI-Deployments müssen sich außerdem an regulatorischen und Governance-Frameworks orientieren. Dazu zählen DSGVO (GDPR), CCPA, SOC 2, ISO/IEC 27001, ISO/IEC 42001, das NIST AI Risk Management Framework und in einigen Regionen der EU AI Act.
Es geht nicht darum, Innovation auszubremsen. Vielmehr sollen KI-Systeme vertrauenswürdig und kontrollierbar bleiben, während sie im gesamten Unternehmen skalieren.
Herausforderungen bei der Einführung von Enterprise AI
Selbst wenn der Nutzen von Enterprise AI klar ist, bleibt der Schritt vom Pilotprojekt zum Produktivsystem schwierig. Die meisten Hürden entstehen bei der Integration von KI in bestehende Umgebungen, nicht bei den Modellen selbst.
Integration von KI in Legacy-Systeme
Viele Unternehmen setzen auf Legacy-Datenbanken und -Anwendungen, die nie für Echtzeitanalysen oder KI-gestützte Workflows ausgelegt waren. Moderne KI-Dienste an diese Systeme anzubinden, erfordert eine durchdachte Architektur, Datennormalisierung und Zugriffskontrollen. Ohne diese Grundlagen kommen KI-Projekte kaum über das Experimentierstadium hinaus.
Skalierung vom Pilotprojekt zur Produktion
KI-Proofs-of-Concept funktionieren in isolierten Umgebungen oft gut, lassen sich aber nicht skalieren. Produktions-Deployments müssen Zuverlässigkeit, Failover, Monitoring und regionale Verfügbarkeit abdecken. Branchenstudien zeigen, dass nur ein kleiner Teil der Unternehmen KI-Systeme erfolgreich im großen Maßstab betreibt. Das verdeutlicht die Lücke zwischen Experiment und Unternehmensreife.
Datenqualität, Datenzugriff und Governance
KI-Systeme brauchen hochwertige Daten. Gleichzeitig müssen Unternehmen strenge Zugriffskontrollen für sensible Datasets durchsetzen. Teams tun sich oft schwer, Modellgenauigkeit mit Datenminimierung und Compliance-Anforderungen in Einklang zu bringen. Dieser Zielkonflikt zwischen Datenverfügbarkeit und Sicherheit bremst die Einführung und sorgt für Reibung im Betrieb.
Fragmentierte Zuständigkeiten über Teams hinweg
Enterprise-AI-Initiativen erstrecken sich über Data Engineering, Data Science, Anwendungsentwicklung und Sicherheitsteams. Sind Zuständigkeiten unklar, bleiben Aufgaben wie Modell-Retraining, Zugriffsprüfungen oder Incident Response leicht liegen. Wer Transparenz und Richtliniendurchsetzung bündelt, reduziert Übergaben und verkürzt die Zeit bis zur Behebung.
Inkonsistente Umgebungen und Konfigurationen
KI-Systeme verhalten sich in Entwicklungs-, Staging- und Produktionsumgebungen häufig unterschiedlich. Ursache sind auseinanderdriftende Konfigurationen (Configuration Drift) oder inkonsistente Zugriffsrichtlinien. Diese Unterschiede erschweren die Fehlersuche und schaffen Risiken, wenn Änderungen ohne vollständige Transparenz über ihre Auswirkungen in die Produktion gelangen.
Shadow AI und unkontrollierte Tools
Entwicklungsteams können KI-Tools über SaaS-Plattformen leicht ohne zentrale Freigabe einführen. Das beschleunigt Innovation, lässt aber auch Shadow AI entstehen: Pipelines, die außerhalb etablierter Governance- und Sicherheitskontrollen laufen. Ohne Transparenz über diese Tools können Unternehmen ihr Risiko nicht zuverlässig bewerten.
Herausforderungen bei Transparenz und Kostenkontrolle
Vielen Unternehmen fehlt eine zentrale Übersicht über ihre KI-Workloads, Modelle und Datenflüsse in Cloud-Umgebungen. Das erschwert es, den Sicherheitsstatus zu bewerten, einheitliche Richtlinien durchzusetzen oder Kosten zu kontrollieren. Ohne Observability können die Ausgaben für KI-Infrastruktur schneller wachsen als der geschäftliche Nutzen.
Diese Herausforderungen erklären, warum die Einführung von Enterprise AI nach ersten Erfolgen oft ins Stocken gerät. Um sie zu lösen, braucht es nicht nur bessere Modelle. Gefragt sind auch klarere Zuständigkeiten, mehr Transparenz und Sicherheitskontrollen, die mit den KI-Workloads mitwachsen.
Referenzarchitektur für sichere Enterprise AI
Eine sichere Enterprise-AI-Architektur verbindet Daten, Modelle und Anwendungen und zieht auf jeder Ebene klare Sicherheitsgrenzen. Ziel ist nicht, alles abzuriegeln. Zugriffe sollen über den gesamten KI-Lebenszyklus hinweg bewusst, beobachtbar und nachvollziehbar sein.
Datenquellen, Datenaufnahme und Datenresidenz
Enterprise-AI-Systeme übernehmen Daten aus operativen Plattformen wie CRM, ERP, Logs und Drittanbieterdiensten in zentrale Data Lakes oder Lakehouses. Daten sollten bereits bei der Aufnahme klassifiziert und getaggt werden. So greifen Sensibilitätsstufen und Zugriffsrichtlinien auch in allen nachgelagerten Systemen.
In Multi-Region- oder regulierten Umgebungen ist außerdem festzulegen, wo Daten verarbeitet und gespeichert werden. Kontrollen für Datenresidenz und Datensouveränität stellen sicher, dass Trainings-, Inferenz- und Retrieval-Pipelines regionale Anforderungen und vertragliche Verpflichtungen einhalten.
Feature Engineering und Feature Stores
Aufbereitete Merkmale für Machine-Learning-Modelle liegen in zentralen Feature Stores, damit Training und Inferenz konsistent bleiben. Zugriffskontrollen legen fest, welche Modelle und Teams bestimmte Merkmalsgruppen lesen dürfen. Data Lineage verknüpft die Merkmale mit den Quell-Datasets und unterstützt so Audits und die Untersuchung von Vorfällen.
Diese Ebene trägt dazu bei, dass Modelle nicht unbemerkt sensible oder gesperrte Daten verarbeiten.
Modelltraining, Validierung und Registry
Modelle werden in isolierten Umgebungen mit freigegebenen Datasets und temporären Anmeldedaten trainiert. Jeder Datenzugriff wird protokolliert, und ausgehende Verbindungen sind eingeschränkt, um den Schadensradius zu verringern.
Bevor Modelle in die Produktion gehen, sollten sie Sicherheits- und Integritätsprüfungen durchlaufen. Dazu gehören etwa Scans auf unbemerkte Datenlecks, die Validierung von Model Cards und Dokumentation sowie Adversarial Testing, um Backdoors oder unsicheres Verhalten aufzudecken. Freigegebene Modelle werden mit Metadaten zu Trainingsdaten, Leistungskennzahlen und vorgesehenem Einsatzzweck registriert.
Deployment, Inferenz und Eingabevalidierung
Modelle werden über kontrollierte CI/CD-Pipelines auf verwaltete Inferenz-Endpunkte oder in containerisierte Umgebungen ausgerollt. Netzwerkrichtlinien und API-Gateways erzwingen Authentifizierung, Autorisierung und Rate Limiting.
Zur Inferenzzeit sind Eingabevalidierung und Bereinigung entscheidend. Benutzereingaben und vorgelagerte Signale sollten auf Versuche von Prompt Injection oder fehlerhafte Anfragen geprüft werden, bevor sie das Modell erreichen. Das senkt das Risiko, dass Angreifer das Modellverhalten manipulieren oder nicht autorisierte Aktionen auslösen.
Pipelines für Retrieval-Augmented Generation (RAG)
Beim Einsatz von RAG speichern Vektordatenbanken ausschließlich Embeddings aus freigegebenen Quellen. Retrieval-Dienste setzen Zugriffskontrollen durch und prüfen, welche Dokumente für eine bestimmte Person oder Anwendung abgerufen werden dürfen.
Der abgerufene Kontext wird klar von der Benutzereingabe getrennt, um das Risiko indirekter Prompt Injection zu verringern. Eine Output-Validierung prüft Antworten auf den Abfluss sensibler Daten oder Richtlinienverstöße, bevor die Ergebnisse bei den Nutzenden ankommen.
Observability, Monitoring und Adversarial Testing
Logs und Metriken aus dem gesamten KI-Stack fließen in zentrale Monitoring-Systeme. Sicherheitsteams achten auf unerwartete Datenzugriffe, auffällige Nutzungsmuster von Modellen oder verdächtiges API-Verhalten.
Über das passive Monitoring hinaus sollten Unternehmen produktive Modelle regelmäßig mit Red Teaming und Adversarial Testing prüfen. Solche Übungen helfen, Guardrails zu validieren und Umgehungstechniken aufzudecken. Außerdem stellen sie sicher, dass Kontrollen wirksam bleiben, während sich Modelle und Daten weiterentwickeln.
Richtliniendurchsetzung über den gesamten Stack
Die Richtliniendurchsetzung stützt sich auf Cloud-Native Identity and Access Management im Zusammenspiel mit Kontrollen auf Plattformebene. Richtlinien nach dem Prinzip der geringsten Berechtigung legen fest, wer auf Daten zugreifen, Modelle trainieren, Endpunkte bereitstellen oder Inferenz aufrufen darf.
Eine konsistente Durchsetzung in Entwicklung, Staging und Produktion verringert Configuration Drift. Gleichzeitig wächst die Sicherheit mit der Einführung von Enterprise AI mit.
Diese Architektur aus mehreren Ebenen trennt Verantwortlichkeiten zwischen Daten-, ML-, Plattform- und Sicherheitsteams, ohne die gemeinsame Transparenz aufzugeben. Klare Grenzen, kontinuierliche Validierung und regelmäßige Tests helfen Unternehmen, KI im großen Maßstab einzusetzen, ohne die Kontrolle über Sicherheit und Governance zu verlieren.
Sichere Einführung von Enterprise AI mit Wiz
Wiz hilft Unternehmen, KI-Sicherheit in die Praxis umzusetzen. Dazu sichert Wiz die Cloud-Umgebungen, Identitäten und Datenflüsse ab, auf die Enterprise-AI-Systeme angewiesen sind. Statt KI als separaten Sicherheitsbereich zu behandeln, bewertet Wiz Enterprise-AI-Workloads im selben Code-to-Cloud-Kontext wie die übrige Infrastruktur des Unternehmens.
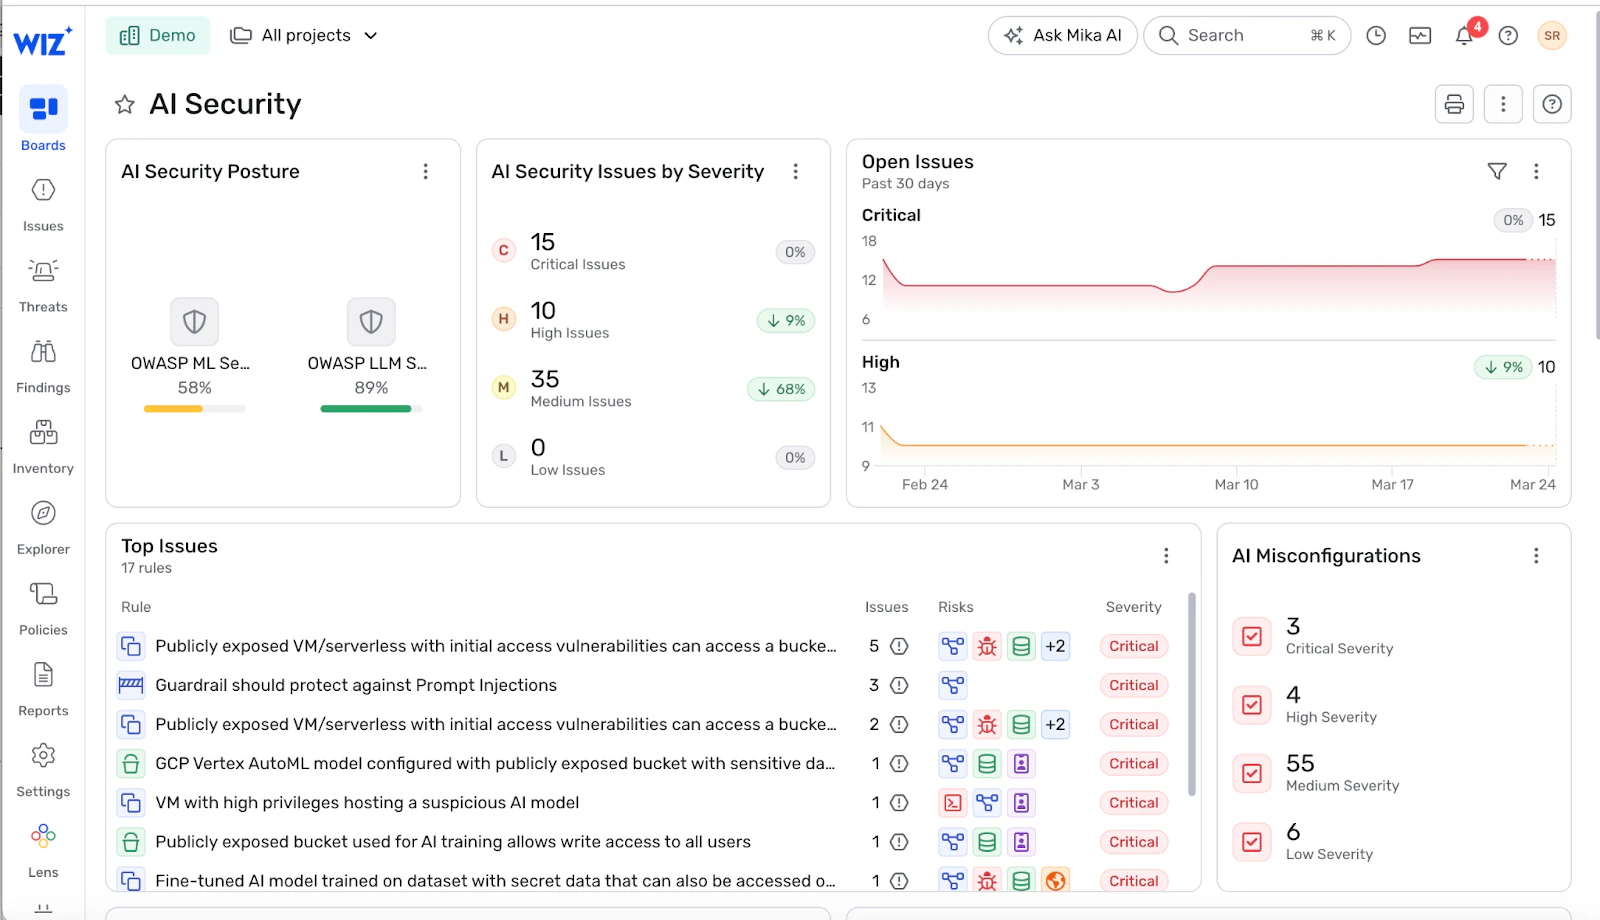
Mit Wiz AI Security Posture Management (AI-SPM) erhalten Unternehmen Transparenz über KI-bezogene Cloud-Dienste in AWS, Azure und Google Cloud. Dazu zählen verwaltete KI-Plattformen ebenso wie selbst gehostete Modelle auf Kubernetes oder virtuellen Maschinen. So lässt sich inventarisieren, wo Modelle laufen, auf welche Daten sie zugreifen können und welche Service-Identitäten mit ihnen interagieren dürfen.
Über den Wiz Security Graph verknüpft Wiz diesen KI-Sicherheitsstatus mit Cloud-Konfiguration, Identitätsberechtigungen und Datensensibilität. Statt isolierte Fehlkonfigurationen zu melden, zeigt Wiz echte Angriffspfade auf. Ein Beispiel ist ein öffentlich erreichbarer Inferenz-Endpunkt, der über ein überberechtigtes Service-Konto auf sensible Trainingsdaten zugreifen kann. Teams können die Behebung so nach den tatsächlichen geschäftlichen Auswirkungen priorisieren.
Wiz unterstützt Unternehmen außerdem dabei, ihren Sicherheitsstatus kontinuierlich zu validieren, während sich Enterprise AI weiterentwickelt. Änderungen an Daten-Pipelines, Modell-Deployments oder Zugriffsrichtlinien werden mit der bestehenden Angriffsfläche abgeglichen. Das senkt das Risiko, dass neue KI-Funktionen unbemerkte Sicherheitslücken schaffen. Mit diesem Ansatz können Teams Enterprise-AI-Initiativen skalieren und behalten dabei die Kontrolle über Sicherheit, Compliance und Governance.
Erfahren Sie, wie Wiz Sicherheitsrisiken in Enterprise-AI-Umgebungen im Kontext von Cloud-Infrastruktur, Identitäten und Datenflüssen sichtbar machen kann. Wiz in Aktion erleben