
|
L’adversarial AI est un type de cyberattaque. Elle injecte des données légèrement altérées dans des systèmes d’intelligence artificielle (IA) et de machine learning (ML). Elle amène ainsi ces systèmes à prendre de mauvaises décisions.
Ces attaques retournent contre l’IA les mêmes capacités qui la rendent utile. Les threat actors conçoivent des entrées malveillantes pour contourner les guardrails, empoisonner les données d’entraînement ou extraire des informations sensibles à partir du comportement du modèle. Les systèmes d’IA semblent alors fonctionner normalement, tout en servant discrètement les objectifs de l’attaquant.
Quand ces systèmes s’exécutent dans le cloud, l’adversarial AI n’est presque jamais un problème limité au modèle. Elle se rattache à des réalités cloud : qui peut appeler l’endpoint, quelles données le modèle lit et ce que le workload hôte atteint s’il est compromis. C’est en partie ce qui rend l’adversarial AI dangereuse.
Renforcez votre sécurité cloud
Découvrez des pratiques avancées pour réduire les risques, prioriser les actions clés et sécuriser vos environnements cloud.

Pourquoi les attaques d’adversarial AI sont-elles dangereuses ?
L’adoption rapide de l’IA dans des systèmes critiques a fait de l’adversarial AI une priorité de sécurité urgente. Quand l’IA alimente la détection de fraude, les véhicules autonomes ou des applications destinées aux clients, une attaque réussie provoque des dommages concrets à grande échelle.
Les recherches de Wiz montrent que 87 % des professionnels de la sécurité utilisent des services d’IA d’une façon ou d’une autre. Le déploiement de l’IA ouvre aussi des points d’entrée pour la manipulation adversariale. L’image ci-dessous l’illustre :
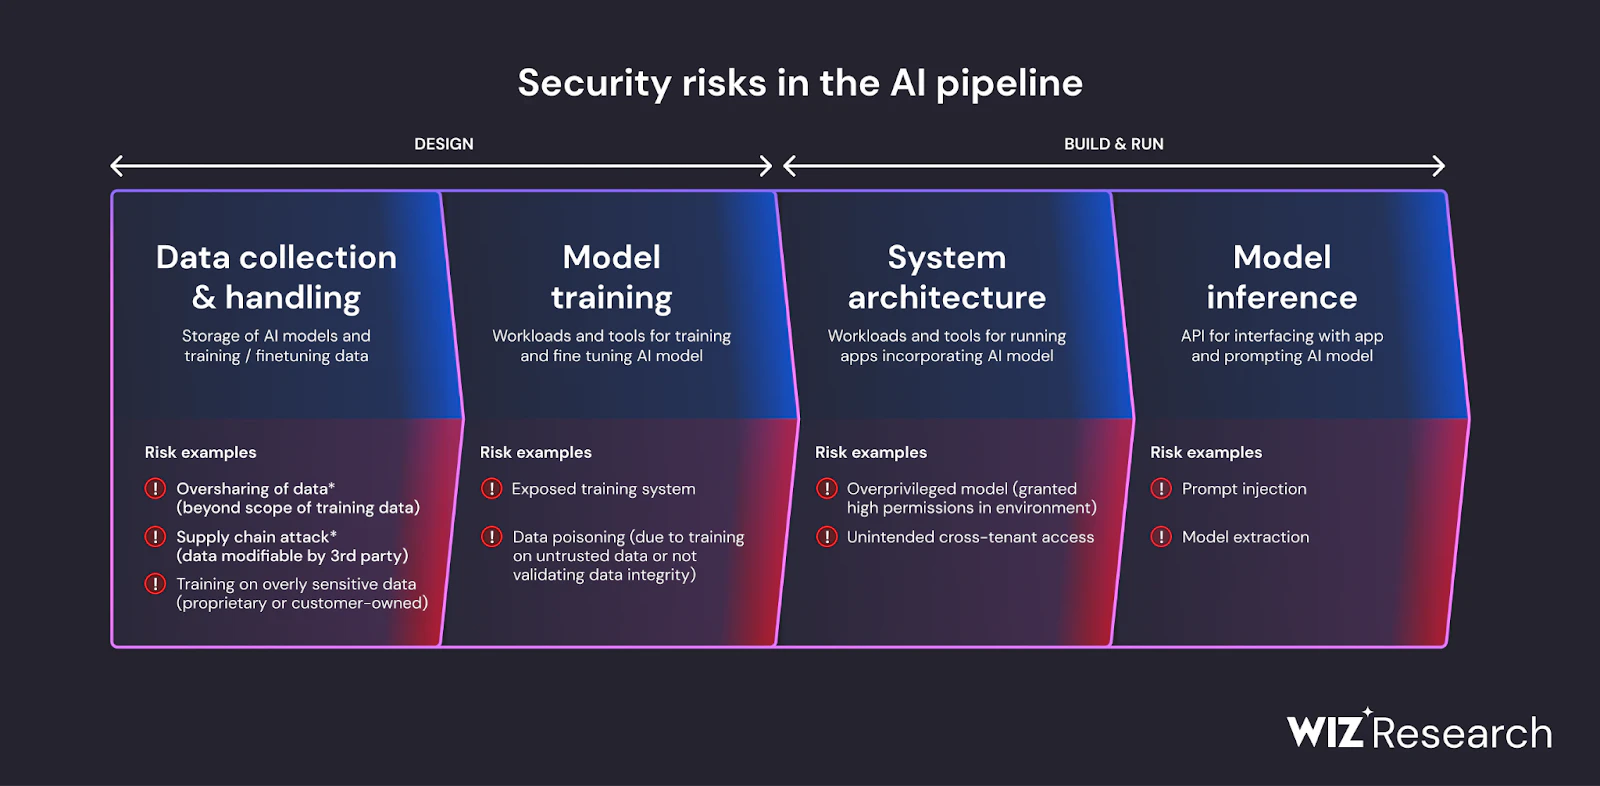
Les attaques d’adversarial AI les plus dangereuses ne provoquent pas d’échecs évidents. Ce sont des manipulations subtiles qui corrompent l’intégrité du modèle dans le temps tout en échappant à la détection. Les attaquants contournent les guardrails sans déclencher d’alertes, ce qui laisse des modèles compromis atteindre la production et y fonctionner sans être détectés.
Pour aider les organisations à comprendre les nuances et les risques de l’adversarial AI, MITRE a publié l’Adversarial Threat Landscape for Artificial Intelligence Systems (ATLAS). MITRE ATLAS est une base de connaissances complète de 155 techniques et de 52 études de cas. Les malicious actors s’en servent pour attaquer les systèmes d’IA. Cette base aide les organisations à se protéger face aux types et tactiques d’adversarial AI.
Quels sont les différents types d’adversarial AI ?
Les attaques d’adversarial AI se classent en deux grandes catégories selon les connaissances de l’attaquant :
Attaques white box : l’attaquant connaît en détail l’architecture, les données d’entraînement et les paramètres du modèle cible. Cet accès de niveau interne permet des attaques très précises. Il exige toutefois une reconnaissance poussée ou un accès d’initié.
Attaques black box : l’attaquant n’a aucune visibilité directe sur l’intérieur du modèle. Il doit déduire les vulnérabilités en observant le comportement en entrée et en sortie. Ces attaques sont plus fréquentes en pratique, car elles exigent seulement un accès API au système cible.
La plupart des incidents d’adversarial AI dans le monde réel sont des attaques black box. Les méthodes des threat actors dépendent de leurs objectifs, du type d’attaque et de l’infrastructure de la victime.
Les défenseurs doivent partir du principe que les attaquants sondent leurs modèles de l’extérieur et concevoir les défenses en conséquence. Il faut se protéger contre des types d’attaque précis qui ciblent différentes étapes du cycle de vie de l’IA :
Attaques d’évasion : les attaquants modifient les entrées pour provoquer une mauvaise classification sans changer le sens du contenu pour un lecteur humain. Les attaques d’évasion sont ciblées, quand l’attaquant veut une sortie erronée précise, ou non ciblées, quand toute mauvaise classification suffit.
Attaques de poisoning : les adversaires injectent des données inexactes et malveillantes dans les datasets d’entraînement, parfois en contrôlant quelques dizaines d’échantillons d’entraînement. Ils affectent le processus d’apprentissage du système et influencent les décisions autonomes et les outputs futurs.
Attaques par transfert : les cybercriminels conçoivent des modèles d’adversarial AI pour une victime donnée. Ils utilisent ensuite ce modèle pour compromettre les systèmes d’IA et de ML d’autres cibles.
Attaques d’extraction de modèle : les threat actors volent des algorithmes de machine learning propriétaires afin de créer rapidement et à moindre coût leurs propres copies illégales.
Attaques byzantines : les threat actors paralysent un système de ML distribué en alimentant modèles et composants avec des données et des entrées manipulées et contradictoires.
Attaques d’IA trojan : les malicious actors insèrent un déclencheur dans le modèle d’IA ou de ML pendant la phase d’entraînement. Le modèle fonctionne ensuite normalement la plupart du temps et ne déclenche pleinement l’attaque que lorsque le signal apparaît.
Attaques d’inversion de modèle : les threat actors analysent les outputs d’un modèle d’IA/ML pour déduire des détails de ses données d’entraînement. Cela arrive surtout quand ils n’ont pas accès aux datasets d’entraînement.
Attaques d’inférence d’appartenance : les threat actors étudient les modèles d’IA et de ML. Ils déterminent si des informations sensibles exploitables sur des personnes ou des institutions figurent dans les données d’entraînement.
Comment fonctionnent les attaques d’adversarial AI ?
Contrairement à de nombreuses cybermenaces traditionnelles qui cherchent à contourner les capacités de leur cible, les attaques d’adversarial AI exploitent les capacités intrinsèques de l’IA. Les systèmes d’IA prennent des décisions autonomes et génèrent des outputs à partir des données d’entraînement et des prompts. C’est précisément ce que ces attaques exploitent.
Les attaques d’adversarial AI suivent en général une progression structurée :
Reconnaissance : les attaquants étudient les systèmes d’IA cibles. Ils repèrent les faiblesses des architectures de modèles, des guardrails et de l’infrastructure sous-jacente. Les techniques vont de la recherche publique à l’ingénierie inverse du comportement du modèle via le probing des API.
Conception d’entrées : forts de la connaissance du système cible, les attaquants conçoivent des entrées malveillantes adaptées à des vulnérabilités précises. Ces entrées ciblent des systèmes où la précision est critique, comme la détection de fraude, la reconnaissance d’images ou le traitement du langage naturel.
Exploitation : les attaquants délivrent les entrées conçues pour corrompre le comportement du modèle. L’impact va d’une manipulation subtile des outputs qui passe inaperçue à des pannes à grande échelle qui nuisent aux opérations métier et à la réputation.
Escalade : pendant que les défenseurs tentent de comprendre ce qui s’est mal passé, les attaquants profitent de la confusion. Ils se déplacent latéralement, exploitent d’autres vulnérabilités ou diffusent de la désinformation générée par l’IA.
Rappelez-vous que les attaques d’adversarial AI affectent l’ensemble du parcours des modèles d’IA et de ML, du développement au déploiement.
Le guide pratique des responsables sécurité
Obtenez des conseils concrets pour aligner stratégie, équipes et priorités autour d’une sécurité cloud efficace.

Exemples concrets d’adversarial AI
Maintenant que les types d’attaques d’adversarial AI sont clarifiés, examinons quelques exemples concrets.
1. MadRadar
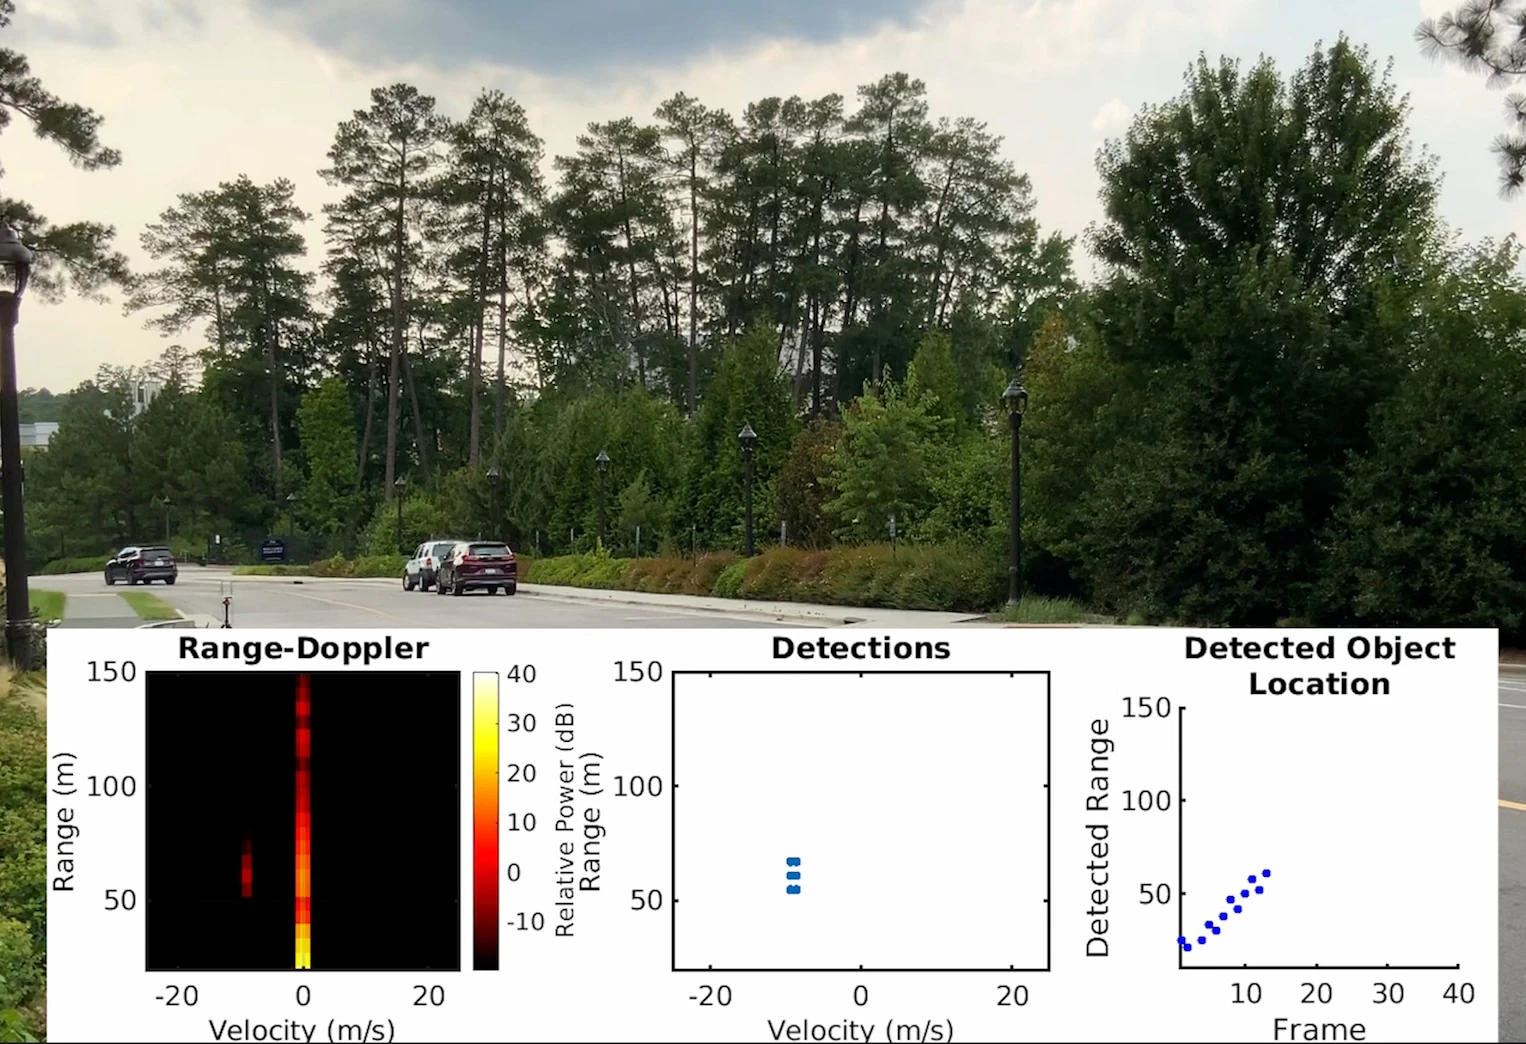
Des ingénieurs de Duke University ont piraté les systèmes radar de véhicules autonomes et les ont fait halluciner d’autres voitures. Un scénario où des pirates font percevoir aux véhicules des voitures fantômes peut provoquer des accidents majeurs.
2. Search Generative Experience de Google
Même si les raisons exactes de ses outputs malveillants restent floues, le nouveau moteur de recherche IA de Google redirige parfois les utilisateurs vers des liens malveillants contenant des malwares. Cela suggère une forme d’adversarial AI. Le point le plus préoccupant est le caractère réaliste et crédible du moteur lorsqu’il présente des informations dangereuses.
3. EchoLeak de Microsoft 365 Copilot
Aim Labs a trouvé une vulnérabilité dans Microsoft 365 Copilot, baptisée EchoLeak, qui contournait les mesures de sécurité prévues contre les attaques de prompt injection. Avec cette faille, les attaquants accédaient à des données sensibles à partir d’un seul e-mail. Cela expose des vulnérabilités potentielles dans les agents d’IA et les copilotes.
Bonnes pratiques pour atténuer l’adversarial AI
Se défendre contre l’adversarial AI exige des contrôles en couches et des méthodes d’atténuation des conséquences sur tout le cycle de vie du modèle, de l’intégrité des données d’entraînement à la surveillance à l’exécution.
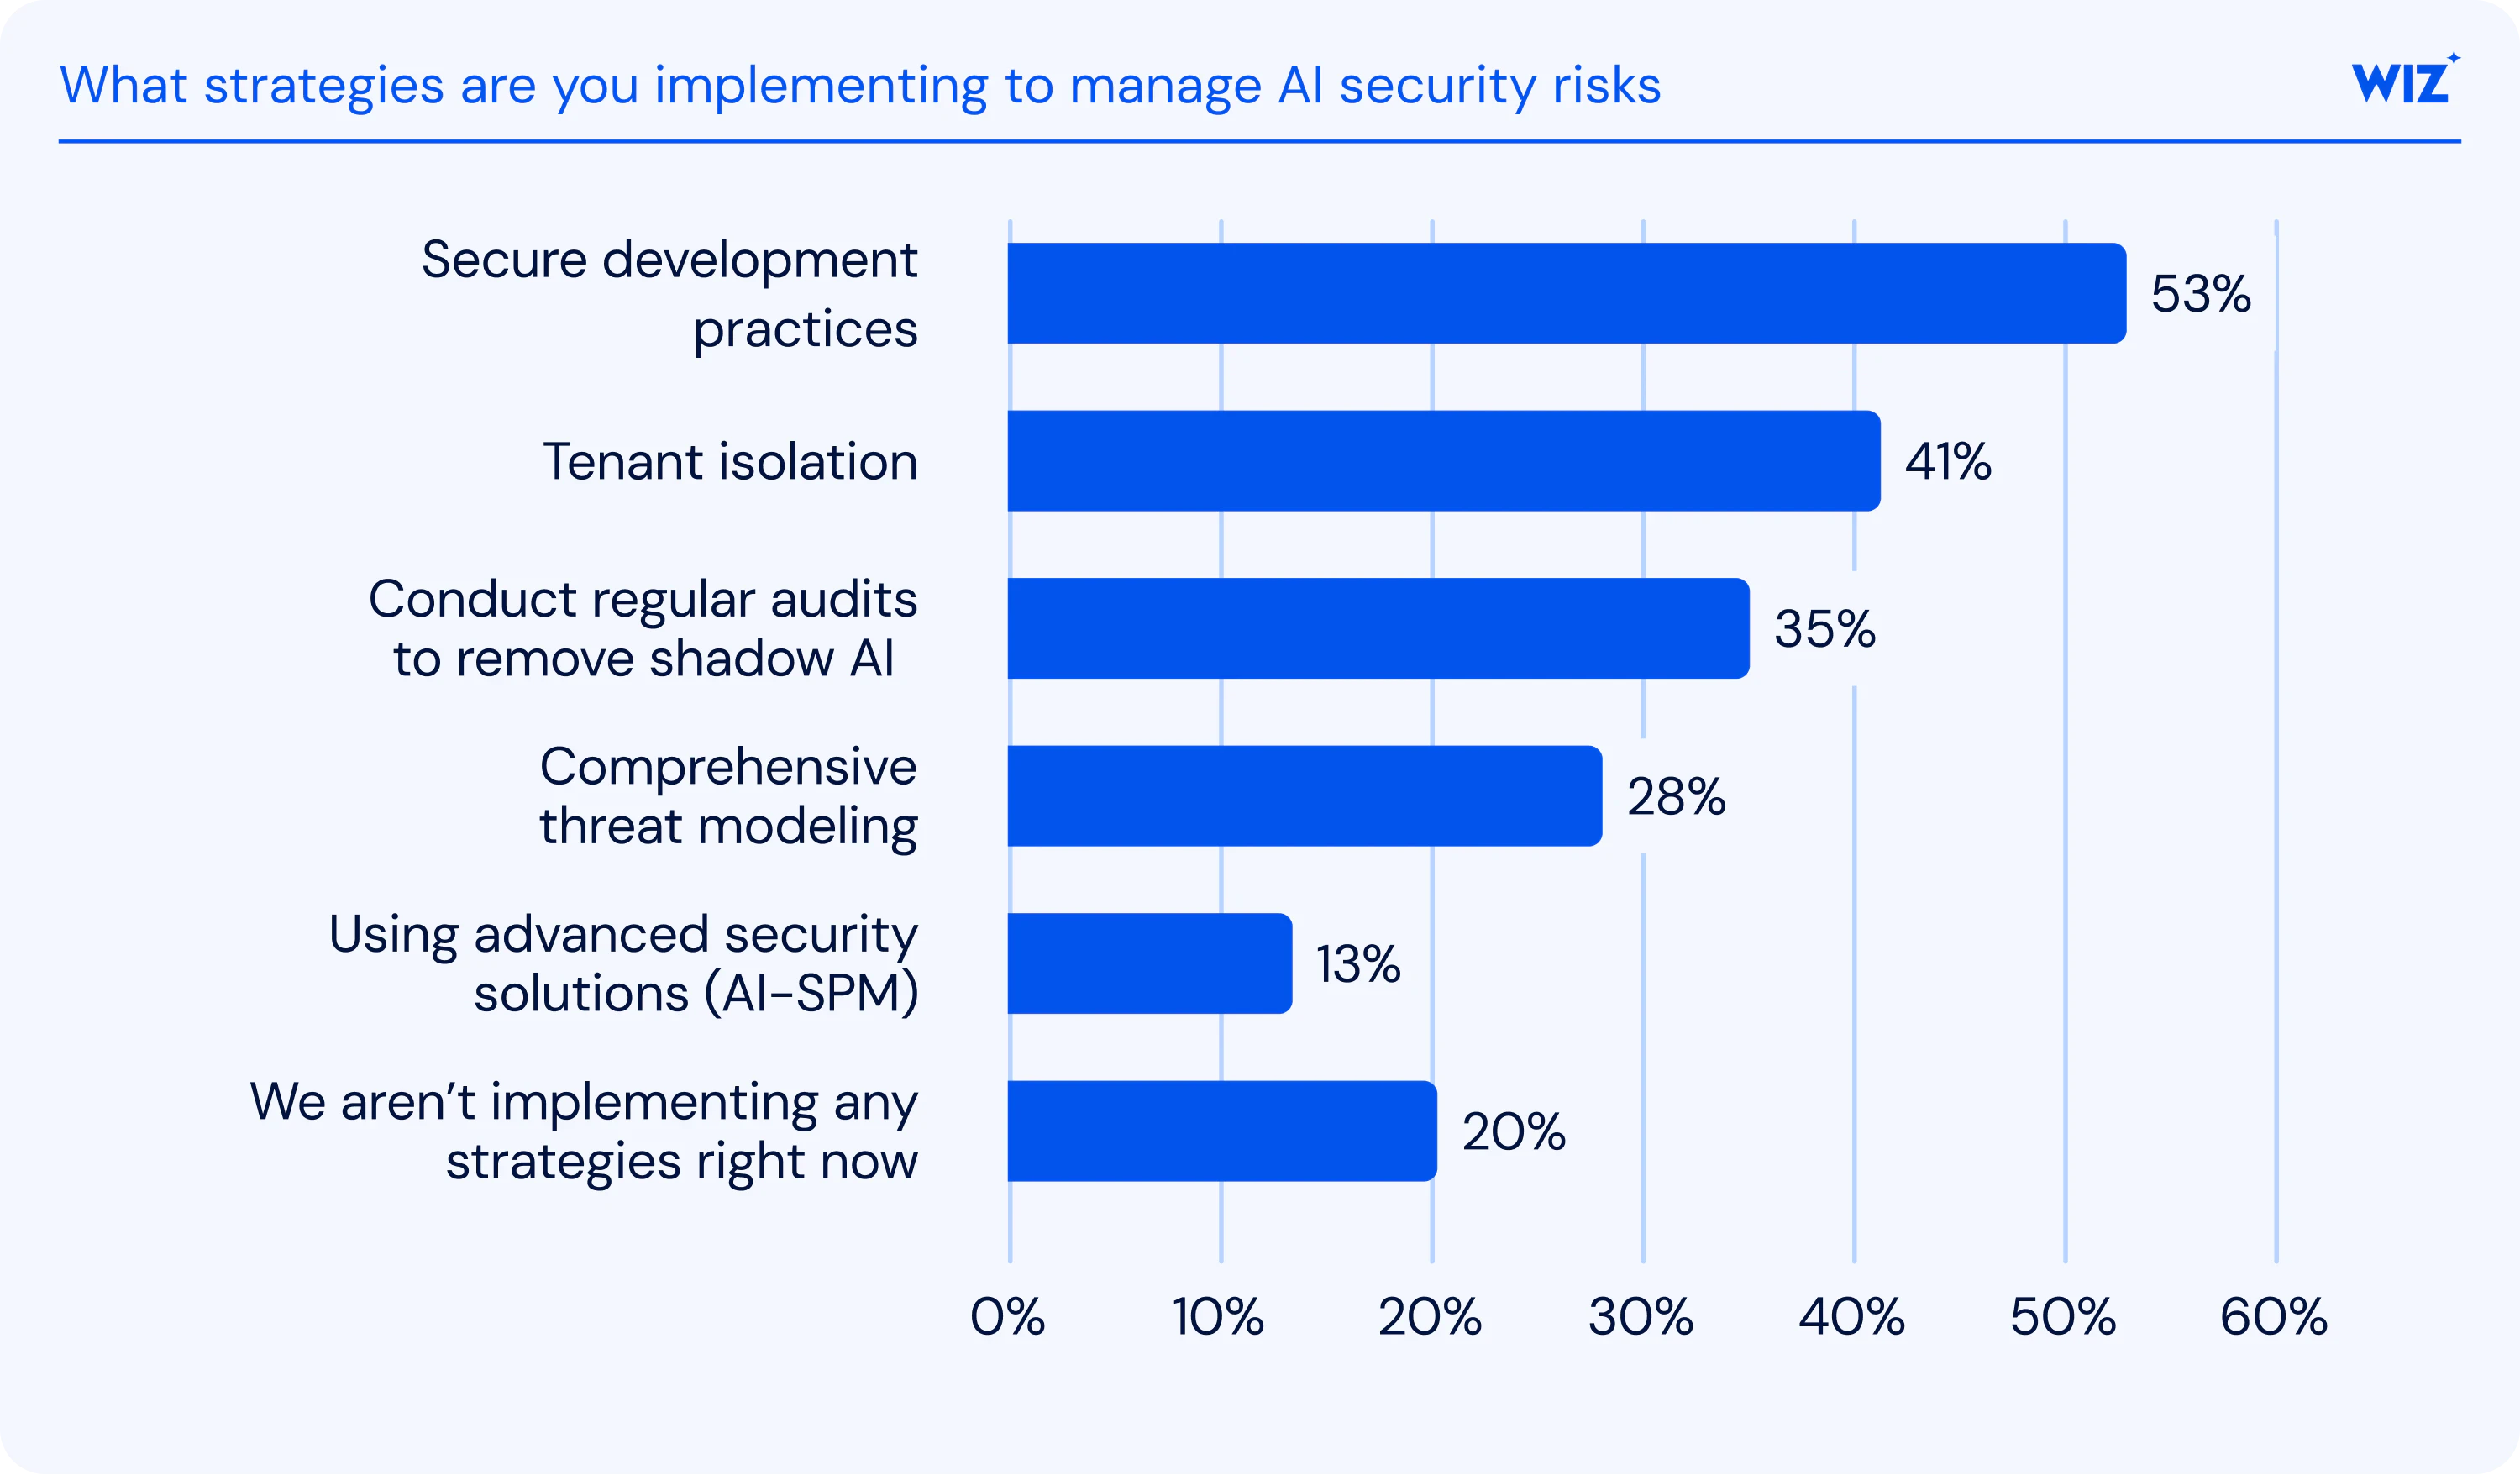
Pour une configuration plus sûre, suivez ces bonnes pratiques :
Surveillance et détection 24 h/24 et 7 j/7
Les systèmes d’IA exigent une surveillance continue qui s’appuie sur l’infrastructure traditionnelle. Elle suit les schémas d’entrée des modèles pour repérer les anomalies. Elle surveille aussi la distribution des outputs pour détecter la dérive et corrèle le comportement de l’IA avec les journaux d’activité cloud.
Quand la surveillance révèle des schémas suspects, les équipes de sécurité ont besoin du contexte pour enquêter rapidement. Il peut s’agir de volumes de requêtes inhabituels ou d’outputs qui s’écartent des modèles de référence. Cela implique de relier la télémétrie d’IA à l’infrastructure cloud sous-jacente où s’exécutent les modèles.
Mettre en place un entraînement adversarial
L’entraînement adversarial expose les modèles à des attaques potentielles pendant le processus d’entraînement, pour qu’ils apprennent à reconnaître la manipulation et à y résister. Il consiste souvent à générer des entrées adversariales avec des techniques connues, à les ajouter aux datasets d’entraînement, puis à réentraîner le modèle sur ces données enrichies.
Toutefois, les modèles entraînés ainsi montrent parfois une précision légèrement réduite sur des entrées normales. L’entraînement adversarial ne protège que contre les types d’attaque auxquels le modèle a été exposé. Les données d’entraînement doivent donc être mises à jour en continu.
Renforcer les environnements de développement d’IA et de ML
En consolidant les composants critiques des environnements de développement d’IA/ML, les entreprises renforcent leur posture globale de sécurité de l’IA. Parmi les pratiques essentielles figurent l’assainissement des données d’entraînement et le recours à des algorithmes de ML plus robustes (comme les algorithmes résistants aux attaques byzantines). L’IA sert aussi à écrire ou valider des algorithmes de ML afin de réduire l’erreur humaine. Enfin, intégrez la sécurité dans les pipelines d’IA le plus tôt possible.
Optimiser les architectures des services d’IA/GenAI
Les entreprises doivent choisir avec soin le modèle d’architecture tenant utilisé pour les services intégrant la GenAI. Les trois types fondamentaux sont multi-tenant, single-tenant et hybrides.
Les entreprises répartissent certains composants de leurs services GenAI sur plusieurs tenants et en placent d’autres sur des tenants dédiés. C’est un levier critique pour limiter les dommages à grande échelle et accélérer la réponse aux incidents.
Prétraitement des entrées
Appliquez des techniques de prétraitement aux entrées avant de les injecter dans le modèle. Cela aide à détecter et à atténuer les perturbations adversariales. Le feature squeezing réduit la précision des caractéristiques d’entrée pour retirer le bruit adversarial. La transformation d’entrée applique un redimensionnement aléatoire, un padding ou d’autres transformations pour perturber des entrées adversariales soigneusement conçues. La détection d’anomalies s’appuie sur des méthodes statistiques pour identifier les entrées qui s’écartent nettement des schémas attendus.
Mettre en place l’AI security posture management (AI-SPM)
Pour protéger votre entreprise des attaques d’adversarial AI, choisissez un outil unifié de sécurité cloud qui place l’AI-SPM au centre de ses capacités.
Le rapport AI Security Readiness de Wiz a montré que seules 13 % des organisations ont adopté des solutions AI-SPM, alors que 87 % utilisent activement des services d’IA. Avec un outil AI-SPM robuste, les attaques d’adversarial AI ont peu ou pas d’effet sur l’adoption et la mise en œuvre de l’IA dans votre entreprise.
Comment Wiz aide à traiter la menace de l’adversarial AI
Les risques d’adversarial AI n’existent pas de façon isolée. Ils naissent d’une combinaison de vulnérabilités de modèles, d’erreurs de configuration cloud et d’identités sur-autorisées. Vous vous défendez contre ces attaques grâce à une visibilité qui relie les actifs d’IA à l’infrastructure qui les alimente.
Wiz AI-APP fournit cette vue unifiée. Elle aide les équipes à détecter et à atténuer les risques d’adversarial AI avant qu’ils n’atteignent la production.
Visibilité complète
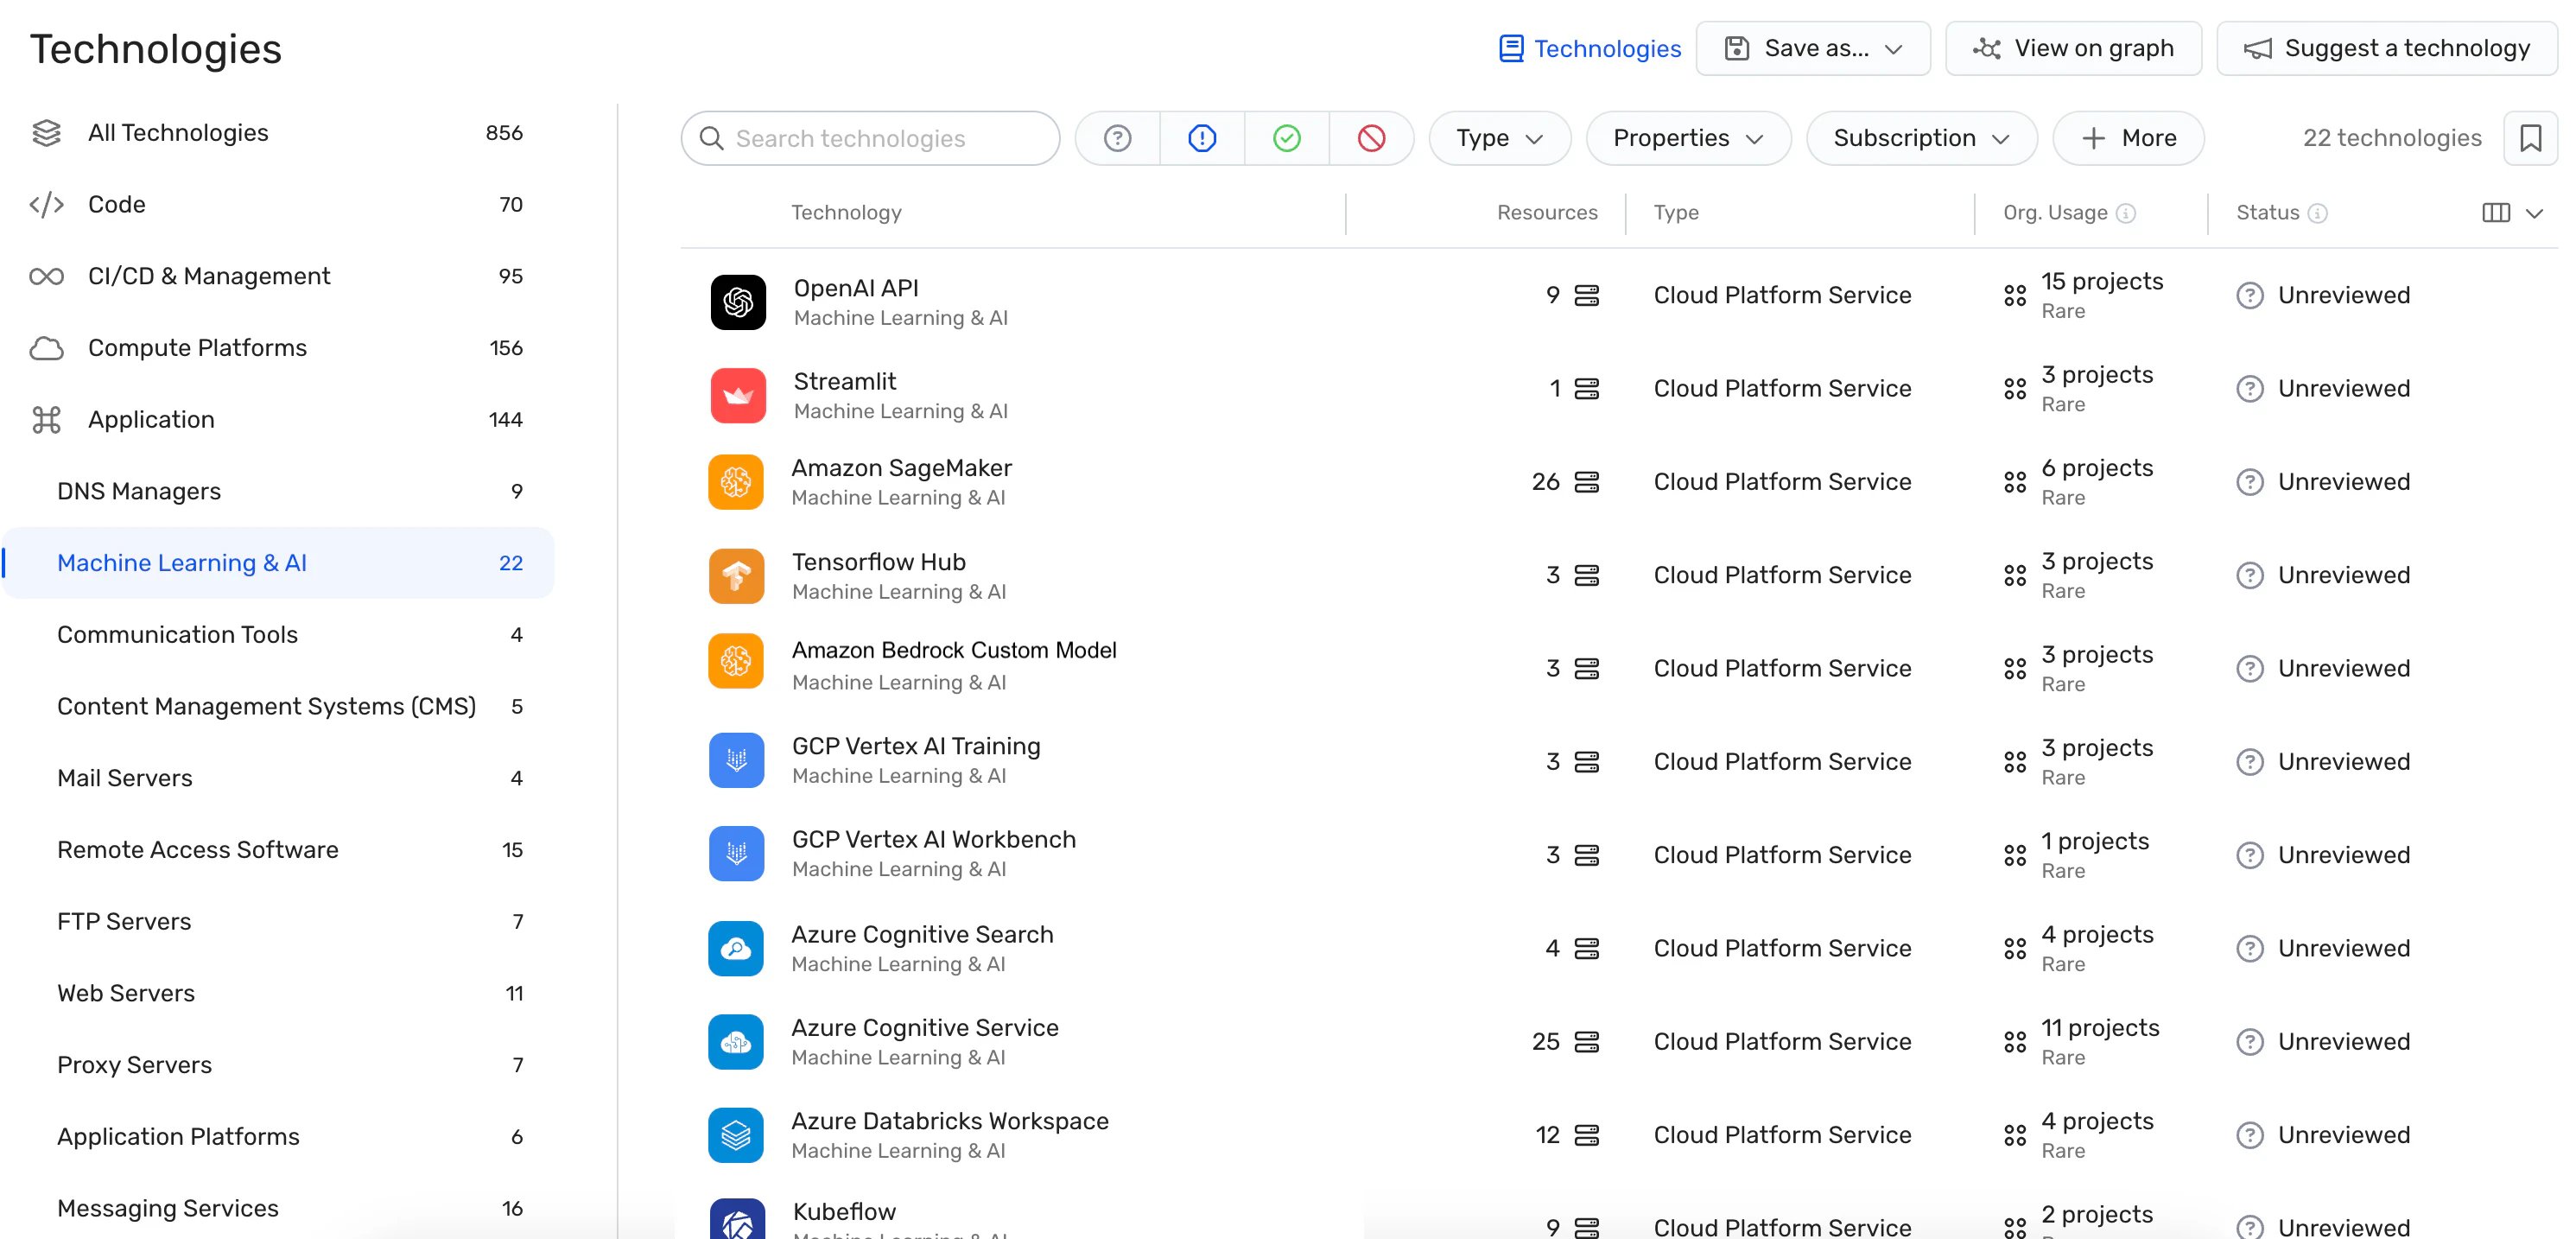
Wiz AI-APP offre une visibilité full-stack sur les pipelines et les ressources d’IA grâce à ses capacités agentless d’AI-BOM (Bill of Materials). Vous voyez ainsi tous les services d’IA, technologies et SDK utilisés dans votre environnement. Vous détectez les projets de shadow AI introduits sans supervision adéquate. Vous obtenez aussi une vision d’ensemble de la surface d’attaque de l’IA.
Détection des erreurs de configuration
Wiz applique les bonnes pratiques de sécurité de l’IA en détectant les erreurs de configuration dans des services d’IA comme OpenAI et Amazon Bedrock. L’outil s’appuie sur des règles intégrées et étend les contrôles de sécurité au pipeline de développement via le scanning Infrastructure-as-Code (IaC).
Attack path analysis
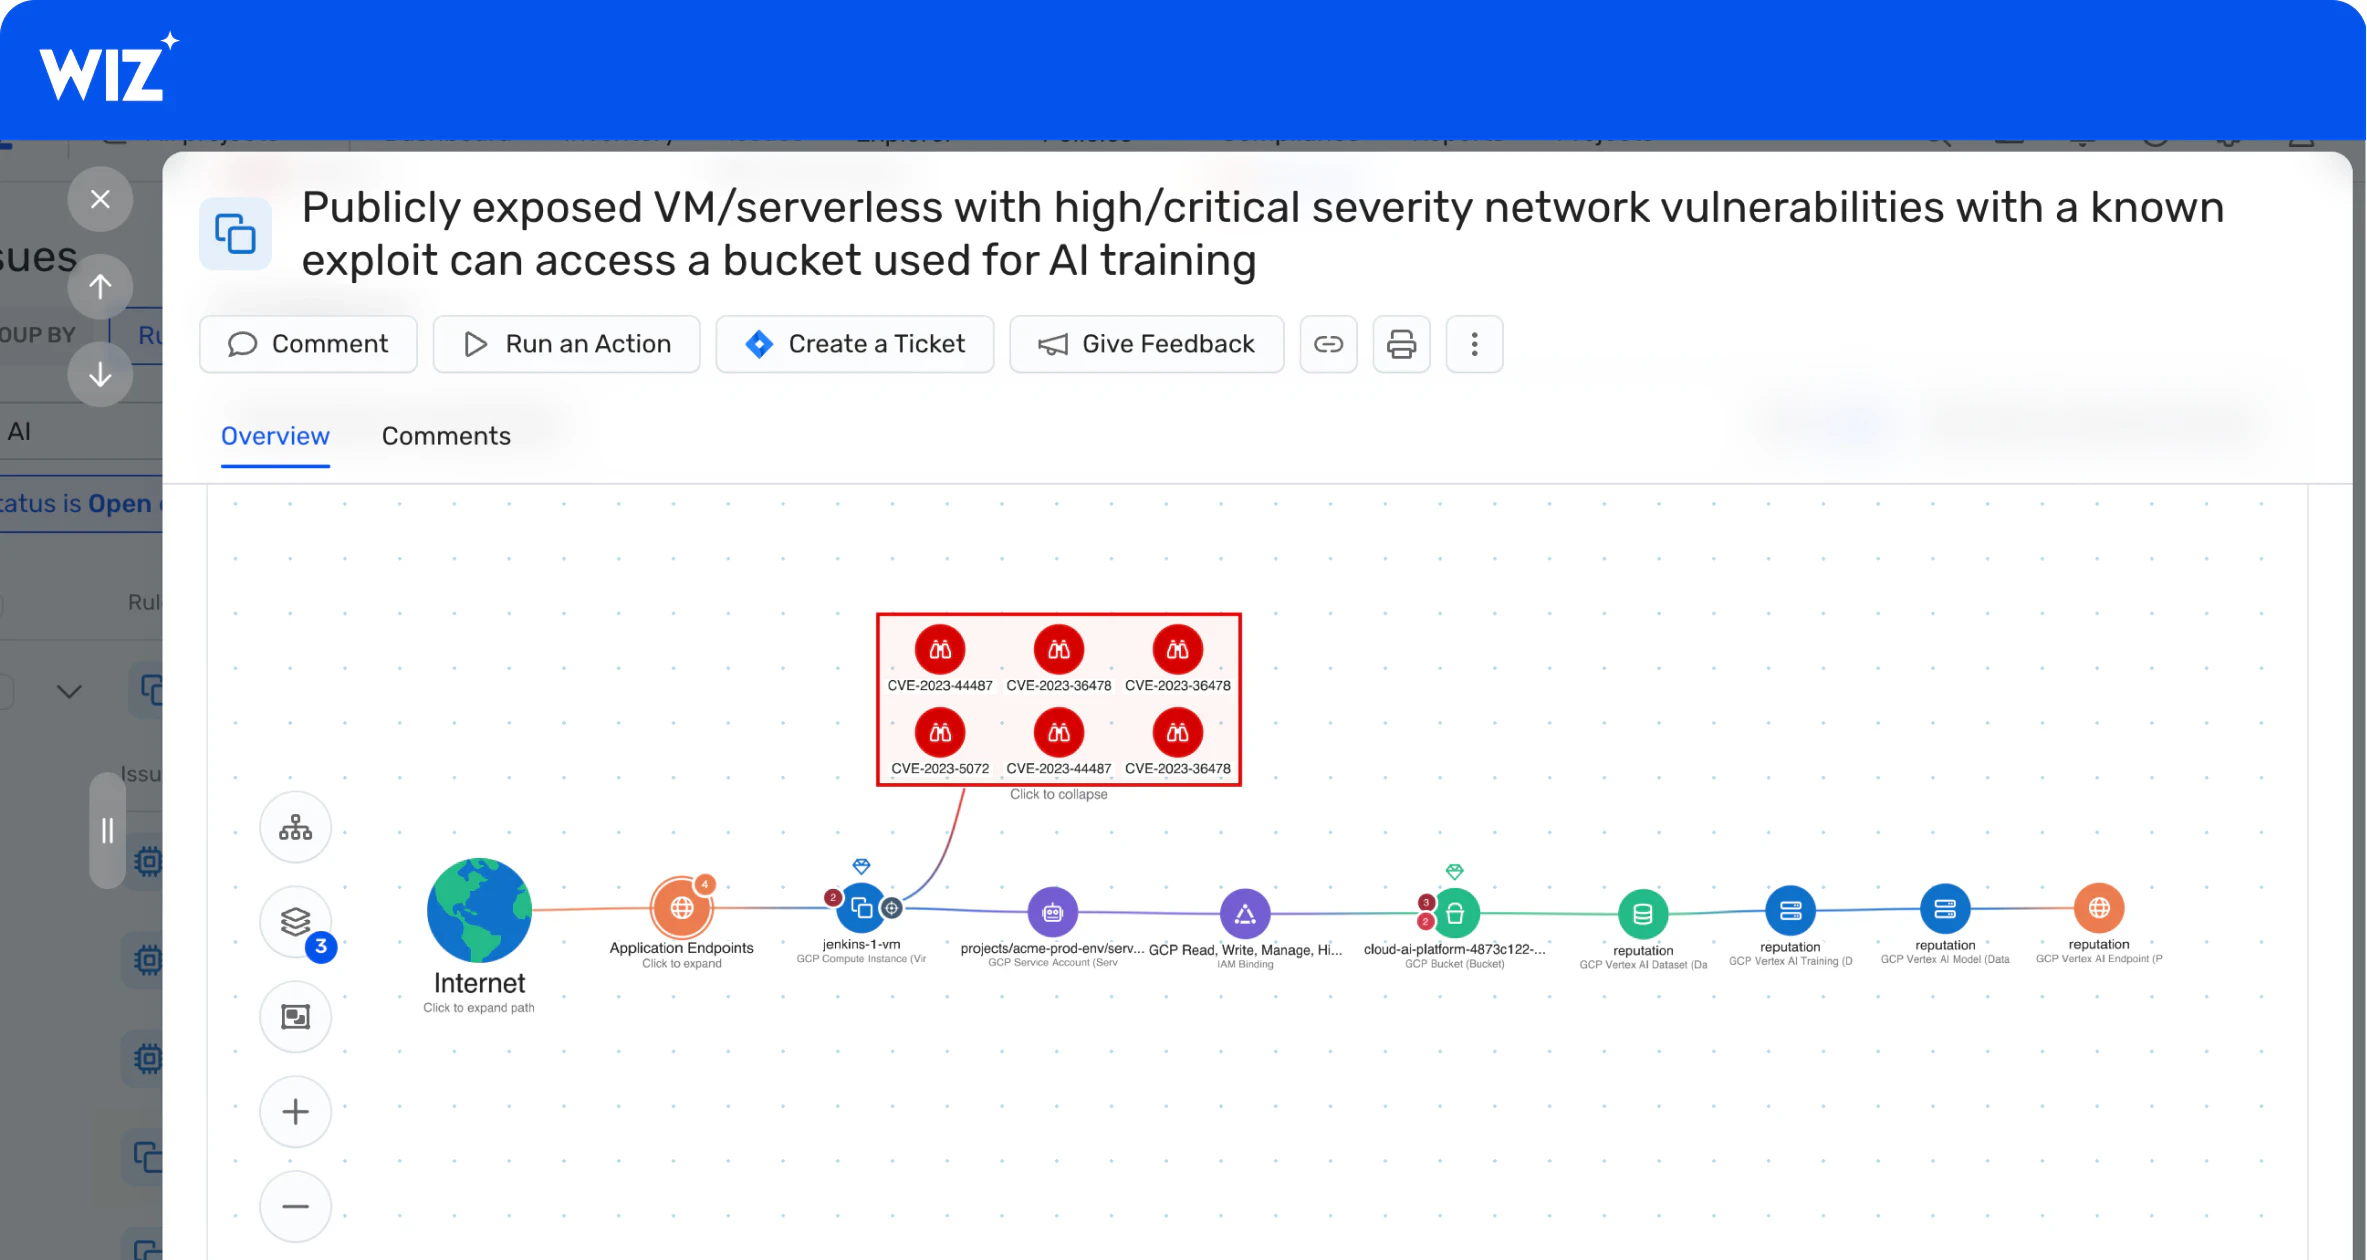
Wiz AI-APP étend l’attack path analysis aux ressources d’IA. Les organisations détectent ainsi les chemins d’attaque potentiels vers les modèles et services d’IA. Elles évaluent les risques liés aux vulnérabilités, aux identités, aux expositions réseau et aux accès aux données. Elles suppriment ensuite de façon proactive les chemins d’attaque d’IA critiques avant exploitation.
Sécurité des données pour l’IA
Pour se protéger contre le data poisoning et d’autres attaques adversariales sur les données d’entraînement, Wiz offre plusieurs capacités. Vous bénéficiez de la détection automatique des données d’entraînement d’IA sensibles. Vous disposez aussi de contrôles Data Security Posture Management (DSPM) prêts à l’emploi pour l’IA, ainsi que de conseils de remédiation pour les risques de fuite de données.
Découvrez comment Wiz cartographie les chemins d’attaque d’adversarial AI dans votre environnement cloud. Demandez une démo pour voir AI-APP en action.
Explorez comment Wiz cartographie les chemins d’attaque d’adversarial AI dans votre environnement cloud avec Voir Wiz en action.
Découvrez Wiz en action
Voyez comment Wiz aide vos équipes à détecter, prioriser et corriger rapidement les risques dans le cloud.

Rapport d’évaluation de la posture de sécurité de l’IA
Télécharger
[CTA-END]