
Qu’est-ce que l’IA d’entreprise ?
L’IA d’entreprise désigne l’usage des technologies d’IA dans toute l’organisation. Elle automatise des tâches, soutient de meilleures décisions et produit des résultats business mesurables. Ce n’est pas un outil unique, mais un ensemble de capacités intégrées aux systèmes déjà utilisés par les employés et les clients.
En pratique, l’IA se branche sur les plateformes métier clés. Cela inclut l’enterprise resource planning (ERP), le customer relationship management (CRM), les systèmes RH et les outils de supply chain. Au lieu d’une « app d’IA » à part, l’intelligence s’injecte dans les workflows existants. Les utilisateurs reçoivent recommandations, prédictions et automatisation dans leurs outils habituels.
Les systèmes d’IA d’entreprise s’intègrent aux plateformes métier centrales et traitent des données sensibles. La sécurité de l’IA devient alors une exigence de fond. Sécuriser l’IA d’entreprise, c’est protéger non seulement les modèles, mais aussi les data pipelines, les identités et l’infrastructure cloud dont dépendent ces systèmes.
Plusieurs technologies de base composent l’IA d’entreprise moderne :
Machine learning (ML) : Détecte des schémas dans les données historiques pour prédire la demande, le churn ou la fraude.
Natural language processing (NLP) : Comprend et génère le langage humain pour l’analyse de documents, les chatbots et l’analyse de sentiment.
Computer vision : Interprète images et vidéos pour des cas d’usage comme le contrôle qualité ou la vérification d’identité.
IA générative et large language models (LLMs) : Créent du contenu, écrivent du code, résument des documents et agissent comme « copilotes » pour les employés.
L’IA d’entreprise opère aussi à une échelle bien plus large que les projets latéraux typiques. Les modèles servent des milliers d’utilisateurs et traitent des millions d’événements par jour. Ils s’exécutent sur plusieurs régions et clouds. Pour cette raison, ils se conçoivent et se gèrent avec une forte fiabilité et une sécurité solide. Ils intègrent aussi des contrôles réglementaires et des politiques claires de résidence des données. S’y ajoutent des garde-fous de confidentialité et des frontières de responsabilité partagée. Ces frontières se définissent avec les fournisseurs d’IA cloud (AWS Bedrock, Azure OpenAI Service, Google Vertex AI).
Renforcez vos pratiques CloudSec
Téléchargez des recommandations avancées pour réduire les risques et mieux protéger vos environnements cloud.

Comment l’IA d’entreprise se manifeste dans l’organisation
L’IA d’entreprise se comprend le plus simplement en observant où elle apparaît dans le travail quotidien. La plupart des équipes rencontrent l’IA via les applications qu’elles utilisent déjà, plutôt que via un écran séparé de « plateforme d’IA ».
Les opérations et l’automatisation des processus s’appuient sur l’IA pour lire des documents, les classer et les acheminer sans intervention humaine. Par exemple, le traitement intelligent de documents extrait des données de factures ou de contrats, les valide et les pousse dans les systèmes back-office.
Les équipes commerciales et marketing utilisent des solutions d’IA d’entreprise pour qualifier les leads, segmenter les clients et personnaliser les offres. Les modèles apprennent quelles actions et quels messages mènent à des affaires conclues ou à un engagement plus élevé. Ils suggèrent ensuite les meilleures prochaines actions aux commerciaux.
Les équipes support client voient l’IA dans des chatbots qui traitent les questions courantes. Un routage intelligent envoie aussi les tickets à la bonne équipe. Cela réduit le temps de traitement et fait remonter les cas qui nécessitent vraiment un expert humain.
Les fonctions finance et risque utilisent le machine learning d’entreprise pour détecter la fraude, évaluer le risque de crédit et suivre la conformité réglementaire. Les modèles cherchent des schémas inhabituels dans les transactions et alertent les équipes lorsqu’un écart sort de la politique.
Les équipes engineering et IT bénéficient de copilotes d’IA qui aident à la génération de code, à la création de tests et à l’automatisation d’infrastructure. La recherche montre que ces outils offrent une réduction de 31,8 % du cycle de revue de PR. Cela accélère directement la livraison logicielle. L’IA propose des changements de configuration et aide à diagnostiquer des incidents en résumant les logs et en suggérant les causes racines probables.
La fabrication et la logistique s’appuient sur la computer vision et les modèles de séries temporelles pour la maintenance prédictive et le contrôle qualité. Ces applications impactent directement la disponibilité, le coût et la sécurité.
La gestion des connaissances se transforme avec la recherche d’entreprise basée sur les LLMs, le résumé de documents et les assistants Q&A internes. Au lieu de fouiller wikis et PDF, les employés posent des questions et obtiennent des réponses contextualisées ancrées dans le contenu de l’entreprise.
Dans tous ces cas d’usage, l’IA travaille avec des données sensibles, de la logique métier centrale et une infrastructure critique. C’est pourquoi la gouvernance, l’architecture et la sécurité font partie de la conception dès le départ, pas en rattrapage ultérieur.
Ce qui distingue l’IA d’entreprise d’un usage d’IA à plus petite échelle
L’IA d’entreprise se distingue des petites expérimentations ou des outils grand public. Elle s’ancre plus profondément dans l’organisation, et l’impact est plus large lorsqu’un problème survient.
Au niveau entreprise, les systèmes d’IA opèrent à grande échelle. Les modèles s’entraînent parfois sur des années de données historiques. Ils servent des prédictions ou des recommandations à des milliers d’utilisateurs à la fois. Ces workloads tournent souvent en continu et soutiennent des fonctions métier centrales plutôt que des cas d’usage isolés.
L’IA d’entreprise s’appuie aussi sur des plateformes et une infrastructure partagées. Les modèles reposent souvent sur des data lakes centralisés, des clusters GPU partagés et des systèmes de messagerie communs. Cela améliore l’efficacité, mais augmente aussi le risque. Une seule erreur de configuration dans un service partagé touche plusieurs équipes et unités métier en même temps.
Les déploiements sont en général distribués sur plusieurs régions et clouds. La même plateforme d’IA soutient la finance en Europe, le marketing en Amérique du Nord et les opérations en Asie. Chaque région a des exigences réglementaires et de résidence des données différentes. Les contrôles de sécurité et la gouvernance intègrent cette complexité dès le départ.
Contrairement aux preuves de concept de courte durée, les systèmes d’IA d’entreprise sont des services de production durables. Ils requièrent versioning, monitoring et processus d’incident response semblables à ceux d’autres infrastructures critiques. Avec le temps, ces systèmes accumulent des dependencies sur les data pipelines, les identités et les applications en aval. Leur blast radius potentiel s’élargit.
Enfin, l’IA d’entreprise traite régulièrement des données à forte valeur et réglementées, y compris des dossiers clients, des informations financières et de la propriété intellectuelle. Un seul endpoint de modèle exposé ou un compte de service trop permissif impacte plusieurs systèmes et utilisateurs à la fois. C’est pourquoi l’IA d’entreprise exige une propriété claire et une responsabilisation nette. Sa gouvernance va bien au-delà de ce qu’exige un usage d’IA à plus petite échelle.
Implications de sécurité et de gouvernance de l’IA d’entreprise
Lorsque l’IA s’intègre aux workflows métier centraux, les risques de sécurité dépassent les modèles individuels. Les systèmes d’IA d’entreprise héritent des accès, des privilèges et de la confiance des plateformes auxquelles ils s’intègrent. Les défaillances ont un impact à l’échelle de l’organisation.
Risques d’accès et d’exposition des données
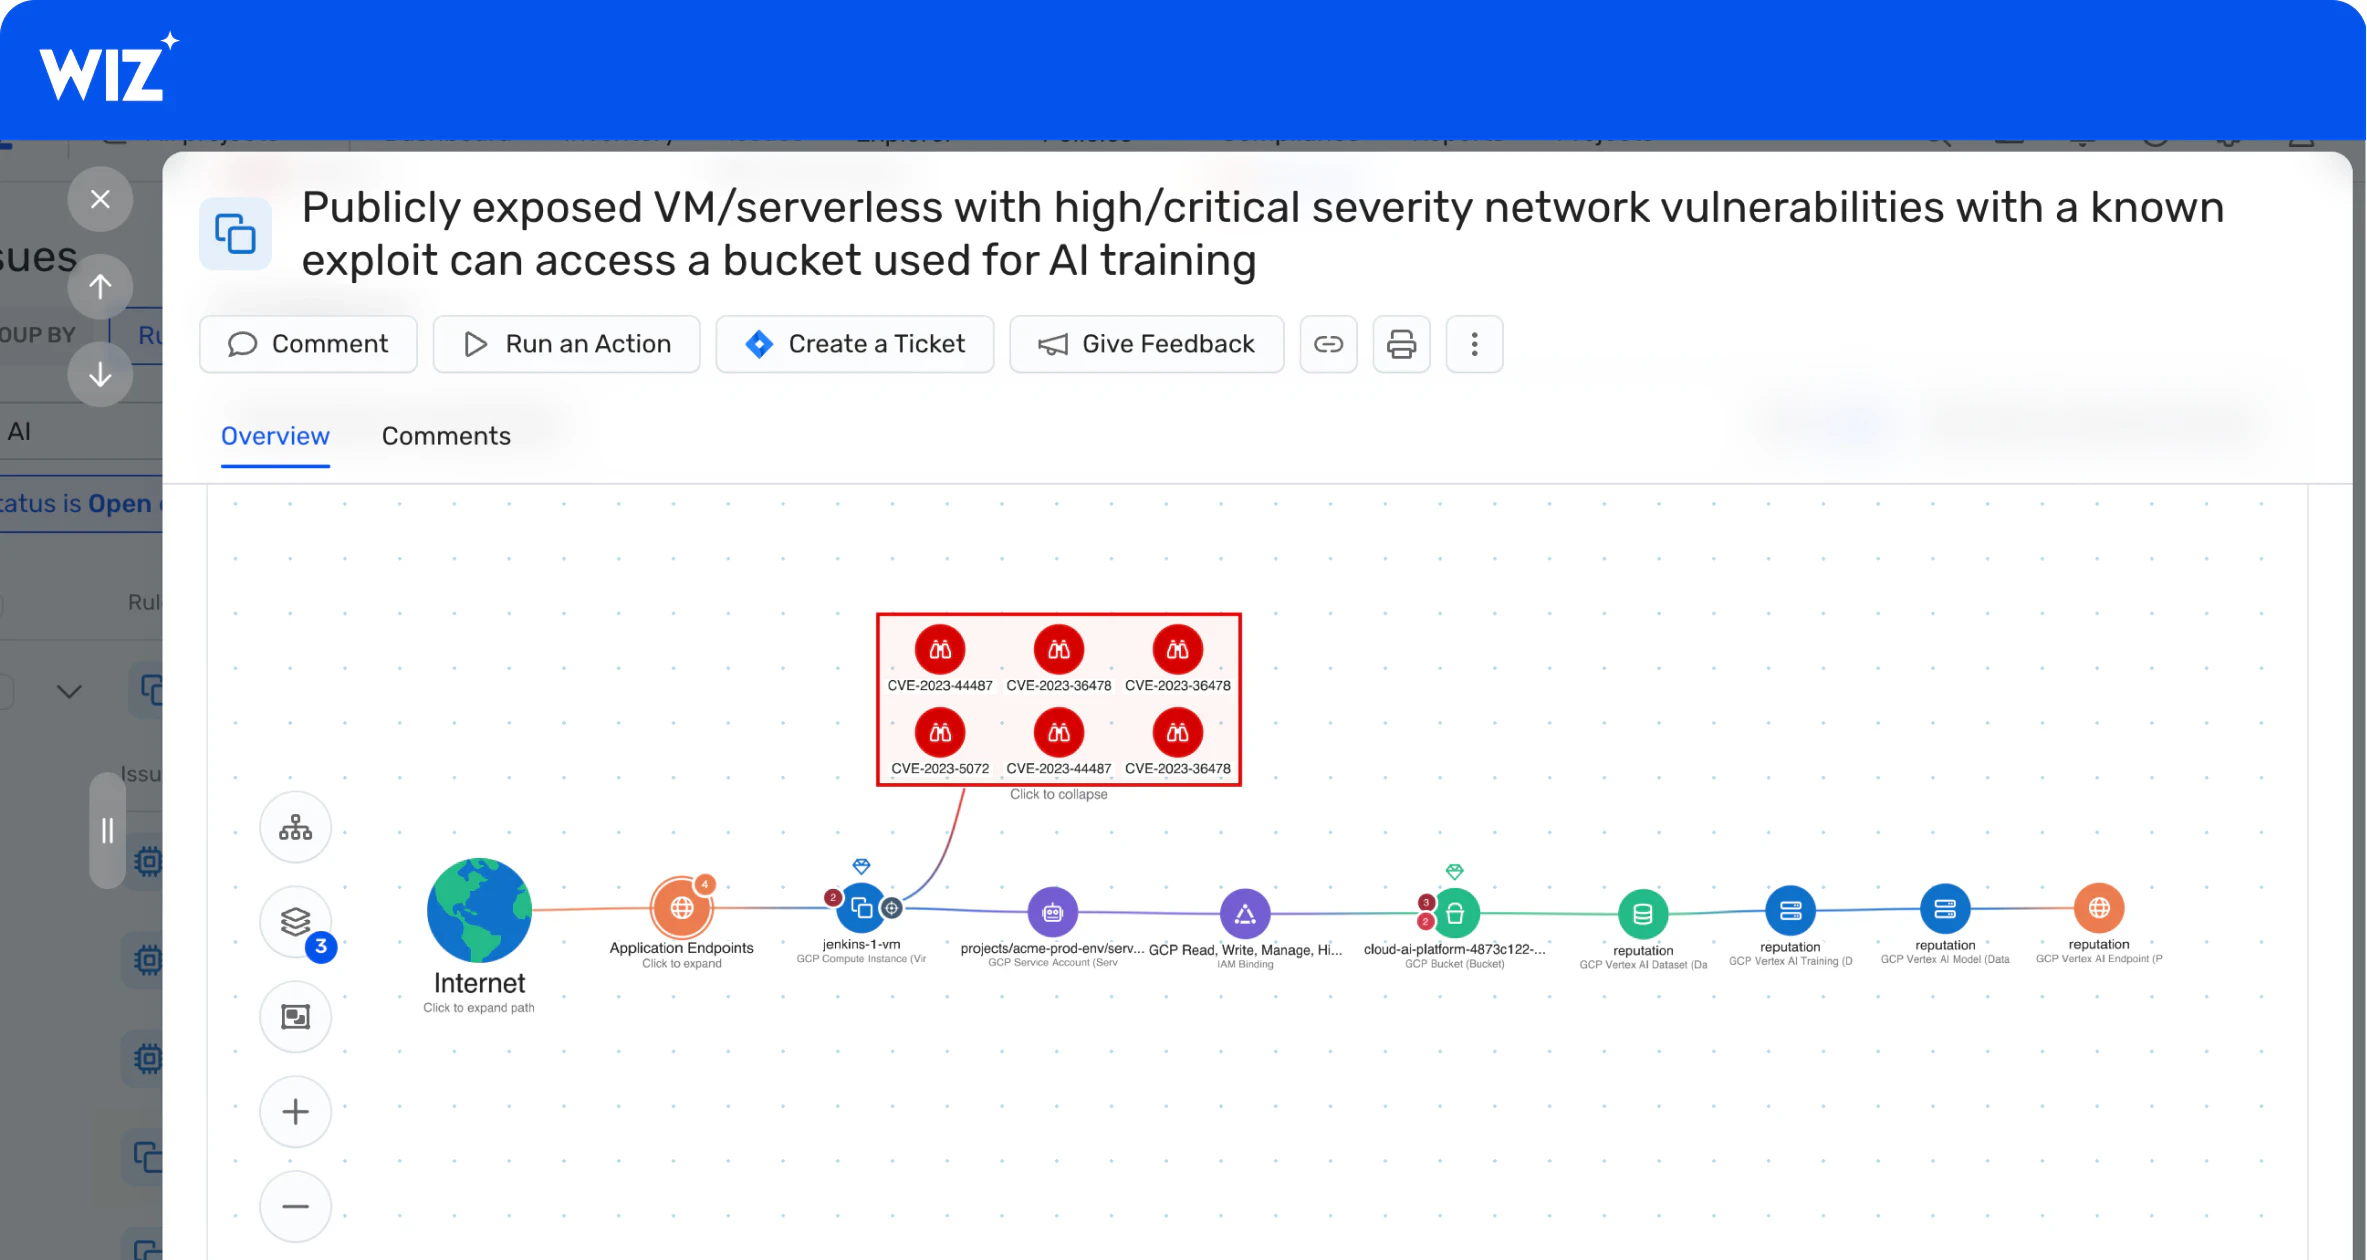
Les systèmes d’IA d’entreprise interagissent régulièrement avec des données métier sensibles. Cela inclut des dossiers clients, des informations financières et de la propriété intellectuelle. Les datasets d’entraînement, les feature stores, les prompts et les sources de retrieval introduisent des points d’exposition potentiels. Sans gouvernance des données solide, des informations sensibles fuient. Les causes incluent les erreurs de configuration, les accès trop larges ou les outputs de modèles imprévus.
Pour gérer ce risque, vous avez besoin de visibilité. Suivez la circulation des données dans les pipelines d’IA et les identités autorisées à y accéder.
Gestion des identités et des permissions
Les workflows d’IA s’appuient sur des comptes de service, des clés API et des identités managées. Ils récupèrent des données et appellent des services en aval. Lorsque ces identités sont trop permissives, elles ouvrent des opportunités de lateral movement dans les environnements cloud. Dans les grandes entreprises, une seule identité de service d’IA mal configurée expose plusieurs systèmes et datasets.
L’accès selon le principe du moindre privilège (PoLP) et la revue continue des permissions vous aident à limiter le blast radius.
Schémas d’attaque spécifiques à l’IA
L’IA d’entreprise introduit des défis de sécurité que les contrôles applicatifs traditionnels ne couvrent pas entièrement. Les pipelines de retrieval-augmented generation élargissent la surface d’attaque. Ils injectent dynamiquement des données dans le contexte du modèle. Les attaques de Prompt injection manipulent la logique de retrieval ou l’exécution d’outils. Elles accèdent ainsi à des sources non autorisées ou exfiltrent des informations.
À l’échelle, des risques d’intégrité apparaissent aussi. Des données d’entraînement empoisonnées altèrent le comportement du modèle. Des entrées adversariales produisent aussi des outputs trompeurs sans signaux d’échec évidents. Dans certains cas, des attaquants infèrent des données d’entraînement sensibles à partir des réponses du modèle, même lorsque les systèmes semblent fonctionner normalement.
Exigences de gouvernance et de conformité
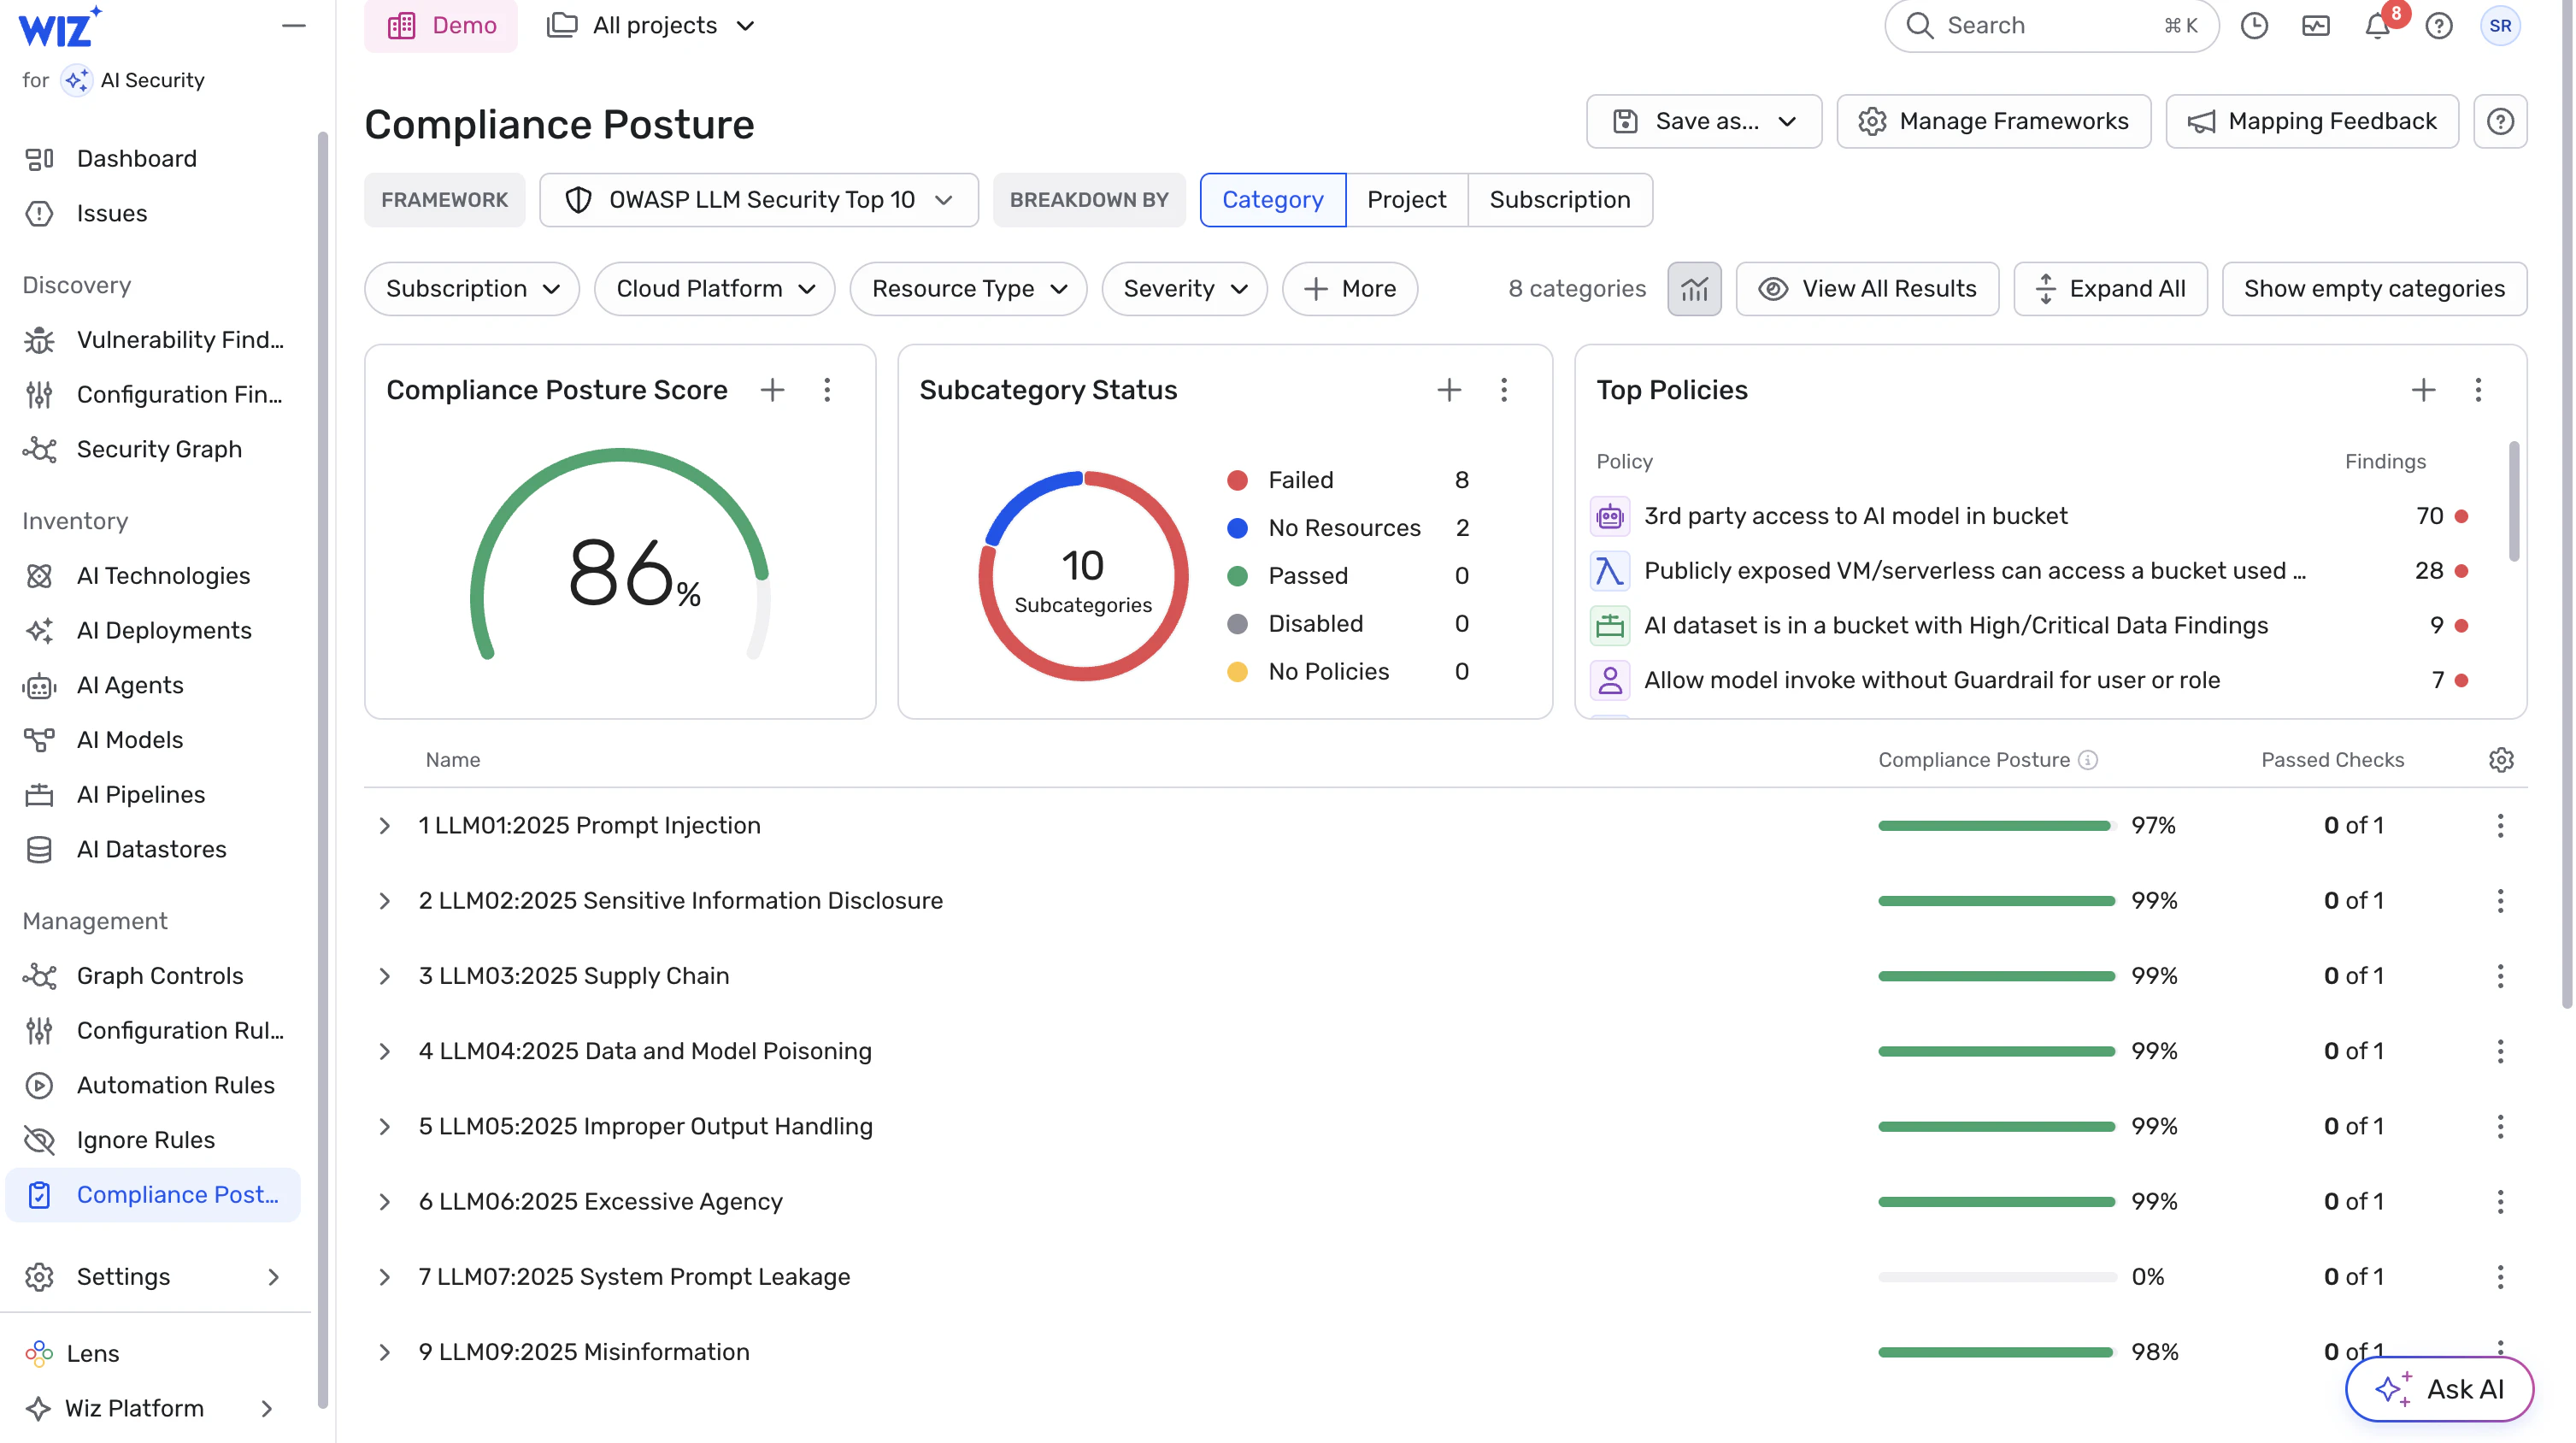
Lorsque les systèmes d’IA influencent les décisions et automatisent les workflows, la gouvernance devient obligatoire. Les organisations définissent qui déploie les modèles et à quelles données ces modèles accèdent. Elles définissent aussi comment les outputs et les décisions sont journalisés et revus. Sans propriété claire ni auditabilité, il devient difficile d’enquêter sur les incidents ou de démontrer la conformité.
Les déploiements d’IA d’entreprise s’alignent aussi sur des cadres réglementaires et de gouvernance. Cela inclut le RGPD, le CCPA, SOC 2, ISO/IEC 27001, ISO/IEC 42001, le NIST AI Risk Management Framework et, dans certaines régions, l’EU AI Act.
L’objectif n’est pas de freiner l’innovation. Il s’agit de garder des systèmes d’IA dignes de confiance et contrôlables à mesure qu’ils s’étendent dans l’organisation.
Défis de mise en œuvre de l’adoption de l’IA en entreprise
Même lorsque la valeur de l’IA d’entreprise est claire, transformer des pilotes en systèmes de production reste difficile. La plupart des défis viennent de l’intégration de l’IA aux environnements existants, plus que des modèles eux-mêmes.
Intégrer l’IA aux systèmes legacy
De nombreuses entreprises s’appuient sur des bases de données et des applications legacy jamais conçues pour l’analytique en temps réel ou les workflows pilotés par l’IA. Connecter des services d’IA modernes à ces systèmes exige une architecture soignée. Il faut aussi une normalisation des données et des contrôles d’accès. Sans ce socle, vos projets d’IA peinent à dépasser l’expérimentation.
Passer du pilote à la production
Les preuves de concept d’IA réussissent souvent en environnements isolés, mais échouent à l’échelle. Les déploiements de production gèrent fiabilité, bascule, monitoring et disponibilité régionale. La recherche sectorielle montre qu’un faible pourcentage d’organisations opère des systèmes d’IA à l’échelle avec succès. L’écart entre expérimentation et maturité entreprise reste large.
Qualité des données, accès et gouvernance
Les systèmes d’IA dépendent de données de haute qualité, mais les entreprises imposent aussi des contrôles d’accès stricts sur les datasets sensibles. Les équipes peinent souvent à équilibrer précision des modèles, minimisation des données et exigences de conformité. Des objectifs contradictoires entre disponibilité des données et sécurité freinent l’adoption et augmentent la friction opérationnelle.
Propriété fragmentée entre les équipes
Les initiatives d’IA d’entreprise traversent l’ingénierie des données, la data science, le développement applicatif et les équipes sécurité. Lorsque la propriété n’est pas claire, des responsabilités comme le réentraînement des modèles, les revues d’accès ou l’incident response passent entre les mailles. Consolider la visibilité et l’application des politiques réduit les transferts entre équipes et raccourcit le temps de remédiation.
Environnements et configurations incohérents
Les systèmes d’IA se comportent souvent différemment entre développement, staging et production à cause du configuration drift ou de politiques d’accès incohérentes. Ces écarts compliquent le diagnostic et introduisent du risque lorsque des changements montent en production sans visibilité complète sur leur impact.
Shadow AI et outillage non contrôlé
Les développeurs adoptent facilement des outils d’IA via des plateformes SaaS sans validation centralisée. Cela accélère l’innovation, mais introduit aussi des pipelines d’IA shadow qui opèrent hors des contrôles de gouvernance et de sécurité établis. Sans visibilité sur ces outils, les organisations n’évaluent pas correctement l’exposition au risque.
Défis de visibilité et de maîtrise des coûts
De nombreuses organisations n’ont pas de vue centralisée de leurs workloads d’IA, modèles et flux de données dans les environnements cloud. Cela complique l’évaluation de la posture de sécurité, l’application de politiques cohérentes ou le contrôle des coûts. Sans observabilité, les dépenses d’infrastructure d’IA croissent plus vite que la valeur business.
Ces défis expliquent pourquoi l’adoption de l’IA d’entreprise stagne souvent après les premiers succès. Les résoudre exige non seulement de meilleurs modèles, mais une propriété plus claire, une visibilité plus forte et des contrôles de sécurité qui évoluent avec les workloads d’IA.
Le guide pratique des responsables sécurité
Obtenez des conseils concrets pour prioriser les actions, aligner les équipes et améliorer votre posture cloud.

Architecture de référence pour une IA d’entreprise sécurisée
Une architecture d’IA d’entreprise sécurisée relie données, modèles et applications avec des frontières de sécurité claires à chaque couche. L’objectif n’est pas de tout verrouiller, mais de vous assurer que l’accès reste intentionnel, observable et auditable tout au long du cycle de vie de l’IA.
Sources de données, ingestion et résidence
Les systèmes d’IA d’entreprise ingèrent des données depuis des plateformes opérationnelles comme le CRM, l’ERP, les logs et des services tiers vers des data lakes ou des lakehouses centralisés. Les données se classent et se taguent à l’ingestion pour que sensibilité et politiques d’accès se propagent en aval.
Pour les environnements multi-région ou réglementés, il importe aussi de définir où les données sont traitées et stockées. Les contrôles de résidence et de souveraineté des données assurent que les pipelines d’entraînement, d’inférence et de retrieval respectent les exigences régionales et les obligations contractuelles.
Feature engineering et feature stores
Les features traitées pour les modèles de machine learning se stockent dans des feature stores centralisés. Cela assure la cohérence entre entraînement et inférence. Les contrôles d’accès restreignent quels modèles et quelles équipes lisent des ensembles de features spécifiques. Le suivi de l’arborescence des données relie les features aux datasets sources pour l’audit et l’investigation d’incidents.
Cette couche aide à empêcher les modèles de consommer à votre insu des données sensibles ou restreintes.
Entraînement, validation et registre des modèles
Les modèles s’entraînent dans des environnements isolés avec des datasets approuvés et des credentials temporaires. Tous les accès aux données sont journalisés, et la connectivité sortante est restreinte pour réduire le blast radius.
Avant la promotion en production, les modèles passent des contrôles de sécurité et d’intégrité. Cela inclut le scan de fuites de données imprévues et la validation des model cards et de la documentation. Des tests adversariaux détectent aussi des portes dérobées ou des comportements non sûrs. Les modèles approuvés s’enregistrent avec des métadonnées. Celles-ci couvrent les données d’entraînement, les métriques de performance et l’usage prévu.
Déploiement, inférence et validation des entrées
Les modèles se déploient vers des endpoints d’inférence managés ou des environnements container. Des pipelines CI/CD contrôlés orchestrent ces déploiements. Les politiques réseau et les API gateways appliquent authentification, autorisation et limitation de débit.
À l’inférence, la validation et l’assainissement des entrées sont critiques. Les entrées utilisateur et les signaux amont s’inspectent pour des tentatives de Prompt injection ou des requêtes malformées. Cette inspection a lieu avant d’atteindre le modèle. Cela réduit le risque que des attaquants manipulent le comportement du modèle ou déclenchent des actions non autorisées.
Pipelines de retrieval-augmented generation
Lorsque la retrieval-augmented generation est utilisée, les bases vectorielles stockent des embeddings issus uniquement de sources approuvées. Les services de retrieval appliquent des contrôles d’accès et valident quels documents se récupèrent pour un utilisateur ou une application donnés.
Le contexte récupéré se sépare clairement de l’entrée utilisateur pour réduire le risque de Prompt injection indirecte. La validation des outputs contrôle les réponses pour des fuites de données sensibles ou des violations de politique avant de renvoyer les résultats aux utilisateurs.
Observabilité, monitoring et tests adversariaux
Logs et métriques de toute la stack d’IA alimentent des systèmes de monitoring centralisés. Les équipes sécurité surveillent les accès aux données inattendus, les schémas d’usage de modèles anormaux ou le comportement d’API suspect.
En plus du monitoring passif, les organisations réalisent un red teaming et des tests adversariaux périodiques des modèles déployés. Ces exercices aident à valider les guardrails et à découvrir des techniques de contournement. Ils assurent aussi que les contrôles restent efficaces à mesure que modèles et données évoluent.
Application des politiques sur toute la stack
L’application des politiques s’appuie sur la gestion des identités et des accès cloud-native, combinée à des contrôles au niveau plateforme. Les politiques de principe du moindre privilège définissent qui accède aux données et entraîne des modèles. Elles définissent aussi qui déploie des endpoints ou invoque l’inférence.
Une application cohérente entre développement, staging et production réduit le configuration drift et assure que la sécurité évolue avec l’adoption de l’IA d’entreprise.
Cette architecture en couches sépare les responsabilités entre les équipes data, ML, plateforme et sécurité. Elle maintient aussi une visibilité partagée. Des frontières claires, une validation continue et des tests réguliers aident les entreprises à déployer l’IA à l’échelle sans perdre le contrôle de la sécurité et de la gouvernance.
Comment Wiz soutient l’adoption sécurisée de l’IA d’entreprise
Wiz aide les organisations à opérationnaliser la sécurité de l’IA en sécurisant les environnements cloud, les identités et les flux de données dont dépendent les systèmes d’IA d’entreprise. Plutôt que de traiter l’IA comme un domaine de sécurité séparé, Wiz l’évalue dans le même contexte code-to-cloud que le reste de l’infrastructure.
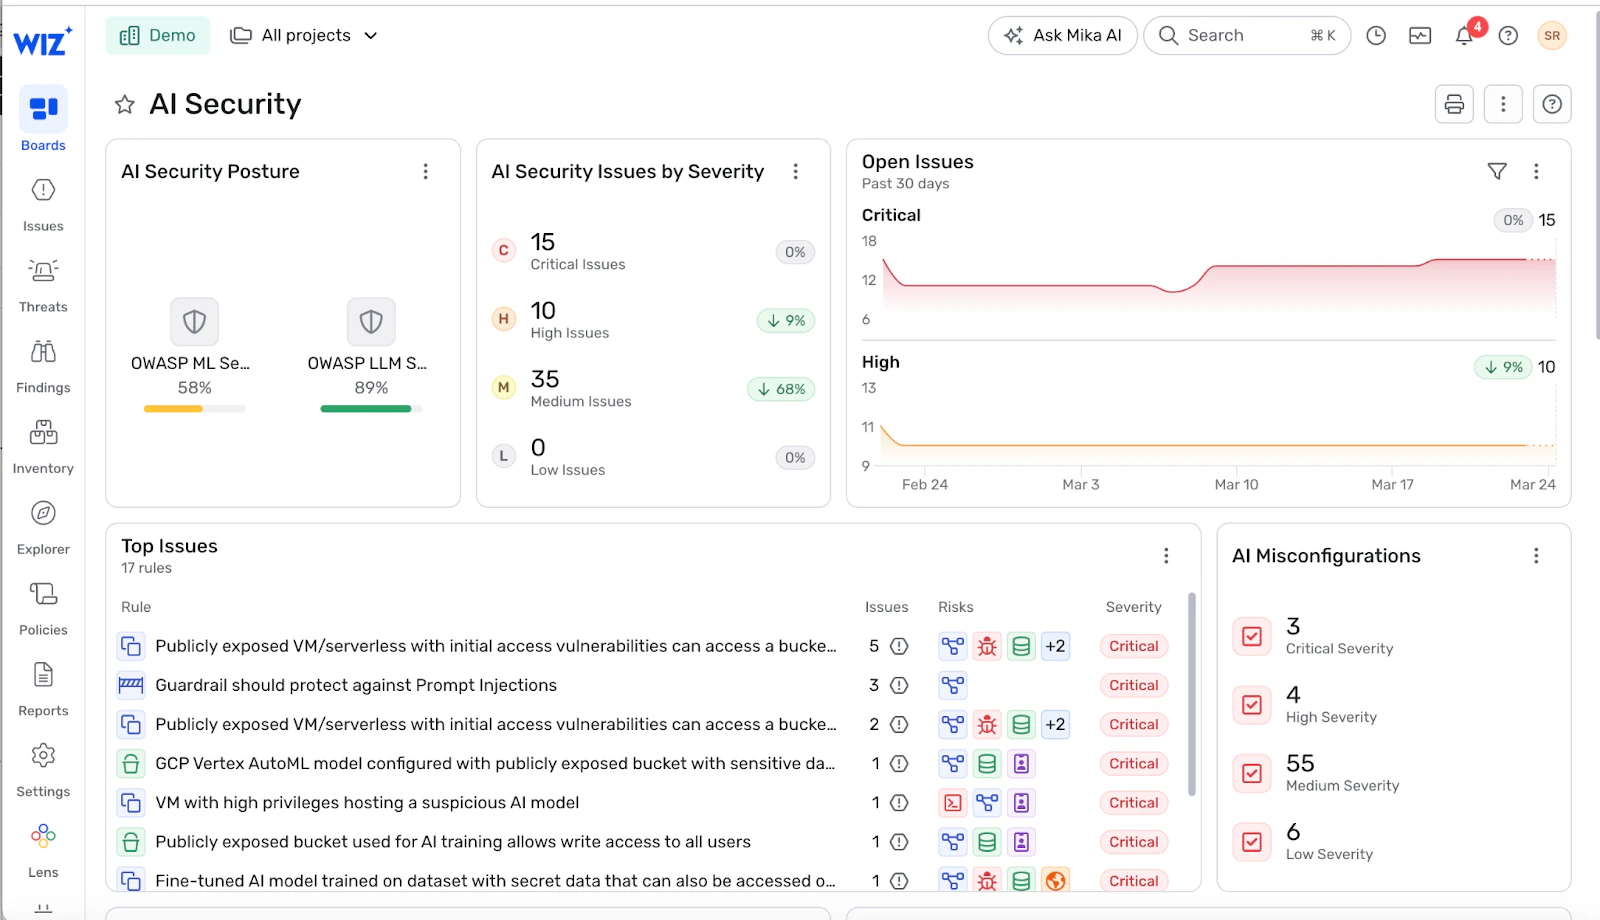
Avec Wiz AI Security Posture Management (AI-SPM), les organisations gagnent en visibilité sur les services cloud liés à l’IA sur AWS, Azure et Google Cloud. Cela couvre les plateformes d’IA managées et les modèles auto-hébergés sur Kubernetes ou des virtual machines. Vous inventoriez où tournent les modèles, les données qu’ils atteignent et les identités de service qui interagissent avec eux.
Wiz corrèle cette posture d’IA avec la configuration cloud, les permissions d’identité et la sensibilité des données. Cette corrélation s’appuie sur le Wiz Security Graph. Au lieu de faire remonter des erreurs de configuration isolées, Wiz met en évidence de vrais chemins d’attaque. Exemple : un endpoint d’inférence exposé publiquement qui atteint des données d’entraînement sensibles via un compte de service trop privilégié. Les équipes priorisent ainsi la remédiation selon l’impact business réel.
Wiz aide aussi les organisations à valider en continu la posture de sécurité à mesure que l’IA d’entreprise évolue. Les changements de data pipelines, de déploiements de modèles ou de politiques d’accès s’évaluent face à l’exposition existante. Vous réduisez ainsi le risque que de nouvelles capacités d’IA introduisent des écarts de sécurité invisibles. Cette approche vous permet de faire évoluer les initiatives d’IA d’entreprise. Vous gardez le contrôle de la sécurité, de la conformité et de la gouvernance. Prêt à voir comment Wiz sécurise l’IA d’entreprise dans votre environnement cloud ? Voir Wiz en action pour explorer l’AI-SPM et la priorisation des risques pilotée par le contexte.
Voyez Wiz en action
Découvrez comment Wiz vous aide à détecter, prioriser et corriger les risques cloud plus rapidement.
